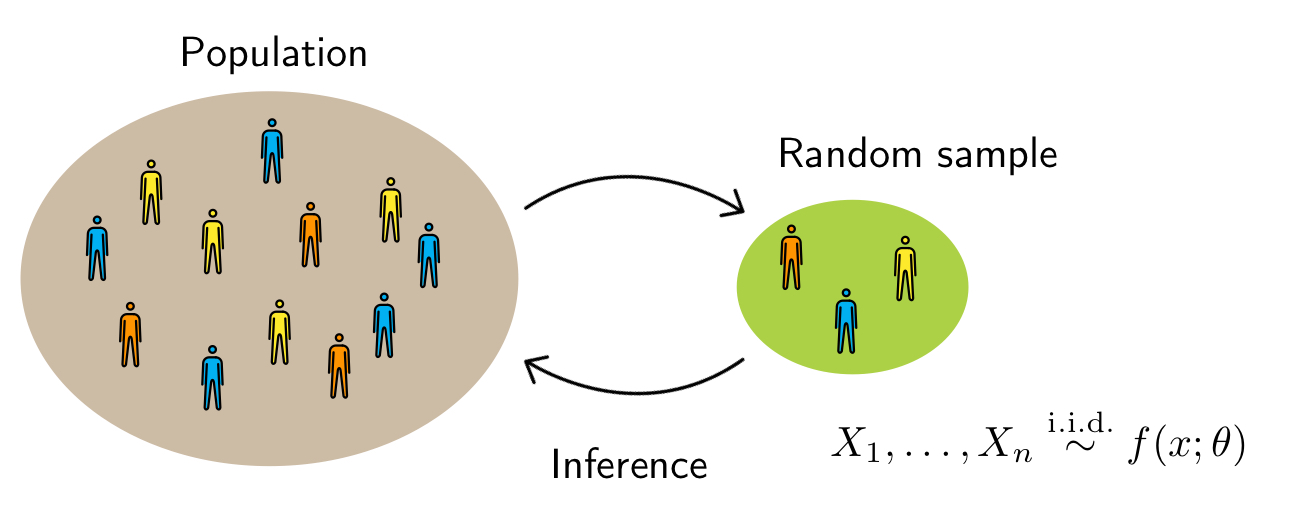
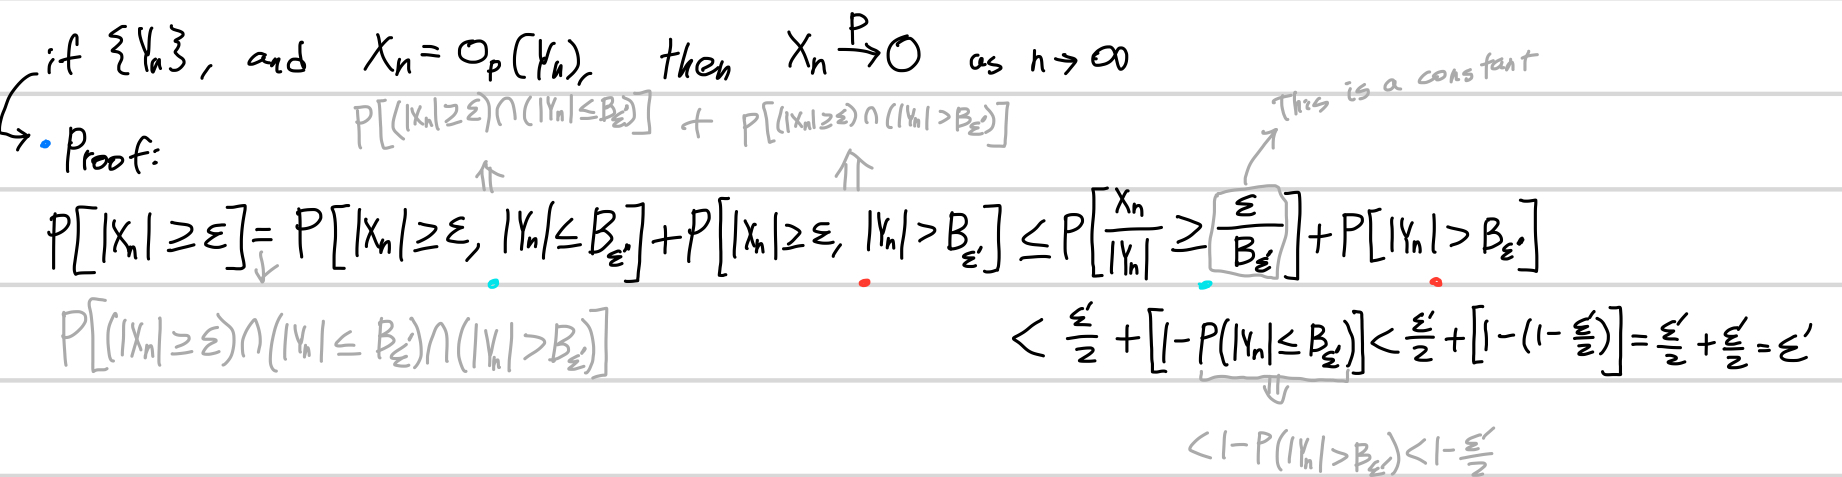왜 저희는 5장을 배워야 하나요? 모집단과 표본이 있다면 저희는 표본을 이용해서 모집단을 추정하는 것이 목적입니다.
정리하자면 모수 θ \theta θ
이 값을 구하기 위해서 모집단 내에 있는 모든 값들을 일일이 비교하는 것은 불가능하기 때문에
표본 (Sample) 에서 뽑아서 표본 X 1 , ⋯ , X n X_1, \cdots, X_n X 1 , ⋯ , X n θ \theta θ
그렇다면 이 표본을 통해서 구체적으로 어떻게 하면 모수를 추정할 수 있을까요? 바로 통계량 (Statistic) 을
만드는 것입니다! 그럼 통계량은 무엇일까요? 모수를 나타내기 위해서 표본들을 이용한 함수라고 생각하시면 됩니다.
T n = u ( X 1 , X 2 , ⋯ , X n ) T_n = u(X_1, X_2, \cdots, X_n) T n = u ( X 1 , X 2 , ⋯ , X n ) 근데 이 통계량 자체가 어떠한 분포를 따라가는지, 즉 어떤 극한 분포 (Limiting Distribution) 을 가지는지를 알아야만 모수에 대한 추정 + 검정 이 가능합니다!
Convergence in Probability Definition 정의 { X n } : Sequence of Random Variables X : Random Variable defined on a sample space We say that X n converges in Probability to X , X n → P X , if, for all ϵ > 0 , lim n → ∞ P [ ∣ X n − X ∣ ≥ ϵ ] = 0 or lim n → ∞ P [ ∣ X n − X ∣ < ϵ ] = 1 \{X_n\} : \text{ Sequence of Random Variables}\\
X : \text{ Random Variable defined on a sample space}\\~\\
\text{We say that } X_n \text{converges in Probability to } X, X_n \xrightarrow{P} X, \text{ if, for all }\epsilon >0,\\
\lim _{n \rightarrow \infty} P\left[\left|X_n-X\right| \geq \epsilon\right]=0 \\
\text{or} \\
\lim _{n \rightarrow \infty} P\left[\left|X_n-X\right|<\epsilon\right]=1 { X n } : Sequence of Random Variables X : Random Variable defined on a sample space We say that X n converges in Probability to X , X n P X , if, for all ϵ > 0 , n → ∞ lim P [ ∣ X n − X ∣ ≥ ϵ ] = 0 or n → ∞ lim P [ ∣ X n − X ∣ < ϵ ] = 1 Example of Convergence in Probability → \rightarrow → Let { X n } \{X_n\} { X n } μ \mu μ σ 2 < ∞ \sigma^2 < \infty σ 2 < ∞
Then the following is True
X ˉ n = 1 n ∑ i = 1 n X i X ˉ n → P μ \bar{X}_n = \frac{1}{n} \sum_{i=1}^{n} X_i \\~\\
\bar{X}_n \xrightarrow{P} \mu X ˉ n = n 1 i = 1 ∑ n X i X ˉ n P μ It is given already that E [ X ˉ n ] = μ , Var [ X ˉ n ] = σ 2 n \operatorname{E}\left[\bar{X}_n \right] = \mu, \quad \operatorname{Var}\left[\bar{X}_n \right] = \frac{\sigma^2}{n} E [ X ˉ n ] = μ , Var [ X ˉ n ] = n σ 2
∀ a > 0 , P [ ∣ X − μ ∣ ≥ a ⋅ σ ] ≤ 1 a 2 \forall a >0, \quad\operatorname{P}\left[|X - \mu| \ge a \cdot \sigma \right] \le \frac{1}{a^2} ∀ a > 0 , P [ ∣ X − μ ∣ ≥ a ⋅ σ ] ≤ a 2 1 we can say the following is True
∀ ϵ > 0 , P [ ∣ X ˉ n − μ ∣ ≥ ϵ ] = P [ ∣ X ˉ n − μ ∣ ≥ ( ϵ n / σ ) ⋅ ( σ / n ) ] = P [ ∣ X ˉ n − μ ∣ ≥ a ⋅ ( σ / n ) ] ≤ 1 a 2 = 1 ( ϵ n σ ) 2 = σ 2 n ⋅ ϵ 2 → n → ∞ 0 Hence, P [ ∣ X ˉ n − μ ∣ ≥ ϵ ] = 0 , X n Converges in Probability to μ ! \forall \epsilon > 0, \quad \operatorname{P}\left[|\bar{X}_n - \mu| \ge \epsilon \right] = \operatorname{P}\left[|\bar{X}_n - \mu| \ge \left(\epsilon \sqrt{n} / \sigma \right) \cdot \left(\sigma / \sqrt{n} \right) \right] \\
= \operatorname{P}\left[|\bar{X}_n - \mu| \ge a \cdot \left(\sigma / \sqrt{n}\right) \right] \le \frac{1}{a^2} = \frac{1}{\left(\frac{\epsilon \sqrt{n}}{\sigma} \right)^2} = \frac{\sigma^2}{n \cdot \epsilon^2} \xrightarrow{n \rightarrow \infty} 0 \\~\\
\text{Hence, } \operatorname{P}\left[|\bar{X}_n - \mu| \ge \epsilon \right] = 0, \quad X_n \text{ Converges in Probability to } \mu ! ∀ ϵ > 0 , P [ ∣ X ˉ n − μ ∣ ≥ ϵ ] = P [ ∣ X ˉ n − μ ∣ ≥ ( ϵ n / σ ) ⋅ ( σ / n ) ] = P [ ∣ X ˉ n − μ ∣ ≥ a ⋅ ( σ / n ) ] ≤ a 2 1 = ( σ ϵ n ) 2 1 = n ⋅ ϵ 2 σ 2 n → ∞ 0 Hence, P [ ∣ X ˉ n − μ ∣ ≥ ϵ ] = 0 , X n Converges in Probability to μ ! X n + Y n → P X + Y X_n + Y_n \xrightarrow{P} X + Y X n + Y n P X + Y Suppose that X n → P X X_n \xrightarrow{P} X X n P X Y n → P Y Y_n \xrightarrow{P} Y Y n P Y
X n + Y n → P X + Y X_n + Y_n \xrightarrow{P} X + Y X n + Y n P X + Y Let ∀ ϵ > 0 be True, Triangle Inequality is as follows ∣ a + b ∣ ≤ ∣ a ∣ + ∣ b ∣ \text{Let } \forall \epsilon >0 \text{ be True, Triangle Inequality is as follows } \\
|a + b| \le |a| + |b| Let ∀ ϵ > 0 be True, Triangle Inequality is as follows ∣ a + b ∣ ≤ ∣ a ∣ + ∣ b ∣ 그럼 다음과 같이 대입을 시켜서 정리가 됩니다.
ϵ ≤ ∣ ( X n + Y n ) − ( X + Y ) ∣ ≤ ∣ X n − X ∣ + ∣ Y n − Y ∣ \epsilon \le |(X_n + Y_n) - (X + Y)| \le |X_n - X| + |Y_n - Y|
ϵ ≤ ∣ ( X n + Y n ) − ( X + Y ) ∣ ≤ ∣ X n − X ∣ + ∣ Y n − Y ∣ Convergence in Probability 정의를 가져오면 다음과 같습니다.
P ( ∣ X n + Y n − X − Y ∣ ≥ ϵ ) ≤ P ( ∣ X n − X ∣ + ∣ Y n − Y ∣ ≥ ϵ ) ≤ P ( ∣ X n − X ∣ ≥ ϵ / 2 ) + P ( ∣ Y n − Y ∣ ≥ ϵ / 2 ) \operatorname{P}\left(|X_n + Y_n - X - Y| \ge \epsilon \right) \le \operatorname{P}\left(|X_n - X| + |Y_n - Y| \ge \epsilon \right) \le \\
\operatorname{P}\left(|X_n - X| \ge \epsilon/2\right) + \operatorname{P}\left(|Y_n - Y| \ge \epsilon/2 \right) P ( ∣ X n + Y n − X − Y ∣ ≥ ϵ ) ≤ P ( ∣ X n − X ∣ + ∣ Y n − Y ∣ ≥ ϵ ) ≤ P ( ∣ X n − X ∣ ≥ ϵ /2 ) + P ( ∣ Y n − Y ∣ ≥ ϵ /2 ) 하지만 저희는 이미 X n → P X X_n \xrightarrow{P} X X n P X Y n → P Y Y_n \xrightarrow{P} Y Y n P Y
∀ ϵ > 0 , P ( ∣ X n − X ∣ ≥ ϵ / 2 ) = 0 and P ( ∣ Y n − Y ∣ ≥ ϵ / 2 ) = 0 \forall \epsilon >0, \quad \operatorname{P}\left(|X_n - X| \ge \epsilon/2\right) = 0 \text{ and } \operatorname{P}\left(|Y_n - Y| \ge \epsilon/2\right) = 0 ∀ ϵ > 0 , P ( ∣ X n − X ∣ ≥ ϵ /2 ) = 0 and P ( ∣ Y n − Y ∣ ≥ ϵ /2 ) = 0 P ( ∣ X n − X ∣ ≥ ϵ / 2 ) + P ( ∣ Y n − Y ∣ ≥ ϵ / 2 ) = 0 ≥ P ( ∣ X n − X ∣ + ∣ Y n − Y ∣ ≥ ϵ ) ≥ P ( ∣ X n + Y n − X − Y ∣ ≥ ϵ ) ∴ X n + Y n → P X + Y \operatorname{P}\left(|X_n - X| \ge \epsilon/2\right) + \operatorname{P}\left(|Y_n - Y| \ge \epsilon/2 \right) = 0 \\
\ge \operatorname{P}\left(|X_n - X| + |Y_n - Y| \ge \epsilon \right) \\
\ge \operatorname{P}\left(|X_n + Y_n - X - Y| \ge \epsilon \right) \\~\\
\therefore X_n + Y_n \xrightarrow{P} X + Y P ( ∣ X n − X ∣ ≥ ϵ /2 ) + P ( ∣ Y n − Y ∣ ≥ ϵ /2 ) = 0 ≥ P ( ∣ X n − X ∣ + ∣ Y n − Y ∣ ≥ ϵ ) ≥ P ( ∣ X n + Y n − X − Y ∣ ≥ ϵ ) ∴ X n + Y n P X + Y a ⋅ X n → P a ⋅ X a \cdot X_n \xrightarrow{P} a \cdot X a ⋅ X n P a ⋅ X Suppose that a a a X n → P X X_n \xrightarrow{P} X X n P X
a ⋅ X n → P a ⋅ X a \cdot X_n \xrightarrow{P} a \cdot X a ⋅ X n P a ⋅ X a = 0 a = 0 a = 0 a ≠ 0 a \ne 0 a = 0
후자의 경우 식에 대입시키면 다음과 같이 Convergence in Probability 의 정의를 활용해서 다음과 같이 식으로 정리가 가능합니다.
P [ ∣ a X n − a X ∣ ≥ ϵ ] = P [ ∣ a ∣ ∣ X n − X ∣ ≥ ϵ ] P\left[\left|a X_n-a X\right| \geq \epsilon\right] = P\left[|a|\left|X_n-X\right| \geq \epsilon\right] P [ ∣ a X n − a X ∣ ≥ ϵ ] = P [ ∣ a ∣ ∣ X n − X ∣ ≥ ϵ ] a a a
P [ ∣ a ∣ ∣ X n − X ∣ ≥ ϵ ] = P [ ∣ X n − X ∣ ≥ ϵ / ∣ a ∣ ] P\left[|a|\left|X_n-X\right| \geq \epsilon\right] = P\left[\left|X_n-X\right| \geq \epsilon /|a|\right] P [ ∣ a ∣ ∣ X n − X ∣ ≥ ϵ ] = P [ ∣ X n − X ∣ ≥ ϵ /∣ a ∣ ] 우측 식은 사실상 X n → P X X_n \xrightarrow{P} X X n P X
Continuous Mapping Theorem Suppose that X n → P a X_n \xrightarrow{P} a X n P a g g g a a a
g ( X n ) → P g ( a ) g(X_n) \xrightarrow{P} g(a) g ( X n ) P g ( a ) Let ∀ ϵ > 0 \forall \epsilon >0 ∀ ϵ > 0 g g g a a a ∀ δ > 0 \forall \delta >0 ∀ δ > 0
if ∣ x − a ∣ < δ , then ∣ g ( x ) − g ( a ) ∣ < ϵ if ∣ g ( x ) − g ( a ) ∣ ≥ ϵ , then ∣ x − a ∣ ≥ δ \text{if } |x-a| < \delta, \quad \text{then } |g(x) - g(a)| < \epsilon \\~\\
\text{if } |g(x) - g(a)| \ge \epsilon, \quad \text{then } |x-a| \ge \delta if ∣ x − a ∣ < δ , then ∣ g ( x ) − g ( a ) ∣ < ϵ if ∣ g ( x ) − g ( a ) ∣ ≥ ϵ , then ∣ x − a ∣ ≥ δ 이것을 저희의 식에 적용시키게 된다면 다음과 같이 나오게 됩니다.
P [ ∣ g ( X n ) − g ( a ) ∣ ≥ ϵ ] ≤ P [ ∣ X n − a ∣ ≥ δ ] = 0 \operatorname{P}\left[|g(X_n) - g(a)| \ge \epsilon \right] \le \operatorname{P}\left[|X_n - a| \ge \delta \right] = 0 P [ ∣ g ( X n ) − g ( a ) ∣ ≥ ϵ ] ≤ P [ ∣ X n − a ∣ ≥ δ ] = 0 우측 식의 경우 X n → P a X_n \xrightarrow{P} a X n P a
여기에서 그럼 Inequality 가 왜 해당이 될까요?
이것이 해당 되는 이유는 어차피 δ \delta δ ϵ \epsilon ϵ
그럼 이것이 사용될 만한 예시들을 보여드리겠습니다.
추가적으로 이것보다 더 어려운 강의들에서는 다음이 만족 된다는 것을 증명하며 해당 강의에서는 그저 이것이 해당이 되구나~ 로만 이해해도 무방합니다. (위와는 다르게 이번에는 확률변수입니다)
If X n → P X , and g is a continuous function, then the following is True g ( X n ) → P g ( X ) \text{If } X_n \xrightarrow{P} X, \\\text{ and } g \text{ is a continuous function, then the following is True} \\
g(X_n) \xrightarrow{P} g(X) If X n P X , and g is a continuous function, then the following is True g ( X n ) P g ( X ) X n ⋅ Y n → P X Y X_n \cdot Y_n \xrightarrow{P} XY X n ⋅ Y n P X Y 이전의 증명들을 이용하면 다음과 같이 식을 사용할 수 있습니다.
X n ⋅ Y n = 1 2 X n 2 + 1 2 Y n 2 − 1 2 ( X n − Y n ) 2 X_n \cdot Y_n = \frac{1}{2} X_n^2 + \frac{1}{2}Y_n^2 - \frac{1}{2} \left(X_n - Y_n \right)^2 X n ⋅ Y n = 2 1 X n 2 + 2 1 Y n 2 − 2 1 ( X n − Y n ) 2 이거는 그저 xy 를 (x-y)^2 와 연관 지어서 푼 것이며, 이것이 가능한 이유는 다음과 같습니다.
x y = 1 2 x 2 + 1 2 y 2 − 1 2 ( x − y ) 2 = 1 2 x 2 + 1 2 y 2 − 1 2 ( x 2 − 2 x y + y 2 ) = 1 2 x 2 + 1 2 y 2 − 1 2 x 2 + x y − 1 2 y 2 = 1 2 x 2 − 1 2 x 2 + 1 2 y 2 − 1 2 y 2 + x y = x y xy = \frac{1}{2}x^2 + \frac{1}{2}y^2 - \frac{1}{2}(x - y)^2 =
\frac{1}{2}x^2 + \frac{1}{2}y^2 - \frac{1}{2}\left(x^2 - 2xy + y^2 \right) \\
= \frac{1}{2}x^2 + \frac{1}{2}y^2 - \frac{1}{2}x^2 + xy - \frac{1}{2} y^2 = \frac{1}{2}x^2 -\frac{1}{2}x^2 +\frac{1}{2}y^2 -\frac{1}{2}y^2 + xy = xy x y = 2 1 x 2 + 2 1 y 2 − 2 1 ( x − y ) 2 = 2 1 x 2 + 2 1 y 2 − 2 1 ( x 2 − 2 x y + y 2 ) = 2 1 x 2 + 2 1 y 2 − 2 1 x 2 + x y − 2 1 y 2 = 2 1 x 2 − 2 1 x 2 + 2 1 y 2 − 2 1 y 2 + x y = x y 그럼 기존 식을 다시 살피겠습니다. 해당 식에서 상수를 빼서 유심히 살피면 X n 2 , Y n 2 , ( X n − Y n ) 2 X_n^2, Y_n^2, (X_n - Y_n)^2 X n 2 , Y n 2 , ( X n − Y n ) 2
X n 2 X_n^2 X n 2 Y n 2 Y_n^2 Y n 2
g g g g ( x ) = x 2 g(x) = x^2 g ( x ) = x 2
( X n − Y n ) 2 \left(X_n - Y_n \right)^2 ( X n − Y n ) 2
우선은 X n − Y n → P X − Y X_n - Y_n \xrightarrow{P} X - Y X n − Y n P X − Y Z n → P Z Z_n \xrightarrow{P} Z Z n P Z
g g g g ( x ) = x 2 g(x) = x^2 g ( x ) = x 2
g ( Z n ) → P g ( Z ) , ↔ ( Z n ) 2 → P ( Z ) 2 , ↔ ( X n − Y n ) 2 → P ( X − Y ) 2 g(Z_n) \xrightarrow{P} g(Z), \leftrightarrow \left(Z_n\right)^2 \xrightarrow{P} \left(Z \right)^2, \leftrightarrow \left(X_n - Y_n \right)^2 \xrightarrow{P} \left(X - Y \right)^2 g ( Z n ) P g ( Z ) , ↔ ( Z n ) 2 P ( Z ) 2 , ↔ ( X n − Y n ) 2 P ( X − Y ) 2
X n ⋅ Y n = 1 2 X n 2 + 1 2 Y n 2 − 1 2 ( X n − Y n ) 2 → P 1 2 X 2 + 1 2 Y 2 − 1 2 ( X − Y ) 2 = X ⋅ Y X_n \cdot Y_n = \frac{1}{2} X_n^2 + \frac{1}{2}Y_n^2 - \frac{1}{2} \left(X_n - Y_n \right)^2 \xrightarrow{P} \frac{1}{2}X^2 + \frac{1}{2}Y^2 - \frac{1}{2}\left(X - Y\right)^2 = X \cdot Y X n ⋅ Y n = 2 1 X n 2 + 2 1 Y n 2 − 2 1 ( X n − Y n ) 2 P 2 1 X 2 + 2 1 Y 2 − 2 1 ( X − Y ) 2 = X ⋅ Y 중간의 Convergence in Probability 가 성립이 되기에 증명을 마치겠습니다.
Consistency 우선은 Unbiasedness 에 대해서 복습을 하겠습니다.
Statistic, 통계량, T T T E [ T ] = θ \operatorname{E}[T] = \theta E [ T ] = θ
Statistic, 통계량, T T T T n → P θ T_n \xrightarrow{P} \theta T n P θ
이것이 의미하는 것은 표본 개수가 오르면 오를수록 모수랑 같아진다는 의미를 가집니다.
Sample Variance S n 2 = 1 n − 1 ∑ i = 1 n ( X i − X ˉ n ) 2 = n n − 1 ( ∑ i = 1 n X i 2 − X ˉ n 2 ) → P 1 ⋅ [ E ( X 1 2 ) − μ 2 ] = Var ( X 1 ) = σ 2 S^2_n = \frac{1}{n-1} \sum_{i=1}^{n} \left(X_i - \bar{X}_n \right)^2 = \frac{n}{n-1} \left(\sum_{i=1}^{n}X_i^2 - \bar{X}_n^2 \right) \\ \xrightarrow{P} 1 \cdot \left[\operatorname{E}\left(X_1^2 \right) - \mu^2 \right] = \operatorname{Var}(X_1) = \sigma^2 S n 2 = n − 1 1 i = 1 ∑ n ( X i − X ˉ n ) 2 = n − 1 n ( i = 1 ∑ n X i 2 − X ˉ n 2 ) P 1 ⋅ [ E ( X 1 2 ) − μ 2 ] = Var ( X 1 ) = σ 2 Hence Sample Variance is a Consistent Estimator
Convergence in Distribution Definition 정의 { X n } : Sequence of Random Variables X : Random Variable defined on a sample space F X n : cdf of X n F X : cdf of X C ( F X ) : The set of all points where F X is continuous We say that X n converges in Distribution to X , X n → D X , if, for all x ∈ C ( F X ) , lim n → ∞ F X n ( x ) = F X ( x ) \{X_n\} : \text{ Sequence of Random Variables}\\
X : \text{ Random Variable defined on a sample space}\\
F_{X_n} : \text{ cdf of } X_n\\
F_{X} : \text{ cdf of } X\\
C(F_X) : \text{ The set of all points where } F_X \text{ is continuous}
\\~\\
\text{We say that } X_n \text{converges in Distribution to } X, X_n \xrightarrow{D} X, \\ \text{ if, for all } x \in C(F_X),\\~\\
\lim_{n \rightarrow \infty} F_{X_n}(x) = F_X(x) { X n } : Sequence of Random Variables X : Random Variable defined on a sample space F X n : cdf of X n F X : cdf of X C ( F X ) : The set of all points where F X is continuous We say that X n converges in Distribution to X , X n D X , if, for all x ∈ C ( F X ) , n → ∞ lim F X n ( x ) = F X ( x ) 사실상 다른게 아니라 X n X_n X n X X X
그리고 이게 의미하는게 무엇인지 헷갈릴 수도 있는데, Convergence in Distribution 이
X n → D X X_n \xrightarrow{D} X X n D X X X X
X n → D N ( 0 , 1 ) X_n \xrightarrow{D} \operatorname{N}(0, 1) X n D N ( 0 , 1 ) 여기에서 저희는 표현을 할 때에 X X X { X n } \{X_n\} { X n }
Convergence in Probability and Distribution If X n → P X X_n \xrightarrow{P} X X n P X X n → D X X_n \xrightarrow{D} X X n D X
즉 Convergence in Probability 하다면 Convergence in Distribution 도 해당이 된다는 뜻입니다.
이것은 if 관계를 가지며, 반대는 항상 성립이 되지는 않기 때문에 if and only if 관계가 성립이 되지는 않습니다.
Upper Bound 과 Lower Bound 를 다음과 같이 구할 수 있습니다.
∀ ϵ > 0 , F X n ( x ) = P [ X n ≤ x ] = P [ { X n ≤ x } ∩ { ∣ X n − X ∣ < ϵ } ] + P [ { X n ≤ x } ∩ { ∣ X n − X ∣ ≥ ϵ } ] ≤ P [ X ≤ x + ϵ ] + P [ ∣ X n − X ∣ ≥ ϵ ] \forall \epsilon >0, \quad F_{X_n}(x) = \operatorname{P}\left[X_n \le x \right] \\
= \operatorname{P}\left[\{X_n \le x\} \cap \{|X_n - X| < \epsilon\}\right]+ \operatorname{P}\left[\{X_n \le x\} \cap \{|X_n - X| \ge \epsilon\}
\right] \\
\le \operatorname{P}\left[X \le x + \epsilon \right] + \operatorname{P}\left[|X_n - X| \ge \epsilon \right] ∀ ϵ > 0 , F X n ( x ) = P [ X n ≤ x ] = P [ { X n ≤ x } ∩ { ∣ X n − X ∣ < ϵ } ] + P [ { X n ≤ x } ∩ { ∣ X n − X ∣ ≥ ϵ } ] ≤ P [ X ≤ x + ϵ ] + P [ ∣ X n − X ∣ ≥ ϵ ] Convergence in Probability 가 해당이 되기에 마지막 식의 오른쪽 부분은 0 으로 수렴하며 좌측 부분만 이용해서 Upper Bound 을 다음과 같이 정리할 수 있습니다.
l i m ‾ n → ∞ F X n ( x ) = P [ X n ≤ x ] ≤ P [ X ≤ x + ϵ ] = F X ( x + ϵ ) l i m ‾ n → ∞ F X n ( x ) ≤ F X ( x + ϵ ) \varlimsup_{n \rightarrow \infty} F_{X_n}(x) = \operatorname{P}\left[X_n \le x \right] \le \operatorname{P}\left[X \le x + \epsilon \right] = F_X(x + \epsilon) \\
\varlimsup_{n \rightarrow \infty}F_{X_n}(x) \le F_X(x+\epsilon) n → ∞ lim F X n ( x ) = P [ X n ≤ x ] ≤ P [ X ≤ x + ϵ ] = F X ( x + ϵ ) n → ∞ lim F X n ( x ) ≤ F X ( x + ϵ ) Lower Bound 는 똑같이 위에서 했던거랑 하면 되며, 이번에는 반대로 다음과 같이 구하겠습니다.
1 − F X n ( x ) = P [ X n > x ] = P [ { X n > x } ∩ { ∣ X n − X ∣ < ϵ } ] + P [ { X n > x } ∩ { ∣ X n − X ∣ ≥ ϵ } ] ≥ P [ X ≥ x − ϵ ] + P [ ∣ X n − X ∣ ≥ ϵ ] = P [ X ≥ x − ϵ ] 1- F_{X_n}(x) = \operatorname{P}\left[X_n > x\right] \\
= \operatorname{P}\left[\{X_n > x\} \cap \{|X_n - X| < \epsilon\}\right]+ \operatorname{P}\left[\{X_n > x\} \cap \{|X_n - X| \ge \epsilon\}
\right] \\
\ge \operatorname{P}\left[X \ge x - \epsilon \right] + \operatorname{P}\left[|X_n - X| \ge \epsilon \right] = \operatorname{P}\left[X \ge x-\epsilon \right] 1 − F X n ( x ) = P [ X n > x ] = P [ { X n > x } ∩ { ∣ X n − X ∣ < ϵ } ] + P [ { X n > x } ∩ { ∣ X n − X ∣ ≥ ϵ } ] ≥ P [ X ≥ x − ϵ ] + P [ ∣ X n − X ∣ ≥ ϵ ] = P [ X ≥ x − ϵ ] 위의 식을 정리하면 Limit 에 대한 Lower Bound 도 구할 수가 있습니다.
l i m ‾ n → ∞ F X n ( x ) ≥ F X ( x − ϵ ) \varliminf_{n \rightarrow \infty} F_{X_n}(x) \geq F_X(x-\epsilon) n → ∞ lim F X n ( x ) ≥ F X ( x − ϵ ) 두 식을 합치면 다음과 같이 Sandwich Theorem 과 ϵ \epsilon ϵ
F X ( x − ϵ ) ≤ l i m ‾ n → ∞ F X n ( x ) ≤ l i m ‾ n → ∞ F X n ( x ) ≤ F X ( x + ϵ ) X n → D X F_X(x-\epsilon) \leq \varliminf_{n \rightarrow \infty} F_{X_n}(x) \leq \varlimsup_{n \rightarrow \infty} F_{X_n}(x) \leq F_X(x+\epsilon) \\~\\
X_n \xrightarrow{D} X F X ( x − ϵ ) ≤ n → ∞ lim F X n ( x ) ≤ n → ∞ lim F X n ( x ) ≤ F X ( x + ϵ ) X n D X X n → D b X_n \xrightarrow{D} b X n D b If X n → D b X_n \xrightarrow{D} b X n D b b b b X n → P b X_n \xrightarrow{P} b X n P b
Let ∀ ϵ > 0 \forall \epsilon > 0 ∀ ϵ > 0
lim n → ∞ P [ ∣ X n − b ∣ ≤ ϵ ] = lim n → ∞ F X n ( b + ϵ ) − lim n → ∞ F X n ( b − ϵ ) = 1 − 0 = 1 \lim_{n \rightarrow \infty}\operatorname{P}\left[|X_n - b| \le \epsilon \right] = \lim_{n\rightarrow \infty} F_{X_n}(b+\epsilon) - \lim_{n \rightarrow \infty} F_{X_n}(b-\epsilon) = 1 - 0 = 1 n → ∞ lim P [ ∣ X n − b ∣ ≤ ϵ ] = n → ∞ lim F X n ( b + ϵ ) − n → ∞ lim F X n ( b − ϵ ) = 1 − 0 = 1 설명을 해보겠습니다. Convergence in Distribution 이기 때문에 다음과 같은 식이 성립이 됩니다.
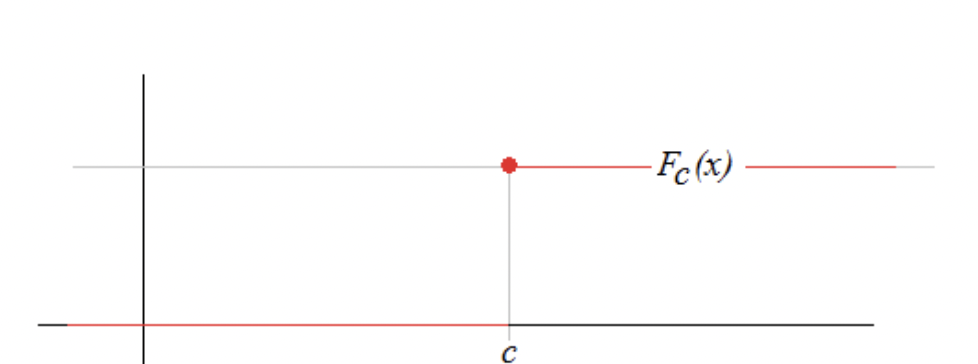
lim n → ∞ F X n ( t ) = F b ( t ) \lim _{n \rightarrow \infty} F_{X_n}(t)=F_b(t) n → ∞ lim F X n ( t ) = F b ( t ) 만약에 t < b t < b t < b F b ( t ) = 0 F_b(t) = 0 F b ( t ) = 0 F b ( t ) = 1 F_b(t) = 1 F b ( t ) = 1 b b b
그러면 t < b t <b t < b t ≥ b t\ge b t ≥ b b b b
X n → D X , Y n → P 0 , X n + Y n → D X X_n \xrightarrow{D} X,\; Y_n \xrightarrow{P} 0, \;X_n + Y_n \xrightarrow{D} X X n D X , Y n P 0 , X n + Y n D X 위의 것이랑 사실상 똑같으며, 이것은 Slutsky’s Theorem 의 기초가 된다.
Continuous Mapping Theorem X n → D X X_n \xrightarrow{D} X X n D X g g g X X X
g ( X n ) → D g ( X ) g(X_n) \xrightarrow{D} g(X) g ( X n ) D g ( X ) 이것을 활용시켜서 표준정규분포의 제곱이 카이제곱분포를 따라간다는 것을 구체적으로 알 수가 있습니다.
Slutsky’s Theorem 아마 이 절에서 가장 활용하기 어려운 정리인 것 같습니다.
If X n → D X , A n → P a , and B n → P b , then A n + B n X n → D a + b X \text{If } X_n \xrightarrow{D} X, A_n \xrightarrow{P} a \text {, and } B_n \xrightarrow{P} b \text {, then } \\~\\
A_n+B_n X_n \xrightarrow{D} a+b X If X n D X , A n P a , and B n P b , then A n + B n X n D a + b X 증명은 따로 알 필요 없으며, 이것을 통해서 Convergence in Distribution 을 증명할 수 있다는 것만 알면 됩니다. 이것을 수리통계학 1 에서도 잠시 나오지만 CLT 와 활용해서 극한분포를 알아내는 것이 가능합니다.
Bounded in Probability Sequence { X n } \{X_n\} { X n } ∀ ϵ > 0 \forall \epsilon >0 ∀ ϵ > 0 B ϵ > 0 B_{\epsilon} >0 B ϵ > 0 N ϵ N_{\epsilon} N ϵ
n ≥ N ϵ → P [ ∣ X n ∣ ≤ B ϵ ] ≥ 1 − ϵ n \ge N_\epsilon \rightarrow \operatorname{P}\left[|X_n| \le B_\epsilon \right] \ge 1 - \epsilon n ≥ N ϵ → P [ ∣ X n ∣ ≤ B ϵ ] ≥ 1 − ϵ 이것은 Convergence 랑은 비슷한 개념이지만 엄밀히 따지자면 다릅니다. 이것의 의미는 n n n
Convergence 의 경우 1개의 값으로 수렴한다는 뜻을 가지지만, Bounded in Probability 는 1개의 값으로 수렴한다는 의미를 가지지는 않고 있습니다.
추가적으로 만약에 해당 수열이 Random Variables, 확률변수들이면 다음이 성립이 됩니다.
If X n → D X , then { X n } is bounded in probability \text{If } X_n \xrightarrow{D} X, \text{ then } \{X_n\} \text{ is bounded in probability} If X n D X , then { X n } is bounded in probability X n Y n → P 0 X_n Y_n \xrightarrow{P} 0 X n Y n P 0 { X n } \{X_n\} { X n }
{ Y n } \{Y_n\} { Y n }
X n Y n → P 0 X_n Y_n \xrightarrow{P} 0 X n Y n P 0
lim n → ∞ P ( ∣ X n ⋅ Y n − 0 ∣ ≥ ϵ ) \lim_{n \rightarrow \infty}\operatorname{P}(|X_n \cdot Y_n - 0| \ge \epsilon) n → ∞ lim P ( ∣ X n ⋅ Y n − 0∣ ≥ ϵ ) Bounded in Probability 하다는 것은 다음을 만족하는 B ϵ > 0 B_\epsilon >0 B ϵ > 0 N ϵ N_\epsilon N ϵ
n ≥ N ϵ → P [ ∣ X n ∣ ≤ B ϵ ] ≥ 1 − ϵ ↔ P [ ∣ X n ∣ > B ϵ ] ≤ ϵ n \ge N_\epsilon \rightarrow \operatorname{P}\left[|X_n| \le B_\epsilon \right] \ge 1 - \epsilon \\~\\
\leftrightarrow
\operatorname{P}\left[|X_n| > B_\epsilon \right] \le \epsilon n ≥ N ϵ → P [ ∣ X n ∣ ≤ B ϵ ] ≥ 1 − ϵ ↔ P [ ∣ X n ∣ > B ϵ ] ≤ ϵ Convergence in Probability to 0 하다는 것은 다음이 해당이 됩니다.
lim n → ∞ P ( ∣ Y n − 0 ∣ ≥ ϵ ) = 0 \lim_{n \rightarrow \infty}\operatorname{P}(|Y_n - 0| \ge \epsilon) = 0 n → ∞ lim P ( ∣ Y n − 0∣ ≥ ϵ ) = 0 위의 2가지 식을 응용하면 다음과 같은 결론을 지을 수가 있습니다.
l i m ‾ n → ∞ P ( ∣ X n ⋅ Y n − 0 ∣ ≥ ϵ ) = l i m ‾ n → ∞ P ( ∣ X n ⋅ Y n ∣ ≥ ϵ ) = l i m ‾ n → ∞ P ( { ∣ X n ⋅ Y n ∣ ≥ ϵ } ∩ { ∣ X n ∣ ≤ B ϵ } ) + l i m ‾ n → ∞ P ( { ∣ X n ⋅ Y n ∣ ≥ ϵ } ∩ { ∣ X n ∣ > B ϵ } ) ≤ l i m ‾ n → ∞ P ( ∣ Y n ∣ ≥ ϵ / B ϵ ) + ϵ = ϵ \varlimsup_{n \rightarrow \infty}\operatorname{P}(|X_n \cdot Y_n - 0| \ge \epsilon) = \varlimsup_{n \rightarrow \infty}\operatorname{P}(|X_n \cdot Y_n| \ge \epsilon) \\
= \varlimsup_{n \rightarrow \infty}\operatorname{P}(\{|X_n \cdot Y_n| \ge \epsilon\} \cap \{|X_n| \le B_\epsilon\}) + \\
\varlimsup_{n \rightarrow \infty}\operatorname{P}(\{|X_n \cdot Y_n| \ge \epsilon\} \cap \{|X_n| > B_\epsilon\}) \\
\le \varlimsup_{n \rightarrow \infty}\operatorname{P}(|Y_n| \ge \epsilon / B_\epsilon) + \epsilon = \epsilon n → ∞ lim P ( ∣ X n ⋅ Y n − 0∣ ≥ ϵ ) = n → ∞ lim P ( ∣ X n ⋅ Y n ∣ ≥ ϵ ) = n → ∞ lim P ({ ∣ X n ⋅ Y n ∣ ≥ ϵ } ∩ { ∣ X n ∣ ≤ B ϵ }) + n → ∞ lim P ({ ∣ X n ⋅ Y n ∣ ≥ ϵ } ∩ { ∣ X n ∣ > B ϵ }) ≤ n → ∞ lim P ( ∣ Y n ∣ ≥ ϵ / B ϵ ) + ϵ = ϵ { ∣ X n ⋅ Y n ∣ ≥ ϵ } ∩ { ∣ X n ∣ ≤ B ϵ } \{|X_n \cdot Y_n| \ge \epsilon\} \cap \{|X_n| \le B_\epsilon\} { ∣ X n ⋅ Y n ∣ ≥ ϵ } ∩ { ∣ X n ∣ ≤ B ϵ } Y n Y_n Y n ϵ \epsilon ϵ ∣ Y n ∣ ≥ ϵ / ∣ X N ∣ ≥ ϵ / B ϵ |Y_n| \ge \epsilon / |X_N| \ge \epsilon / B_\epsilon ∣ Y n ∣ ≥ ϵ /∣ X N ∣ ≥ ϵ / B ϵ
l i m ‾ n → ∞ P ( { ∣ X n ⋅ Y n ∣ ≥ ϵ } ∩ { ∣ X n ∣ ≤ B ϵ } ) ≤ l i m ‾ n → ∞ P ( ∣ Y n ∣ ≥ ϵ / B ϵ ) \varlimsup_{n \rightarrow \infty}\operatorname{P}(\{|X_n \cdot Y_n| \ge \epsilon\} \cap \{|X_n| \le B_\epsilon\}) \le \varlimsup_{n \rightarrow \infty}\operatorname{P}(|Y_n| \ge \epsilon / B_\epsilon) n → ∞ lim P ({ ∣ X n ⋅ Y n ∣ ≥ ϵ } ∩ { ∣ X n ∣ ≤ B ϵ }) ≤ n → ∞ lim P ( ∣ Y n ∣ ≥ ϵ / B ϵ ) { ∣ X n ⋅ Y n ∣ ≥ ϵ } ∩ { ∣ X n ∣ > B ϵ } \{|X_n \cdot Y_n| \ge \epsilon\} \cap \{|X_n| > B_\epsilon\} { ∣ X n ⋅ Y n ∣ ≥ ϵ } ∩ { ∣ X n ∣ > B ϵ }
l i m ‾ n → ∞ P ( { ∣ X n ⋅ Y n ∣ ≥ ϵ } ∩ { ∣ X n ∣ > B ϵ } ) = l i m ‾ n → ∞ P ( ∣ X n ∣ > B ϵ ) = ϵ \varlimsup_{n \rightarrow \infty}\operatorname{P}(\{|X_n \cdot Y_n| \ge \epsilon\} \cap \{|X_n| > B_\epsilon\}) = \varlimsup_{n \rightarrow \infty}\operatorname{P}(|X_n| > B_\epsilon) = \epsilon n → ∞ lim P ({ ∣ X n ⋅ Y n ∣ ≥ ϵ } ∩ { ∣ X n ∣ > B ϵ }) = n → ∞ lim P ( ∣ X n ∣ > B ϵ ) = ϵ Delta Method g ( y ) = g ( x ) + g ′ ( x ) ( y − x ) + o ( ∣ y − x ∣ ) a = o ( b ) , iff a b → 0 , as b → 0 Y n = O p ( X n ) iff Y n X n is bounded in probability as n → ∞ g(y) = g(x) + g^{\prime}(x) (y-x) + o(|y-x|) \\
a = o(b), \text{ iff } \frac{a}{b} \rightarrow 0, \text{ as } b \rightarrow 0 \\
Y_n = O_p(X_n) \text{ iff } \frac{Y_n}{X_n} \text{ is bounded in probability as } n \rightarrow \infty g ( y ) = g ( x ) + g ′ ( x ) ( y − x ) + o ( ∣ y − x ∣ ) a = o ( b ) , iff b a → 0 , as b → 0 Y n = O p ( X n ) iff X n Y n is bounded in probability as n → ∞ 첫번째 식이 의미하는 것은 다른게 아닌 Taylor-Series Approximation 입니다.
두번째랑 세번째 식은 o-notation 들이 뭔지에 대한 설명이며, 간단히 말하자면 0 으로 수렴하는 에러 값들이라고 생각해도 됩니다.
이것을 이용해서 다음과 같은 정리를 사용할 수 있습니다.
{ Y n } : Bounded in Probability X n = o p ( Y n ) Then, X n → P 0 , as n → ∞ \{Y_n\} : \text{Bounded in Probability} \\
X_n = o_p(Y_n) \\
\text{Then, } X_n \xrightarrow{P} 0, \text{ as } n \rightarrow \infty { Y n } : Bounded in Probability X n = o p ( Y n ) Then, X n P 0 , as n → ∞ P [ ∣ X n ∣ ≥ ϵ ] = P [ { ∣ X n ∣ ≥ ϵ } ∩ { ∣ Y n ∣ ≤ B ϵ ′ } ] + P [ { ∣ X n ∣ ≥ ϵ } ∩ { ∣ Y n ∣ > B ϵ ′ } ] ≤ P [ X n ∣ Y n ∣ ≥ ϵ B ϵ ′ ] + P [ ∣ Y n ∣ > B ϵ ′ ] < ϵ ′ 2 + [ 1 − P ( ∣ Y n ∣ ≤ B ϵ ′ ) ] < ϵ ′ 2 + [ 1 − ( 1 − ϵ ′ 2 ) ] = ϵ ′ 2 + ϵ ′ 2 = ϵ ′ \operatorname{P}[|X_n| \ge \epsilon] = \operatorname{P}[\{|X_n| \ge \epsilon\} \cap \{|Y_n| \le B_{\epsilon^\prime}\}] \\
+ \operatorname{P}[\{|X_n| \ge \epsilon\} \cap \{|Y_n| > B_{\epsilon{^\prime}}\}]\\
\le \operatorname{P}\left[\frac{X_n}{|Y_n|} \ge \frac{\epsilon}{B_{\epsilon^{\prime}}} \right]
+ \operatorname{P}\left[|Y_n| > B_{\epsilon^{\prime}} \right] \\
< \frac{\epsilon^\prime}{2} + \left[1 - \operatorname{P}(|Y_n| \le B_{\epsilon^\prime}) \right] \\
< \frac{\epsilon^\prime}{2} + \left[1 - (1 - \frac{\epsilon^\prime}{2}) \right] = \frac{\epsilon^\prime}{2} + \frac{\epsilon^\prime}{2}
= \epsilon^\prime P [ ∣ X n ∣ ≥ ϵ ] = P [{ ∣ X n ∣ ≥ ϵ } ∩ { ∣ Y n ∣ ≤ B ϵ ′ }] + P [{ ∣ X n ∣ ≥ ϵ } ∩ { ∣ Y n ∣ > B ϵ ′ }] ≤ P [ ∣ Y n ∣ X n ≥ B ϵ ′ ϵ ] + P [ ∣ Y n ∣ > B ϵ ′ ] < 2 ϵ ′ + [ 1 − P ( ∣ Y n ∣ ≤ B ϵ ′ ) ] < 2 ϵ ′ + [ 1 − ( 1 − 2 ϵ ′ ) ] = 2 ϵ ′ + 2 ϵ ′ = ϵ ′ Delta Method for Normal Distributions Let { X n } \{X_n\} { X n }
n ( X n − θ ) → D N ( 0 , σ 2 ) \sqrt{n}\left(X_n-\theta\right) \xrightarrow{D} N\left(0, \sigma^2\right) n ( X n − θ ) D N ( 0 , σ 2 ) If the function g g g θ \theta θ g ′ ( θ ) ≠ 0 g^\prime(\theta) \ne 0 g ′ ( θ ) = 0
n ( g ( X n ) − g ( θ ) ) → D N ( 0 , σ 2 ( g ′ ( θ ) ) 2 ) \sqrt{n}\left(g\left(X_n\right)-g(\theta)\right) \xrightarrow{D} N\left(0, \sigma^2\left(g^{\prime}(\theta)\right)^2\right) n ( g ( X n ) − g ( θ ) ) D N ( 0 , σ 2 ( g ′ ( θ ) ) 2 ) 이게 저희가 이 장에서 Delta Method 를 배우는 가장 큰 이유라고 저는 개인적으로 생각하며, 이것을 활용, 및 증명하는 것들 역시 매우 중요하다고 생각합니다.
g ( X n ) = g ( θ ) + g ′ ( θ ) ( X n − θ ) + o p ( ∣ X n − θ ∣ ) n ( g ( X n ) − g ( θ ) ) = g ′ ( θ ) n ⋅ ( X n − θ ) + o p ( n ⋅ ∣ X n − θ ∣ ) g(X_n) = g(\theta) + g^\prime(\theta)(X_n - \theta) + o_p(|X_n - \theta|) \\
\sqrt{n}(g(X_n) - g(\theta)) = g^\prime(\theta) \sqrt{n} \cdot (X_n - \theta) + o_p(\sqrt{n} \cdot |X_n - \theta|) g ( X n ) = g ( θ ) + g ′ ( θ ) ( X n − θ ) + o p ( ∣ X n − θ ∣ ) n ( g ( X n ) − g ( θ )) = g ′ ( θ ) n ⋅ ( X n − θ ) + o p ( n ⋅ ∣ X n − θ ∣ ) 식을 정리하자면 첫번째 식은 다름이 아니라 Delta Method 를 적용시키면 첫번째 식과 같이 표현을 할 수 있다는 것입니다.
g ( θ ) g(\theta) g ( θ ) n \sqrt{n} n
저희는 이미 n ( X n − θ ) → D N ( 0 , σ 2 ) \sqrt{n}\left(X_n-\theta\right) \xrightarrow{D} N\left(0, \sigma^2\right) n ( X n − θ ) D N ( 0 , σ 2 )
n ( X n − θ ) \sqrt{n}\left(X_n-\theta\right) n ( X n − θ )
o p ( n ⋅ ∣ X n − θ ∣ ) → P 0 o_p(\sqrt{n} \cdot |X_n - \theta|) \xrightarrow{P} 0 o p ( n ⋅ ∣ X n − θ ∣ ) P 0
g ′ ( θ ) n ⋅ ( X n − θ ) → D g ′ ( θ ) ⋅ N ( 0 , σ 2 ) ↔ N ( 0 , σ 2 ⋅ ( g ′ ( θ ) ) 2 ) g^\prime(\theta) \sqrt{n} \cdot (X_n - \theta) \xrightarrow{D} g^\prime(\theta) \cdot \operatorname{N}(0, \sigma^2) \leftrightarrow \operatorname{N}\left(0, \sigma^2 \cdot (g^\prime(\theta))^2\right) g ′ ( θ ) n ⋅ ( X n − θ ) D g ′ ( θ ) ⋅ N ( 0 , σ 2 ) ↔ N ( 0 , σ 2 ⋅ ( g ′ ( θ ) ) 2 )
그렇기 때문에 위에서 2번째 식의 증명이 완료되었습니다.
MGF-Technique for Convergence in Distribution Convergence in Distribution 을 증명하기 위해서는 MGF 들을 비교해서 증명하는 방법도 존재합니다. 우선은 MGF 가 뭔지 먼저 복습하자면, Moment-Generating Function 이며 다음과 같은 식을 가집니다.
M X ( t ) = E [ e t X ] M_X(t) = \operatorname{E}\left[e^{tX} \right] M X ( t ) = E [ e tX ] { X n } \{X_n\} { X n } M X n ( t ) M_{X_n}(t) M X n ( t ) − h < t < h -h < t < h − h < t < h
X X X M X ( t ) M_X(t) M X ( t ) ∣ t ∣ ≤ h 1 ≤ h |t| \le h_1 \le h ∣ t ∣ ≤ h 1 ≤ h
If lim n → ∞ M X n ( t ) = M ( t ) \lim_{n \rightarrow \infty} M_{X_n}(t) = M(t) lim n → ∞ M X n ( t ) = M ( t ) ∣ t ∣ ≤ h 1 |t| \le h_1 ∣ t ∣ ≤ h 1
Then X n → D X X_n \xrightarrow{D} X X n D X
다시 말해 MGF 가 똑같다면 Convergence in Distribution 하다는 것과 같다는 의미입니다.
Central-Limit Theorem (CLT) What is CLT? CLT 의 의미는 표본 평균의 Limiting Distribution 이 정규분포를 따른다는 것입니다.
이것은 모든 통계 교수님들이 동의하실 통계학에서 가장 중요한 정리이기 때문에 이 정리가 무슨 의미를 가졌는지를 완전히 이해하시는 것도 향후 통계 과목/강의 들을 들으실 때에 큰 도움이 될 거라고 생각합니다.
이것이 중요한 이유는 표본이 어떠한 분포를 따르던간에 표본 평균이 정규분포를 따르기 때문에 그토록 더 중요한 것입니다.
X 1 , ⋯ , X n X_1, \cdots, X_n X 1 , ⋯ , X n μ \mu μ σ 2 < ∞ \sigma^2 < \infty σ 2 < ∞
Then, Y n = n ⋅ ( X ˉ n − μ ) σ Y_n = \frac{\sqrt{n} \cdot (\bar{X}_n - \mu)}{\sigma} Y n = σ n ⋅ ( X ˉ n − μ ) N ( 0 , 1 ) \operatorname{N}(0, 1) N ( 0 , 1 )
X ˉ n − E ( X ˉ n ) Var ( X ˉ n ) → D N ( 0 , 1 ) \frac{\bar{X}_n - \operatorname{E}(\bar{X}_n)}{\sqrt{\operatorname{Var}(\bar{X}_n)}}
\xrightarrow{D} \operatorname{N}(0,1) Var ( X ˉ n ) X ˉ n − E ( X ˉ n ) D N ( 0 , 1 ) 좌측을 다른 식으로 표현하면 다음과 같습니다.
X ˉ n − E ( X ˉ n ) Var ( X ˉ n ) = X ˉ n − μ σ 2 / n = n ( X ˉ n − μ ) σ = n ⋅ ( X ˉ n − μ ) n ⋅ σ = ∑ i = 1 n X i − n ⋅ μ n ⋅ σ → D N ( 0 , 1 ) \frac{\bar{X}_n - \operatorname{E}(\bar{X}_n)}{\sqrt{\operatorname{Var}(\bar{X}_n)}} =
\frac{\bar{X}_n - \mu}{\sqrt{\sigma^2 / n}} =
\frac{\sqrt{n} (\bar{X}_n - \mu)}{\sigma} = \frac{n \cdot (\bar{X}_n - \mu)}{\sqrt{n} \cdot\sigma} \\
= \frac{\sum_{i=1}^{n} X_i - n \cdot \mu}{\sqrt{n} \cdot \sigma} \xrightarrow{D} \operatorname{N}(0,1) Var ( X ˉ n ) X ˉ n − E ( X ˉ n ) = σ 2 / n X ˉ n − μ = σ n ( X ˉ n − μ ) = n ⋅ σ n ⋅ ( X ˉ n − μ ) = n ⋅ σ ∑ i = 1 n X i − n ⋅ μ D N ( 0 , 1 ) X ˉ n − E ( X ˉ n ) Var ( X ˉ n ) → D N ( 0 , 1 ) n ⋅ ( X ˉ − μ ) σ → D N ( 0 , 1 ) n ( X ˉ − μ ) → D N ( 0 , σ 2 ) ∑ i = 1 n X i − n ⋅ μ σ / n → D N ( 0 , 1 ) \frac{\bar{X}_n - \operatorname{E}(\bar{X}_n)}{\sqrt{\operatorname{Var}(\bar{X}_n)}} \xrightarrow{D} \operatorname{N}(0,1) \\~\\
\frac{\sqrt{n}\cdot (\bar{X} - \mu)}{\sigma} \xrightarrow{D} \operatorname{N}(0,1)\\~\\
\sqrt{n}(\bar{X} - \mu) \xrightarrow{D} \operatorname{N}(0, \sigma^2) \\~\\
\frac{\sum_{i=1}^{n} X_i - n\cdot \mu}{\sigma / \sqrt{n}} \xrightarrow{D} \operatorname{N}(0,1) Var ( X ˉ n ) X ˉ n − E ( X ˉ n ) D N ( 0 , 1 ) σ n ⋅ ( X ˉ − μ ) D N ( 0 , 1 ) n ( X ˉ − μ ) D N ( 0 , σ 2 ) σ / n ∑ i = 1 n X i − n ⋅ μ D N ( 0 , 1 ) 위의 식들은 사실상 다 똑같은 의미를 가지고 있습니다. 그리고 이것은 모두 다 Central-Limit Theorem 을 의미합니다.