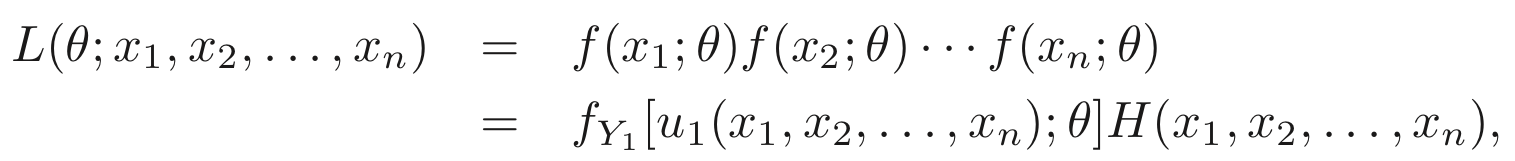7️⃣

7장 Sufficiency (1)

Properties of Point Estimators

Consistency : Yn→PθY_n \xrightarrow P \theta 이 만족이 된다면 Consistent Estimator 이라고 불린다!

Unbiasedness : E⁡[Yn]=θ\operatorname E \left[Y_n \right] = \theta 이 만족이 된다면 Unbiased Estimator 이라고 불린다!

여기에서 YY 은 뭘까요? 바로 저희들이 세운 표본에 의한 추정량입니다.

Y=u(X1,X2,⋯ ,Xn)Y = u(X_1, X_2, \cdots, X_n)

모든 MLE 들이 Unbiased 한 것은 아니지만 대부분의 MLE 들은 Asymptotically Unbiased 하다!

예:

X1,⋯ ,Xn∼iidN⁡(μ,σ2),σ^MLE2=1n⋅∑i=1n(Xi−Xˉ)2E⁡[σMLE2]=n−1n⋅σ2X_1, \cdots, X_n \stackrel{iid}{\sim} \operatorname N(\mu, \sigma^2), \quad \hat \sigma^2_{MLE} = \frac 1 n \cdot \sum_{i=1}^n \left(X_i - \bar X \right)^2 \\ \operatorname E\left[\sigma^2_{MLE}\right] = \frac{n-1}{n} \cdot \sigma^2
n⋅(θ^MLE−θ)→DN⁡(0,I−1(θ)),θ^MLE≈N⁡(θ,1n⋅I(θ))\sqrt{n} \cdot \left(\hat{\theta}_{MLE} - \theta \right) \xrightarrow D \operatorname N\left(0, I^{-1}(\theta)\right),\quad \hat \theta_{MLE} \approx \operatorname N\left(\theta, \frac{1}{n \cdot I(\theta)}\right)
Minimum Variance Unbiased Estimator (MVUE)

저희는 추정량을 Y=u(X1,X2,⋯ ,Xn)Y = u(X_1, X_2, \cdots, X_n) 으로 세울 수가 있습니다. 이 추정량이 만약에 우도함수를 최대화 시켜주는 추정량이면 그것을 Maximum-Likelihood Estimator 이라고 불렀습니다. 그러면 MVUE 는 무엇일까요?

MVUE (Minimum Variance Unbiased Estimator) 의 경우 비슷하게 Y=u(X1,X2,⋯ ,Xn)Y = u(X_1, X_2, \cdots, X_n) 이 어떠한 모수 θ\theta 의 MVUE 이기 위해서는 다음과 같은 조건이 만족되어야 합니다.

  • Unbiased : E⁡[Y]=θ\operatorname E[Y] = \theta
  • Minimum Variance : Var⁡(Y)≤Var⁡(Y2),\operatorname{Var}(Y) \le \operatorname{Var}(Y_2), where Y2Y_2 is ANY other Estimator of θ\theta.

예시 :

X1,X2,⋯ ,X9∼iidN⁡(θ,σ2) Xˉ=(X1+X2+⋯+X9)/9∼N⁡(θ,σ29) X1∼N⁡(θ,σ2)X_1, X_2, \cdots, X_9 \stackrel{iid}{\sim} \operatorname N(\theta, \sigma^2) \\~\\ \bar X = \left(X_1 + X_2 + \cdots + X_9 \right) / 9 \sim \operatorname N\left(\theta, \frac{\sigma^2}{9}\right) \\~\\ X_1 \sim \operatorname N\left(\theta, \sigma^2 \right)

위의 예시에 의하면 Xˉ\bar X 와 X1X_1 둘다 Unbiased 한 추정량입니다. 하지만 어떤게 더 낮은 분산을 가지고 있을까요? 여기에서는 당연히 Xˉ\bar X 입니다.

그렇다면 Xˉ\bar X 가 MVUE 라고 단정지을 수가 있나요? 없습니다! 모든 추정량들과 함께 비교를 해야되기 때문입니다.

Decision Function, Loss Function, Risk Function

Y=u(X1,⋯ ,Xn)Y = u(X_1, \cdots, X_n) 이 θ\theta 에 대한 점추정을 하기 위해서 필요한 통계량이라고 하겠습니다.

δ(y)\delta(y) 는 그러면 관측된 YY 에 대한 함수라고 두겠습니다. δ(y)\delta(y) 는 그러면 θ\theta 에 대한 점추정을 결정해주는 함수라고 봐도 됩니다.

이러한 함수 δ\delta 를 저희는 Decision Function / Decision Rule 이라고 부르며, Decision Function 의 1 값을 1개의 Decision 이라고 부릅니다.

Loss Function 이란 모수 θ\theta 와 Decision δ(y)\delta(y) 의 차이를 의미하며, 사용할 수 있는 Loss 함수는 굉장히 다양합니다. 머신러닝에서 아시는 Loss 함수를 적용시켜도 되기는 합니다!

식으로는 L[θ,δ(y)]L\left[\theta, \delta(y)\right] 으로 두며 이것의 역할은 Decision 이 얼마나 정확한지를 나타내주는 지표입니다.

Risk Function 은 이 Loss Function 의 기댓값입니다.

R(θ,δ)=E⁡{L[θ,δ(y)]}=∫−∞∞L[θ,δ(y)]fY(y;θ)dyR(\theta, \delta) = \operatorname E\left\{L\left[\theta, \delta(y) \right] \right\} = \int_{-\infty}^{\infty} L[\theta, \delta(y)] f_Y(y; \theta) dy

여기에서 Loss Function 이랑의 차이점이 뭐가 있냐면 Loss Function 의 경우에는 Observed Value yy 가 δ\delta 에 들어갑니다. 반면에 Risk Function 의 경우 모수 θ\theta 와 Decision Function δ,δ(Y)\delta, \delta(Y) 만 들어가게 됩니다. 이것은 yy 에 대한 기댓값이기에 이렇게 반영이 됩니다.

그럼 이것을 활용시켜서 무엇을 할 수 있을까요?

Solution 1 :

Restriction - E⁡[δ(Y)]=θ,for all θ∈Ω\operatorname E\left[\delta(Y) \right] = \theta, \quad \text{for all } \theta \in \Omega

Loss (Example) - L[θ,δ(y)]=[θ−δ(y)]2L\left[\theta, \delta(y) \right] = \left[\theta - \delta(y) \right]^2

Risk Function - R[θ,δ]=E⁡[(θ−δ(Y))2]=Var⁡[δ(Y)]R\left[\theta, \delta \right] = \operatorname E\left[\left(\theta - \delta(Y) \right)^2 \right] = \operatorname{Var}\left[\delta (Y)\right]

여기에서 Risk Function 을 최소화 시키는 δ\delta 가 MVUE 인 δ\delta 값을 찾는 것과 동일합니다!

Solution 2 :

Minimax Principle, R(θ,δ(Y))R(\theta, \delta(Y)) 의 최댓값을 최소화 시켜주는 δ\delta 함수가 BEST δ\delta 함수가 됩니다!

예시

Let R(θ,δ1)=125R(\theta, \delta_1) = \frac 1 {25} and R(θ,δ2)=θ2R(\theta, \delta_2) = \theta^2

max⁡−∞<θ<∞R(θ,δ1)=max⁡−∞<θ<∞125=125 max⁡−∞<θ<∞R(θ,δ2)=max⁡−∞<θ<∞θ2=∞\max_{-\infty < \theta < \infty} R(\theta, \delta_1) = \max_{-\infty < \theta < \infty} \frac 1 {25} = \frac 1 {25} \\~\\ \max_{-\infty < \theta < \infty} R(\theta, \delta_2) = \max_{-\infty < \theta < \infty} \theta^2 = \infty

Minimax Principle 에 의하면 δ1\delta_1 이 δ2\delta_2 에 비해서 더 좋다!

Sufficiency
X1,⋯ ,Xn∼f(x;θ),θ∈ΩX_1, \cdots, X_n \sim f(x; \theta), \theta \in \Omega

위의 가정을 두면서 통계량 Y=u(X1,X2,⋯ ,Xn)Y = u(X_1, X_2, \cdots, X_n) 에 대한 얘기를 하겠습니다.

통계량 YY 가 Sufficient 한 Statistic 이 되기 위해서는 X1,⋯ ,XnX_1, \cdots, X_n 의 Conditional Distribution by YY 가 θ\theta 에 의존하면 안됩니다!

교재 정의 :

f(x1,x2,⋯ ,xn;θ)fY1[u1(x1,x2,⋯ ,xn;θ)]=H(x1,x2,⋯ ,xn)\frac{f(x_1, x_2, \cdots, x_n; \theta)}{f_{Y_1}\left[u_1(x_1, x_2, \cdots, x_n; \theta) \right]} = H(x_1, x_2, \cdots, x_n)

에서 H(x1,x2,⋯ ,xn)H(x_1, x_2, \cdots, x_n) 이 θ\theta 에 의존하지 않는 것!

예시를 몇개를 들겠습니다.

  • X1,⋯ ,Xn∼iidB⁡(1,θ)→Y1=∑i=1nXiX_1, \cdots, X_n \stackrel{iid}{\sim} \operatorname B(1, \theta) \rightarrow Y_1 = \sum_{i=1}^{n} X_i
  • X1,⋯ ,Xn∼iidGamma(2,θ)→Y1=∑i=1nXiX_1, \cdots, X_n \stackrel{iid}{\sim} \text{Gamma}(2, \theta) \rightarrow Y_1 = \sum_{i=1}^{n} X_i

근데 사실 위의 방식으로 Sufficient Statistic 을 구하는 것은 매우 어려운 일입니다. 그렇기 때문에 Factorization Theorem 이라는 정리를 활용하면 굉장히 손쉽게 Sufficient Statistic 을 구할 수 있습니다.

Factorization Theorem

X1,⋯ ,Xn∼iidf(x;θ),θ∈ΩX_1, \cdots, X_n \stackrel{iid}{\sim} f(x; \theta), \quad \theta \in \Omega

위와 같은 상황이 주어진다면 우도 함수를 구축하는 것이 가능합니다.

L(θ)=∏i=1nf(xi;θ)=k1[u(X1,⋯ ,Xn);θ]k2[X1,⋯ ,Xn]L(\theta) = \prod_{i=1}^{n} f(x_i; \theta) = k_1\left[u(X_1, \cdots, X_n) ; \theta \right] k_2\left[X_1, \cdots, X_n \right]

여기에서 우도 함수를 θ\theta 와 연관된 부분과 θ\theta 와 연관이 없는 부분들로 나눌 수가 있습니다. 여기에서 k1k_1 과 k2k_2 가 Non-negative 하다면 u(X1,⋯ ,Xn)u(X_1, \cdots, X_n) 은 Sufficient 한 Statistic 이라고 말할 수가 있습니다.

이것은 if and only if 이기 때문에 모든 Sufficient Statistic 은 이것을 만족시켜줍니다.

예: (정규분포)

∏i=1n12πσ2⋅exp⁡(−(xi−θ)22σ2)=exp⁡(−∑i=1n(xi−θ)22σ2)⋅(2πσ2)−n2\prod_{i=1}^{n} \frac{1}{\sqrt{2\pi \sigma^2}} \cdot \exp\left(-\frac{(x_i - \theta)^2}{2 \sigma^2} \right) = \exp\left(- \sum_{i=1}^{n} \frac{(x_i - \theta)^2}{2 \sigma^2} \right) \cdot \left(2 \pi \sigma^2 \right)^{-\frac{n}{2}}
k1[u(X1,⋯ ,Xn);θ]=exp⁡(−∑i=1n(xi−θ)22σ2) k2(X1,⋯ ,X2)=(2πσ2)−n2k_1\left[u(X_1, \cdots, X_n) ; \theta\right] = \exp\left(- \sum_{i=1}^{n} \frac{(x_i - \theta)^2}{2 \sigma^2} \right)\\~\\ k_2(X_1, \cdots, X_2) = \left(2 \pi \sigma^2 \right)^{-\frac{n}{2}}

그러면 여기에서 저희는 u(X1,⋯ ,Xn)u(X_1, \cdots, X_n) 를 다음과 같이 구성할 수 있습니다.

u(X1,⋯ ,Xn)=∑i=1nxiu(X_1, \cdots, X_n) = \sum_{i=1}^n x_i

저희가 흔히 알고 있는 이것에 대한 MLE 는 Xˉ\bar X 입니다. 하지만 Xˉ\bar X 도 위의 통계량으로 구축이 가능합니다.

Xˉ=1n⋅∑i=1nXi\bar X = \frac 1 n \cdot \sum_{i=1}^n X_i

그럼 여기에서 알 수 있는 것을 무엇일까요? 바로 Sufficient Statistic 은 Unique 하지 않다는 것입니다! 따지고 보면 Xˉ\bar X 도 Sufficient Statistic 이기 때문에 Xˉ2,Xˉ3,log⁡(Xˉ)\bar X ^2, \bar X ^3, \log(\bar X) 등도 모두 다 Sufficient 한 Statistic 이라는 것입니다.

근데 저희는 MVUE 에 대해서 궁금해했는데, 왜 갑자기 Sufficient Statistic 에 대해서 배울까요? MVUE 를 구하기 위한 빌드업입니다.

Rao-Blackwell Theorem

Y1=u1(X1,⋯ ,Xn)Y_1 = u_1(X_1, \cdots, X_n) : Sufficient Statistic for θ\theta

Y2=u2(X1,⋯ ,Xn)Y_2 = u_2(X_1, \cdots, X_n) : Unbiased Estimator of θ\theta

위와 같은 상황을 고려해주시길 바랍니다. 그러면

ψ(Y1)=E⁡[Y2∣Y1]\psi(Y_1) = \operatorname E\left[Y_2 | Y_1 \right] 는 θ\theta 의 Unbiased Estimator 가 됩니다. 왜 일까요? 이것은 Conditional Expectation 의 정의를 생각하면 됩니다.

θ=E⁡[Y2]=E⁡[E⁡(Y2∣Y1)]\theta = \operatorname E\left[Y_2 \right] = \operatorname E\left[\operatorname E\left(Y_2 | Y_1 \right) \right]

그럼 E⁡[Y2∣Y1]\operatorname E[Y_2|Y_1] 는 정확하게 뭘까요? 다른게 아니라 그냥 Y1Y_1 에 대한 함수입니다.

그렇기 때문에 ψ(Y1)\psi(Y_1) 으로도 표현할 수 있다는 것입니다.

추가적으로 다음과 같은 관계도 성립이 됩니다. (Law of Total Variance)

Var⁡(E⁡(Y2∣Y1))≤Var⁡(Y2)\operatorname{Var}\left(\operatorname E(Y_2 | Y_1) \right) \le \operatorname{Var} (Y_2)

위의 E⁡(Y2∣Y1)\operatorname E(Y_2|Y_1) 에 ψ(Y1)\psi(Y_1) 을 대입시키게 된다면 다음과 같이 나오게 됩니다.

Var⁡[ψ(Y1)]≤Var⁡(Y2)\operatorname{Var}\left[\psi(Y_1) \right] \le \operatorname{Var} (Y_2)

Equality 는 Y2Y_2 가 Y1Y_1 에 대한 함수일 때 해당이 됩니다.

이것을 통해서 저희는 MVUE 를 구하는데 조금 더 편하게 구할 수가 있게 됩니다.

Law of Total Variance :

Var⁡[X]=E[Var⁡(X∣Y)]+Var⁡[E(X∣Y)]≥Var⁡[E(X∣Y)],  Equality holds when X is a function of Y Var⁡[Y2]=E[Var⁡[ψ(Y1)]]+Var⁡[E[ψ(Y1)]]≥Var⁡[E[ψ(Y1)]]\operatorname{Var}[X]=E[\operatorname{Var}(X \mid Y)]+\operatorname{Var}[E(X \mid Y)] \geq \operatorname{Var}[E(X \mid Y)] \text {, } \\~\\ \text{Equality holds when X is a function of Y} \\~\\\operatorname{Var}\left[Y_2\right]=E\left[\operatorname{Var}\left[\psi\left(Y_1\right)\right]\right]+\operatorname{Var}\left[E\left[\psi\left(Y_1\right)\right]\right] \geq \operatorname{Var}\left[E\left[\psi\left(Y_{1}\right)\right]\right]

위의 정리를 한번 더 정리를 하자면,

Y1=u1(X1,⋯ ,Xn)Y_1 = u_1(X_1, \cdots, X_n) : Sufficient Statistic for θ\theta

Y2=u2(X1,⋯ ,Xn)Y_2 = u_2(X_1, \cdots, X_n) : Unbiased Estimator of θ\theta

위와 같은 상황에서, ψ(Y1)=E⁡[Y2∣Y1]\psi(Y_1) = \operatorname E\left[Y_2 | Y_1 \right] 는 θ\theta 에 대한 Unbiased Estimator 이면서 Sufficient 한 Statistic, 그리고 분산이 다음과 같은 관계를 가집니다.

Var⁡[ψ(Y1)]≤Var⁡(Y2)\operatorname{Var}\left[\psi(Y_1) \right] \le \operatorname{Var} (Y_2)

이렇게 한다면 최소의 분산을 구축하는데에 도움이 훨씬 많이 됩니다.

그럼 왜 ψ(Y1)\psi(Y_1) 는 θ\theta 에 대해서 독립일까요?

E⁡[Y2∣Y1]=E⁡[u2(X1,⋯ ,Xn)∣Y1]=∫u2(x1,⋯ ,xn)⋅f(x1,⋯ ,xn∣y1)dx1⋯dxn\operatorname E\left[Y_2 \mid Y_1 \right] = \operatorname E\left[u_2(X_1, \cdots, X_n) \mid Y_1 \right] \\ = \int u_2(x_1, \cdots, x_n) \cdot f(x_1, \cdots, x_n \mid y_1) dx_1 \cdots dx_n

적분 식에서 좌측과 우측 둘다 θ\theta 에 대해서 독립적입니다. 그렇기 때문에 전체 식도 θ\theta 에 대해서는 독립적이라는 뜻입니다.

Theorem 7.3.2 (Rao-Blackwell Part 2)

Y1=u1(X1,⋯ ,Xn)Y_1 = u_1(X_1, \cdots, X_n) : Sufficient Statistic for θ\theta

θ^\hat \theta : Unique MLE of θ\theta

그러면 θ^\hat \theta 는 Y1Y_1 에 대한 함수입니다.

이것에 대한 예시를 처음에 다뤘습니다 (정규분포에서 ∑i=1nXi\sum_{i=1}^n X_i 와 Xˉ\bar X 에 관한 것

증명의 경우 굉장히 쉽습니다.

예시를 들겠습니다.

Example 7.3.1
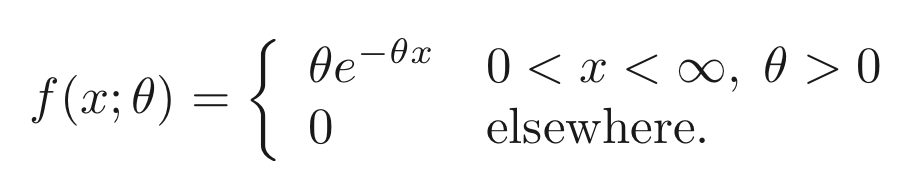
iid 라는 가정이 들어 갔을 때에, 우도함수는 다음과 같이 구축이 가능합니다.

L(θ;x1,⋯ ,xn)=θn⋅e−θ∑i=1nxiL(\theta; x_1, \cdots, x_n) = \theta^n \cdot e^{-\theta \sum_{i=1}^n x_i}

여기에 Factorization Theorem 을 적용시키게 된다면, 다음과 같이 나눌 수가 있습니다.

k1(u(X1,⋯ ,Xn);θ)=θn⋅e−θ∑i=1nxi k2(X1,⋯ ,Xn)=1k_1(u(X_1, \cdots, X_n); \theta) = \theta^n \cdot e^{-\theta \sum_{i=1}^n x_i} \\~\\ k_2(X_1, \cdots, X_n) = 1

그러면 X 가 들어간 부분은 ∑i=1nXi\sum_{i=1}^n X_i 이기 때문에 Sufficient 한 Statistic 은 다음과 같습니다.

Y1=u(X1,⋯ ,Xn)=∑i=1nXiY_1 = u(X_1, \cdots, X_n) = \sum_{i=1}^n X_i

이제는 로그를 취해주면서 MLE 를 구해보겠습니다.

l(θ)=n⋅log⁡(θ)−θ∑i=1nXi ∂l(θ)∂θ=nθ−∑i=1nXi=set0,θ^=n∑i=1nXi=1Xˉl(\theta) = n \cdot \log(\theta) - \theta \sum_{i=1}^n X_i \\~\\ \frac{\partial l(\theta)}{\partial \theta} = \frac{n}{\theta} - \sum_{i=1}^n X_i \stackrel{set}{=} 0, \quad \hat \theta = \frac{n}{\sum_{i=1}^n X_i} = \frac{1}{\bar X}

그럼 Y2=1/XˉY_2 = 1 / \bar X 으로 두겠습니다. 근데 Y2Y_2 도 Y1Y_1 으로 표현이 다음과 같이 가능합니다.

Y2=1Xˉ=n∑i=1nXi=nY1Y_2 = \frac{1}{\bar X} = \frac{n}{\sum_{i=1}^n X_i} = \frac{n}{Y_1}

이 점을 유의하시고 X 에 대한 pdf 들로 돌아가겠습니다. Gamma 분포에 대한 pdf (Scale) 는 다음과 같습니다.

ƒ(x)=1Γ(α)⋅βα⋅xα−1⋅exp⁡(−x/β)ƒ(x) = \frac{1}{\Gamma(\alpha) \cdot \beta ^ \alpha} \cdot x^{\alpha - 1} \cdot \exp(- x/\beta)

위에 α=1,β=1/θ\alpha = 1, \beta = 1/\theta 를 대입시키면 다음과 같이 나옵니다.

Γ(1,1/θ)→f(x)=1Γ(1)⋅1θ⋅x1−1⋅exp⁡(−x/(1/θ)) =θ⋅exp⁡(−θx)\Gamma(1, 1/\theta) \rightarrow f(x) = \frac{1}{\Gamma(1) \cdot \frac{1}{\theta}} \cdot x^{1-1} \cdot \exp(-x/(1/\theta))\\~\\ = \theta \cdot \exp(-\theta x)

그러면 Xi∼iidΓ(1,1/θ)X_i \stackrel{iid}{\sim} \Gamma(1, 1/\theta) 라고 둘 수 있게 됩니다. 그럼 Gamma Distribution 의 특징을 이용하면 ∑i=1nXi\sum_{i=1}^n X_i 에 대한 분포도 다음과 같이 구성할 수 있습니다.

∑i=1nXi∼Γ(n,  1θ)\sum_{i=1}^n X_i \sim \Gamma\left(n, \; \frac{1}{\theta}\right)

그럼 이제 Y2Y_2 의 기댓값을 구하는 것이 가능해집니다.

E⁡(Y2)=E⁡[n∑i=1nXi]=n⋅E⁡[1∑i=1nXi]=n⋅E⁡[1t∣t=∑i=1nXi] =n⋅∫0∞1t⋅1Γ(n)⋅(1θ)n⋅tn−1⋅e−t/(1/θ)dt =n⋅∫0∞θnΓ(n)⋅tn−2⋅e−θtdt\operatorname E(Y_2) = \operatorname E\left[\frac{n}{\sum_{i=1}^n X_i} \right] = n \cdot \operatorname E\left[\frac{1}{\sum_{i=1}^n X_i} \right] = n \cdot \operatorname E\left[\frac 1 t \mid t = \sum_{i=1}^n X_i \right] \\~\\ = n\cdot \int_0^\infty \frac{1}{t} \cdot \frac{1}{\Gamma(n) \cdot \left(\frac{1}{\theta} \right)^n} \cdot t^{n-1} \cdot e^{-t / (1/\theta)} dt \\~\\ = n\cdot \int_0^\infty \frac{\theta^n}{\Gamma(n)} \cdot t^{n-2} \cdot e^{-\theta t} dt

Let z=θt,dz=θ⋅dtz = \theta t, \quad dz = \theta \cdot dt

=n⋅∫0∞θnΓ(n)⋅(z/θ)n−2⋅e−z1θdz =n⋅∫0∞θΓ(n)⋅zn−2⋅e−zdz =n⋅θΓ(n)∫0∞1Γ(n−1)⋅1(n−1)⋅z(n−1)−1⋅e(−z/1)dz⋅Γ(n−1)⋅1(n−1) =n⋅θ⋅Γ(n−1)Γ(n)⋅1=n⋅θ⋅(n−2)!(n−1)!=θ⋅nn−1= n \cdot \int_0^\infty \frac{\theta^n}{\Gamma(n)} \cdot (z / \theta)^{n-2} \cdot e^{-z} \frac{1}{\theta} dz \\~\\ = n\cdot \int_0^\infty \frac{\theta}{\Gamma(n)} \cdot z^{n-2} \cdot e^{-z} dz \\~\\ = n \cdot \frac{\theta}{\Gamma(n)} \int_0^\infty \frac{1}{\Gamma(n-1) \cdot 1^{(n-1)}}\cdot z^{(n-1) -1} \cdot e^{(-z/1)} dz \cdot \Gamma(n-1) \cdot 1^{(n-1)} \\~\\ = n\cdot \theta \cdot \frac{\Gamma(n-1)}{\Gamma(n)} \cdot 1 = n \cdot \theta \cdot \frac{(n-2)!}{(n-1)!} = \theta \cdot \frac{n}{n-1}

정리하자면 다음과 같습니다.

E⁡[Y2]=θ⋅nn−1 θ=E⁡[Y2]⋅n−1n=n−1n⋅n∑i=1n =n−1∑i=1nXi\operatorname E[Y_2] = \theta \cdot \frac{n}{n-1} \\~\\ \theta = \operatorname E[Y_2] \cdot \frac{n-1}{n} = \frac{n-1}{n} \cdot \frac{n}{\sum_{i=1}^n} \\~\\ = \frac{n-1}{\sum_{i=1}^n X_i}

결론적으로는 θ\theta 에 대한 MVUE 는 n−1∑i=1nXi\frac{n-1}{\sum_{i=1}^n X_i} 으로 마무리 할 수가 있습니다.