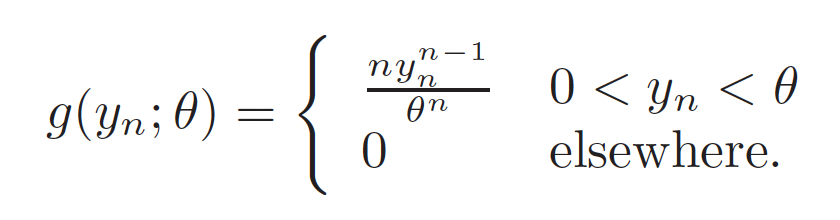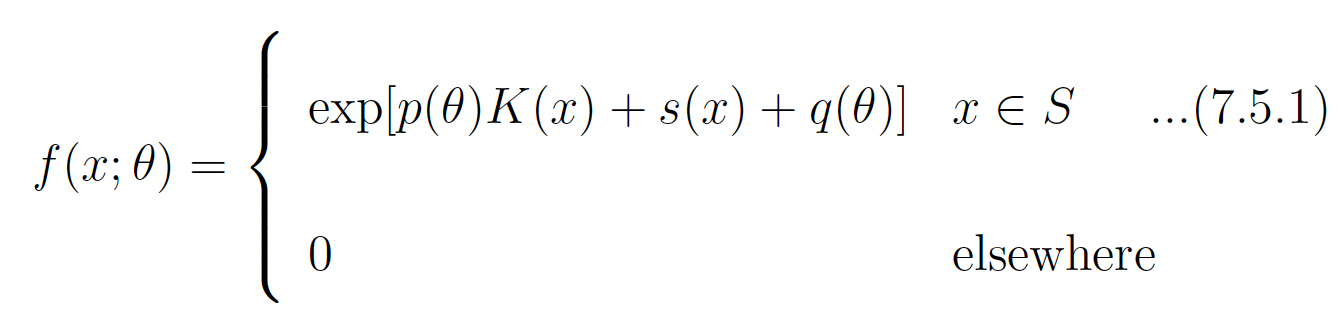🫠

7장 Sufficiency (2)

Completeness

ZZ 는 어떠한 Family {h(z;θ):θ∈Ω}\{h(z;\theta) : \theta \in \Omega\} 의 구성원 중 하나라고 생각하겠습니다.

즉 ZZ 는 확률변수입니다. Z∼h(z;θ)Z \sim h(z; \theta)

만약에 모든 θ∈Ω\theta \in \Omega 에 대해서 E⁡[u(z)]=0\operatorname E[u(z)] = 0 가 만족이 되기 위해서

z∈{z:h(z,θ)=0 for each θ∈Ω}z \in \{z : h(z, \theta) = 0 \text{ for each } \theta \in \Omega\} 에 대한 Set 을 제외한 Set 에서는 u(z)=0u(z) = 0 일 때,

h(z;θ)h(z;\theta) 를 zz 에 대한 Complete Family 라고 볼 수가 있습니다.

다시 말해 u(z)u(z) 가 가질 수 있는 값들 중에서 확률이 00 인 구간도 존재합니다. 얘네에 대해서는 zz 가 무슨 값이든 확률이 00 이기 때문에 고려를 하지 않아도 됩니다. 반면에 확률이 00 이 아닌 모든 구간에서는 u(z)=0u(z) = 0 이라는 의미를 가집니다.

예시를 들겠습니다.

X1,⋯ ,Xn∼iidPoisson(θ), ∑i=1nXi=Y=Poisson(nθ) g(y;θ)=(nθ)y⋅e−nθy!,  if y=0,1,2,⋯  ,else g(y;θ)=0X_1, \cdots, X_n \stackrel{iid}{\sim} \text{Poisson}(\theta), \\~\\ \sum_{i=1}^n X_i = Y = \text{Poisson}(n \theta) \\~\\ g(y; \theta) = \frac{(n\theta)^y \cdot e^{-n\theta}}{y!}, \; \text{if } y = 0, 1, 2,\cdots\; ,\quad \text{else } g(y;\theta) = 0

Complete Family 이기 위해서는 E⁡[u(Y)]=0\operatorname E[u(Y)] = 0 이 모든 θ\theta 에 대해서 만족이 되어야 합니다. Summation 부분을 그저 확장을 시키게 된다면 다음과 같이 나오게 됩니다.

0=E[u(Y1)]=∑y1=0∞u(y1)(nθ)y1e−nθy1!=e−nθ[u(0)+u(1)nθ1!+u(2)(nθ)22!+⋯ ]\begin{aligned}& 0=E\left[u\left(Y_1\right)\right]=\sum_{y_1=0}^{\infty} u\left(y_1\right) \frac{(n \theta)^{y_1} e^{-n \theta}}{y_{1}!} \\& =e^{-n \theta}\left[u(0)+u(1) \frac{n \theta}{1!}+u(2) \frac{(n \theta)^2}{2!}+\cdots\right]\end{aligned}

여기에서 e−nθe^{-n\theta} 는 00 이 될 수 없기에 2-번째 Term 이 00 이랑 똑같아야합니다. 그렇기에

0=u(0)+[n⋅u(1)]θ+[n2⋅u(2)2]θ2+⋯0=u(0)+[n \cdot u(1)] \theta+\left[\frac{n^2 \cdot u(2)}{2}\right] \theta^2+\cdots

이 만족이 되어야 된다는 것입니다. 위의 것이 만족이 되기 위해서는 u(y)=0u(y) = 0, for y=0,1,2,⋯y = 0, 1, 2, \cdots 가 만족이 되어야 합니다. 그렇기 때문에 저희가 관심이 있는 구간인 y=0,1,2,⋯y=0, 1, 2, \cdots 에서는 u(y)=0u(y)=0 이며 나머지 구간에서는 u(y)=0u(y)=0 이 안 나와도 상관없다는 것입니다.

하지만 y=0,1,2,⋯y=0, 1, 2, \cdots 의 구간은 g(y;θ)g(y; \theta) 에서 yy 에 대한 구간과 똑같습니다.

그렇기 때문에 {g(y;θ):θ>0}\{g(y; \theta) : \theta > 0\} 를 yy 에 대한 Complete Family 라고 볼 수가 있는 것입니다.

이번에는 정규분포를 예시로 들겠습니다.

X1,⋯ ,Xn∼iidN(μ,σ2) Xˉ∼N⁡(μ,σ2n),E⁡[u(Xˉ)]=0X_1, \cdots, X_n \stackrel{iid}{\sim} N(\mu, \sigma^2) \\~\\ \bar X \sim \operatorname N(\mu, \frac{\sigma^2}{n}), \quad \operatorname E\left[u(\bar X) \right] = 0

마지막이 x∈Xx \in X 에 대해서 다 만족이 되어야지 Completeness 가 만족이 되기에 이것을 만족시킬 수 있는 함수는 u(x)=0u(x) = 0 밖에 없습니다. 그렇기에 해당 통계량 Xˉ\bar X 는 Completeness 를 만족하는 Statistic 임을 알 수가 있습니다.

Lehmann-Scheffe Theorem

다음과 같은 Setting 을 고려하겠습니다.

n:n : A fixed Positive Integer

X1,⋯ ,Xn∼i.i.dpdf f(x;θ),  θ∈ΩX_1, \cdots, X_n \stackrel{i.i.d}{\sim} \text{pdf } f(x; \theta), \; \theta \in \Omega

{fY1(y1;θ):θ∈Ω}:\{f_{Y_1}(y_1 ; \theta) : \theta \in \Omega \} : Complete

여기에서 만약에 E⁡[ψ(Y1)]=θ\operatorname E[\psi(Y_1)] = \theta 가 만족이 된다면, ψ(Y1)\psi(Y_1) 은 θ\theta 에 대한 Unique MVUE 입니다.

이것은 만약에 E⁡[g(Y1)]=θ\operatorname E[g(Y_1)] = \theta 가 만족이 된다면, g(Y1)g(Y_1) 은 θ\theta 에 대한 Unique MVUE 이라는 것과 같은 의미를 가집니다.

증명 :

Y2Y_2 를 θ\theta 에 대한 아무 Unbiased Estimator 라고 생각하겠습니다.

그럼 이전 튜터링 때 배웠던 Rao-Blackwell Theorem 에 의하면,

E⁡[E⁡[Y2∣Y1]]=E⁡[Y2]=θ Var⁡[E⁡[Y2∣Y1]]≤Var⁡[Y2]\operatorname E\left[\operatorname E \left[Y_2 \mid Y_1 \right] \right] = \operatorname E[Y_2] = \theta \\~\\ \operatorname{Var}\left[\operatorname E\left[Y_2 \mid Y_1 \right] \right] \le \operatorname{Var}[Y_2]

Equality 이 경우 Y2Y_2 가 Y1Y_1 의 Function 이면 만족이 됩니다.

그렇기 때문에 그것을 가정을 해보겠습니다.

ψ(Y1)\psi(Y_1) 을 Y1Y_1 에 대한 Function 이라고 가정을 하고 이 함수가 다음을 만족한다고 하겠습니다.

E⁡[ψ(Y1)]=θ\operatorname E[\psi(Y_1)] = \theta

E⁡[Y2∣Y1]\operatorname E[Y_2 \mid Y_1] 와 ψ(Y1)\psi(Y_1) 둘다 θ\theta 에 대한 Unbiased Estimator 들이기 때문에 다음과 같이 쓸 수가 있습니다.

E⁡[E⁡[Y2∣Y1]−ψ(Y1)]=θ−θ=0,for all θ∈Ω\operatorname E[\operatorname E\left[Y_2 \mid Y_1\right] - \psi(Y_1)] = \theta - \theta = 0, \quad \text{for all }\theta \in \Omega

아직 이 둘의 통계량이 똑같다고는 단정 지을 수는 없습니다. 둘에 대한 기댓값이 똑같은거지 둘의 분산은 똑같지 않기 때문입니다.

그래서 u(Y1)u(Y_1) 을 새로 정의하겠습니다.

u(Y1)=E⁡[Y2∣Y1]−ψ(Y1)u(Y_1) = \operatorname E[Y_2 \mid Y_1] - \psi(Y_1)

{fY1(y1;θ):θ∈Ω}:\{f_{Y_1}(y_1 ; \theta) : \theta \in \Omega \} : Complete

이라는 조건이 처음에 있었습니다. 이 점을 이용하게 된다면

u(Y1)=0u(Y_1) = 0 for all y1y_1 Except for 확률이 00 인 지점들!

그렇기 때문에 E⁡[Y2∣Y1]\operatorname E[Y_2 \mid Y_1] 과 ψ(Y1)\psi(Y_1) 는 결국에는 똑같아진다는 것을 알고 있습니다.

Rao-Blackwell Theorem 의 마지막 부분에 위를 적용시킨다면,

Var⁡[E⁡[Y2∣Y1]]≤Var⁡[Y2]ψ(Y1)≤Var⁡[Y2]\operatorname{Var}\left[\operatorname E\left[Y_2 \mid Y_1 \right] \right] \le \operatorname{Var}[Y_2] \\ \psi(Y_1) \le \operatorname{Var}[Y_2]

으로 ψ(Y1)\psi(Y_1) 은 Unique 한 MVUE 가 됩니다.

적용 예시 :

X1,⋯ ,Xn∼Unif⁡ 분포X_1, \cdots, X_n \sim \operatorname{Unif}\text{ 분포}

이것에 대한 pdf 는 그럼 f(x;θ)=1/θ,  0<x<θ,f(x;θ)=0,   o.w.f(x; \theta) = 1/\theta, \; 0<x<\theta, \quad f(x;\theta) = 0, \; \text{ o.w.}

이전 문제에서 Yn=max⁡{X1,X2,⋯ ,Xn}Y_n = \max\{X_1, X_2, \cdots, X_n \} 이 Sufficient Statistic 임을 밝힌 적이 있습니다.

그럼 YnY_n 의 pdf 는 다음과 같습니다.

YnY_n 이 Complete & Sufficient Statistic 임을 보이기 위해서 우선은 u(t)u(t) 함수를 갖고 오겠습니다. Where E⁡[u(t)]=0\operatorname E[u(t)] = 0. 이것이 의미하는 것은 다음과 같습니다.

∫0θu(t)⋅n⋅tn−1θndt=0=nθn∫0θu(t)⋅tn−1 =Since θ>0∫0θu(t)⋅tn−1dt=0\int_0^\theta u(t) \cdot \frac{n \cdot t^{n-1}}{\theta^n} dt = 0 = \frac{n}{\theta^n} \int_0^\theta u(t) \cdot t^{n-1} \\~\\ \stackrel{\text{Since }\theta > 0}{=} \int_0^\theta u(t) \cdot t^{n-1}dt =0

이것을 θ\theta 에 대해서 미분하게 된다면 좌측의 경우 tt 대신에 θ\theta 로 된 Integrand 가 나오며 우측은 상수이므로 그저 00 이 나옵니다. 그렇기에 다음으로 이어집니다.

u(θ)⋅θn−1=0u(\theta) \cdot \theta^{n-1} = 0

Support 에 의하면 θ>0\theta >0 입니다. 그렇기에 위의 식을 만족하려면 u(θ)=0u(\theta) =0 일 수밖에 없습니다.

그렇기 때문에 YnY_n 은 Complete and Sufficient 한 Statistic 이 됩니다.
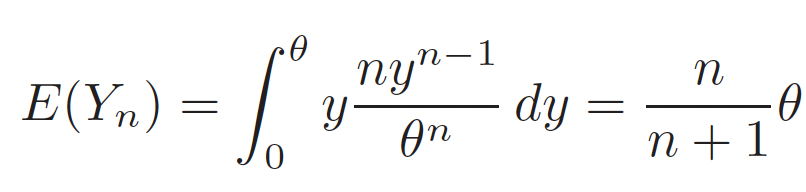
우측 식을 정리하면 MVUE 인 ψ(Yn)\psi(Y_n) 까지 구할 수 있게 됩니다.

E⁡[Yn⋅n+1n]=θ\operatorname E\left[Y_n \cdot \frac{n+1}{n}\right] = \theta
Regular Exponential Class Conditions

SS 는 XX 의 Support 이 됩니다. Support 의 경우 다음과 같이 표현이 가능합니다.

S={x:f(x;θ)>0}S = \{x: f(x; \theta) > 0 \}

이러한 Setting 에서 pdf 가 다음과 같은 조건들을 다 만족한다면 그것은 Regular Exponential Class 의 Member 라고 말할 수가 있습니다.

  1. SS does not Depend on θ\theta
  1. p(θ)p(\theta) is a non-trivial continuous function of θ∈Ω\theta \in \Omega, 즉 p(θ)p(\theta) 는 Constant / 상수 가 아니라는 것입니다.

3-a. If XX is a continuous random variable,

then K′(x)≠0K^\prime(x) \ne 0 and s(x)s(x) is a continuous function of x∈Sx \in S

3-b. If XX is a discrete random variable,

then K(x)K(x) is a non-trivial function of x∈Sx \in S, 즉 Constant 가 아니다.

예시 (정규분포) :

f(x;θ)=12πθ⋅exp⁡(−x22θ) =exp⁡(−12θx2−log⁡(2πθ)),−∞<x<θf(x;\theta) = \frac{1}{\sqrt{2\pi \theta}} \cdot \exp\left(- \frac{x^2}{2 \theta} \right)\\~\\ = \exp\left(-\frac{1}{2\theta} x^2 - \log(\sqrt{2\pi \theta}) \right), \quad -\infty < x < \theta
  1. S={x:−∞<x<∞}S = \{x : -\infty < x < \infty\}, Does not depend on θ\theta
  1. p(θ)=−1/(2θ)p(\theta) = - 1 / (2\theta), Not a Constant! —> Non-trivial Continuous Function
  1. K(x)=x2K(x) = x^2, K′(x)=2x≠0K^\prime(x) = 2x \ne 0, 그리고 s(x)=0s(x) = 0 이며 Continuous 하다

그렇기 때문에 Member of Regular Exponential Class 이다!

그럼 왜 이거를 아는 것이 중요할까요? 정리 7.5.1 에 다 있습니다

Theorem 7.5.1 & 7.5.2

정리 7.5.1 :

X1,⋯ ,XnX_1, \cdots, X_n 는 iid 하며 Regular Exponential Class Family 소속의 분포를 따라간다고 하겠습니다.

그리고 Y1=∑i=1nK(Xi)Y_1 = \sum_{i=1}^n K(X_i) 라고 두겠습니다. 그러면

  1. Y1Y_1 에 대한 pdf 는 다음과 같은 형태로 나오게 됩니다.
fY1(y1;θ)=R(y1)exp⁡[p(θ)y1+nq(θ)],y1∈SY1f_{Y_1}\left(y_1 ; \theta\right)=R\left(y_1\right) \exp \left[p(\theta) y_1+n q(\theta)\right], \quad y_1 \in S_{Y_1}

SY1S_{Y_1} 와 R(y1)R(y_1) 둘다 θ\theta 에 Depend 하지 않게 됩니다.

  1. 이것은 해당 강의에서는 주요 내용이 아닌걸로 기억하기는 합니다.
E⁡(Y1)=−n⋅q′(θ)p′(θ)\operatorname E(Y_1) = -n \cdot \frac{q^\prime(\theta)}{p^\prime(\theta)}
  1. 이것 역시 해당 강의에서는 주요 내용이 아닌걸로 기억하기는 합니다. 하지만 2. 와 3. 와 같은 특징들도 있구나~ 정도로 이해하셔도 될 것 같습니다.
Var⁡(Y1)=n⋅1[p′(θ)]3{p′′(θ)q′(θ)−q′′(θ)p′(θ)}\operatorname{Var}(Y_1) = n\cdot \frac{1}{\left[p^\prime(\theta) \right]^3}\left\{p^{\prime\prime}(\theta) q^\prime(\theta) - q^{\prime\prime}(\theta) p^\prime(\theta) \right\}

정리 7.5.2

위와 같은 X1,⋯ ,XnX_1, \cdots, X_n 인 상황일 때, θ\theta 의 범위를 다음과 같이 설정할 수 있습니다.

v<θ<δv < \theta < \delta, where vv and δ\delta are known constants that can be ±∞\pm \infty

그러면

Y1=∑i=1nK(Xi)Y_1 = \sum_{i=1}^n K(X_i)

는 θ\theta 의 Sufficient Statistic 이며

{fY1(y1;θ):ν<θ<δ}\left\{f_{Y_1}\left(y_1 ; \theta\right): \nu<\theta<\delta\right\} 는 Complete 해집니다.

이 둘을 조합하면 Y1Y_1 은 θ\theta 의 Complete & Sufficient 한 Statistic 이 됩니다.

7.6 장

여태까지는 θ\theta 의 MVUE 를 찾는 것이었으며 이제는 θ\theta 의 함수의 MVUE 를 찾아야합니다.

Example 7.6.2 를 다루고 나서 마치겠습니다.

X1,⋯ ,Xn∼iidUnif⁡(0,θ) Yn=max⁡{X1,X2,⋯ ,Xn}: Sufficient and Complete Statistic of θX_1, \cdots, X_n \stackrel{iid}{\sim} \operatorname{Unif}(0, \theta) \\~\\ Y_n = \max\{X_1, X_2, \cdots, X_n \} : \text{ Sufficient and Complete Statistic of } \theta

그러면 g(θ)g(\theta) 의 MVUE⁡\operatorname{MVUE} 는 u(Yn)u(Y_n) 이며 다음을 만족합니다.

g(θ)=∫0θu(y)⋅n⋅yn−1θndy,θ>0 =1θn⋅∫0θu(y)⋅n⋅yn−1dyg(\theta) = \int_0^\theta u(y) \cdot \frac{n \cdot y^{n-1}}{\theta^n} dy, \quad \theta > 0 \\~\\ = \frac{1}{\theta^n} \cdot \int_0^\theta u(y)\cdot n \cdot y^{n-1} dy

옆으로 보내면,

g(θ)⋅θn=∫0θu(y)⋅n⋅yn−1dyg(\theta) \cdot \theta^n = \int_0^\theta u(y) \cdot n \cdot y^{n-1} dy

양측을 θ\theta 에 대해서 미분시키면,

g′(θ)⋅θn+g(θ)⋅n⋅θn−1=u(θ)⋅n⋅θn−1g^\prime(\theta) \cdot \theta^n + g(\theta) \cdot n \cdot \theta^{n-1} = u(\theta) \cdot n \cdot \theta^{n-1}

식을 정리하면,

u(θ)=1n⋅θn−1⋅(g′(θ)⋅θn+g(θ)⋅n⋅θn−1) =g′(θ)n+g(θ)u(\theta) = \frac{1}{n \cdot \theta^{n-1}} \cdot \left(g^\prime(\theta) \cdot \theta^n + g(\theta) \cdot n \cdot \theta^{n-1} \right) \\~\\ = \frac{g^\prime(\theta)}{n} + g(\theta)

여기에 MVUE 인 YnY_n 을 대입시키게 된다면

u(Yn)=g′(Yn)n+g(Yn)u(Y_n) = \frac{g^\prime(Y_n)}{n} + g(Y_n)

이렇게 마무리 시키는 것이 가능합니다. 여기에서 예를 들어서 g(θ)=θg(\theta) = \theta 이면

u(Yn)=1n+Yn=n+1n⋅Ynu(Y_n) = \frac{1}{n} + Y_n = \frac{n+1}{n} \cdot Y_n

으로 이전에 구한 MVUE 와 똑같게 나오게 됩니다!