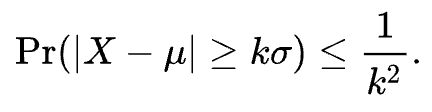1장 Introduction to Statistical Computing + Monte-Carlo Simulation
Computing Basics
Log-Exp Sum Trick
Random Number Generators
Monte-Carlo Integral
Riemann-Stieltjes Integral
Computing Basics
아날로그 컴퓨터
아날로그 컴퓨터들의 경우 전기, 기계 등을 활용하여서 연속적으로 바뀌는 것을 활용합니다. 이것에 대한 대표적인 예시로는 아날로그 시계가 있습니다. 시계를 보면 0→1 으로 바로 쓱 올라가는게 아니라 연속적으로 올라갑니다. 하지만 이는 아날로그 컴퓨터들이며 요즘의 거의 모든 디지털 컴퓨터들은 이렇게 작동하지 않습니다.
디지털 컴퓨터
디지털 / 현대 컴퓨터들은 대부분 이진법 (Binary Language) 를 사용합니다 (0 or 1). 컴퓨터의 CPU 에 따라서 이게 결정이 되는데, 우선은 이진법에 대해서 간단히 다루겠습니다.
이진법
0 과 1 으로만 숫자를 표현하는 방식이며 이것은 컴퓨터의 전기 신호가 켜졌는지 (1) 아니면 꺼졌는지 (0) 에 따라서 정보를 다루게 됩니다. 하나의 신호를 보통은 bit 이라고 하며, 다음 예시를 보면 이해하기 편할겁니다.
표현할 숫자 (10-진법 기준) : 5=1+4=20⋅1+21⋅0+22⋅1
신호
20
21
22
1
O
X
O
0
X
O
X
값
20⋅1=1⋅1=1
21⋅0=2⋅0=0
22⋅1=4⋅1=4
지금의 경우에는 3 bit 만 사용했기에 23−1=8−1=7 까지 숫자를 표현하는게 가능합니다.
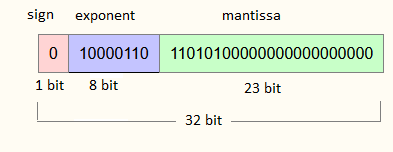
디지털 컴퓨터들의 경우 다음과 같은 숫자 표현들을 사용한다고 합니다. (128-bit 는 사용하기에는 비효율적)
Bits
32-bit (Single Precision)
64-bit (Double Precision, 요즘 컴퓨터들 맥 등등)
Sign
0
0
Exponent
1−7
1−11
Mantissa
8−31
12−63
그리고 Capacity 는 다음과 같습니다.
32-bit
64-bit
128-bit (Quadruple Precision)
Decimal Digits
7.22
15.95
34.02
Decimal E max
38.23
307.95
4931.77
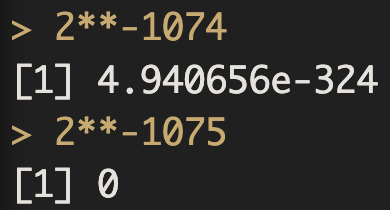
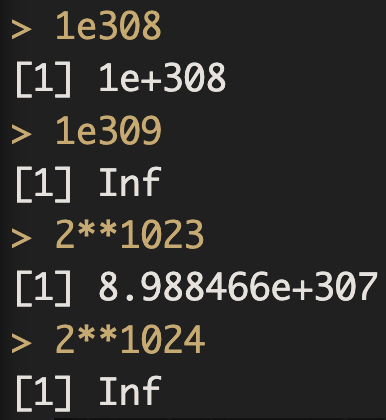
Capacity 를 넘게 된다면 Overflow / Underflow 문제가 발생하게 됩니다. 이를 방지하기 위한 방법들이 굉장히 많지만, 우선은 아래 내용을 진행하겠습니다.
그렇다면 소수들은 이 bit 를 이용해서 어떻게 표현할까요? → Exponent & Mantissa
Mantissa 표현법
Fixed-Point Representation (고정소수점) 이 있으며 Floating-Point Representation (부동소수점) 이 있습니다.
Fixed-Point Representation 의 경우 매 숫자마다 소수점을 미리 정해진 위치에 고정을 시켜줍니다.
Floating-Point Representation 의 경우 매 숫자마다 소수점 위치를 지수에 따라서 변형시켜줍니다.
예시로 숫자 75.31 이 있다고 하겠습니다.
이 숫자를 Fixed-Point Representation 으로 표현하면 똑같이 75.31 이 됩니다.
반면에 Floating-Point Representation 으로 표현하면 0.7531E02=0.7531⋅102 으로 변형됩니다.
둘다 똑같은 값이며 그저 표현의 차이가 있을 뿐입니다. 그러면 부호 그리고 Mantissa 는 뭘까요?
부호의 경우에는 + 아니면 − 으로 둘 중에 하나이며, 이것도 Binary 으로 하나의 bit 으로 표현해주면 됩니다.
그러면 64-bit 기준에서 1개의 bit 는 부호로 사용되기에 63 개로 이제는 표현해줘야 합니다. 이때 저희는 Floating-Point Representation 을 따르기에 먼저 숫자를 0.7531E02 으로 바꿔줍니다.
E 뒤의 값들은 Exponent 으로 곱해줘야 하기에 이 값을 표현하기 위해서 비트를 11 개를 또 할당시켜줍니다.
이때 함정이 있다면 실제로 곱해지는 것은 10e 가 아니라 2e 입니다.
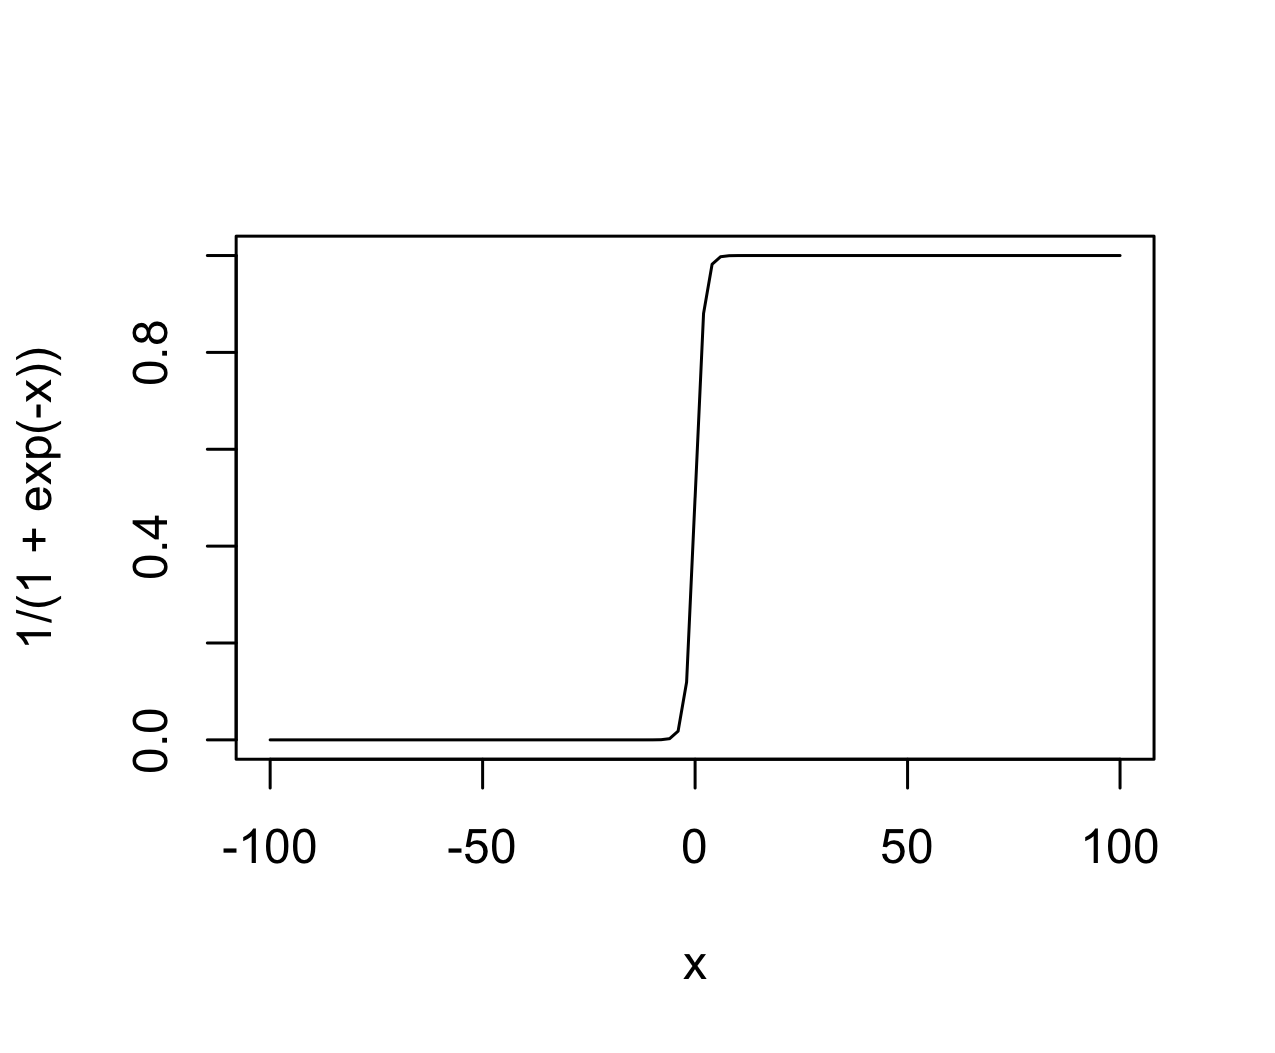
추가적으로 e 의 값이 음수가 될 수도 있기에 원래는 11 개로 0−2047 까지 표현할 수 있지만, Bias Term 을 중앙값 (1023) 으로 넣어줘서 −1023∼1023 까지 표현해줄 수 있게 됩니다.
Bias 를 안쓰고 e 의 첫번째 비트를 부등호로 바꿔서 위와 같이 똑같이 표현해주는 방식도 존재합니다.
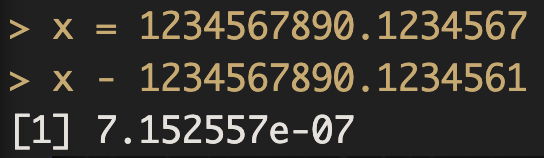
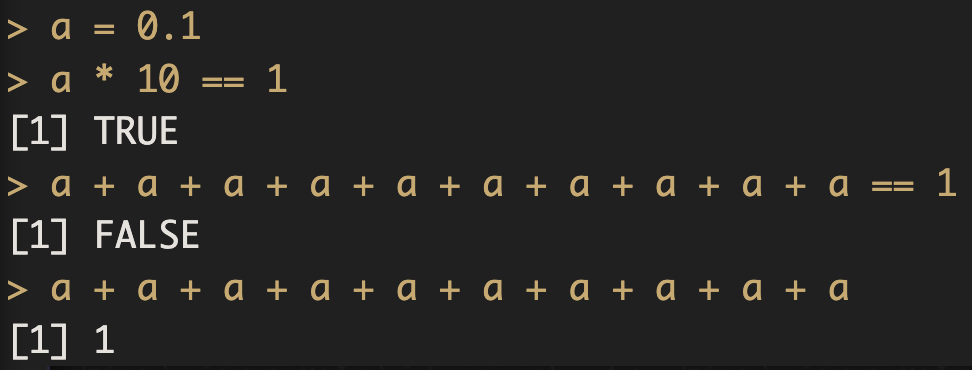
Representation Error : 컴퓨터는 사실 유리수를 잘 표현하지 못합니다. 그렇기에 늘 근사를 합니다. 0.1 와 같은 단순한 숫자도 64-bit 기준으로는 0.000110011⋯2 으로 표현이 됩니다. 그럼에도 불구하고 이 숫자를 표현하기 위해서는 끝자락에서 반올림을 시켜서 진행을 합니다. 즉 늘 실제 값이랑 컴퓨터가 표현한 값에는 Representation Error 가 존재한다는 것입니다 (딱 떨어지지 않는 이상).
예시로 0.1+0.1+0.1+0.1+0.1+0.1+0.1+0.1+0.1+0.1==1 을 R 코드에서 치면 FALSE 가 나오게 됩니다.
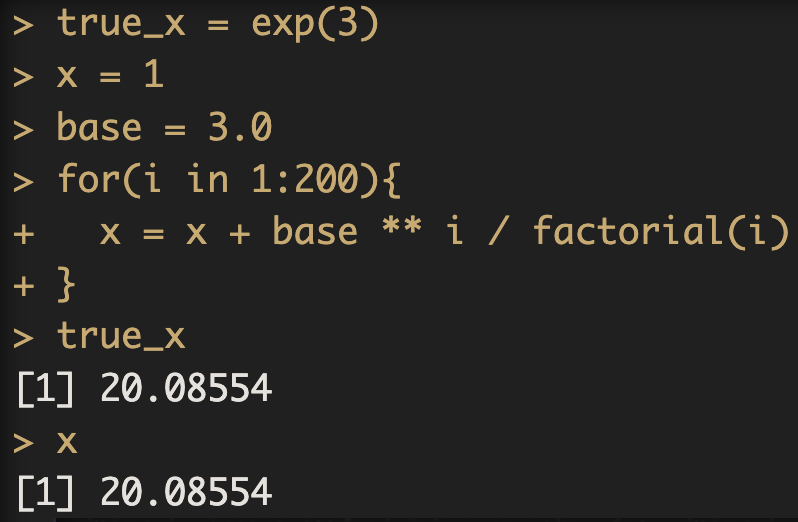
Truncation Error : 유리수도 표현 못하면 무리수도 당연하게 표현을 못합니다. 무리수들의 경우에는 그래서 Taylor Series 와 같은 것을 활용시키며, 이 값은 어느 시점 부터 Truncate 이 됩니다. 이때 Truncate 을 잘못하게 된다면 실제 값이랑 오차가 생기는 수밖에 없습니다.
Examples of Computation Error in R
Log-Exp Sum Trick
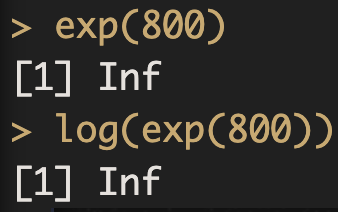
우선은 Overflow 와 Underflow 문제가 뭔지부터 파악해야됩니다. 앞서 저희는 Mantissa 표현이 어떻게 되는지에 대해서 알아보았으며, 이를 활용한다면 Overflow 와 Underflow 는 다음과 같이 정의가 가능합니다.
Overflow : Mantissa 으로 표현할 수 있는 최대 숫자보다 값이 클 때 생기는 에러
Underflow : Mantissa 으로 표현할 수 있는 최대 숫자보다 값이 작을 때 생기는 에러
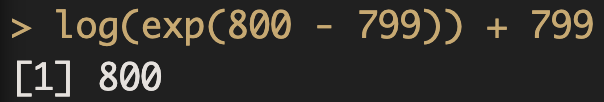
생각보다 자주 일어나지는 않지만, 일어나더라도 해결할 수 있는 방안들이 많으며, 이 중에서 하나가 바로 Log-Exp Sum Trick 입니다. 로그와 exp 성질을 활용하면 다음과 같이 쓸 수 있습니다.
근데 이게 유용한 점이, 로그 안에서 Summation 값을 구하는데에도 유용해지게 됩니다.
log(i=1∑mexp(xi))=c+log(i=1∑mexp(xi−c))
이때 보통 c 의 값은 c:=maxi∈[m]xi 으로 정해지게 됩니다.
예시로는 다음과 같이 활용할 수 있게 됩니다.
Random Number Generators
랜덤한 숫자를 생성하기 위해서는 어떻게 해야할까요?
물리적인 세상에서의 예시로는 주사위, 로또, 카드 썪기 등등의 방법들을 생각할 수가 있습니다. 하지만 모든게 계산으로 이뤄지는 전산에서는 결국에는 알고리즘을 활용해야됩니다.
이에 대한 예시를 Middle-Square Method, Linear Congruential Method 들이 존재합니다. 이때 RNG 가 가져야할 조건들이 다음과 같습니다.
원하는 조건
실제 방법
균일 분포와 통계적으로 똑같은가
통계 검정으로 확인
효율적인가
단순한 산술 연산만 사용
일부로 특정 값이 나올 수가 있나 (Reproducible 한가), R 에서는 set.seed 통해서 가능
초깃값(seed)을 고정
Middle-Square Method
컴퓨터의 아버지이신 완전 말도 안되는 천재 John von Neumann 님이 만드신 너무나도 간단한 방법입니다. 그렇기에 사실 현대 사회에서는 아쉽게도 사용되기 애매합니다.
2 자리 RNG using Middle-Square Method
두자리 초깃값을 x 라 하기.
x 를 제곱시켜서 4자리 수 만들기. 이때 앞자리가 빈다면 0 으로 채워주기.
x 의 중간 숫자 2개를 다음 랜덤 숫자로 만들기.
x <- 어떤 2-Digit 초깃값
x <- x ** 2 # 제곱을 시켜주며 4-Digit 으로 바꿔줌, 4자리수가 안된다면 0 을 붙여준다.
x <- x[2:4] # 근데 사실 이건 R 코드에서 안되기에 % 를 활용하면서 이거를 해줘야함.
cat("새로운 숫자는 ", x)
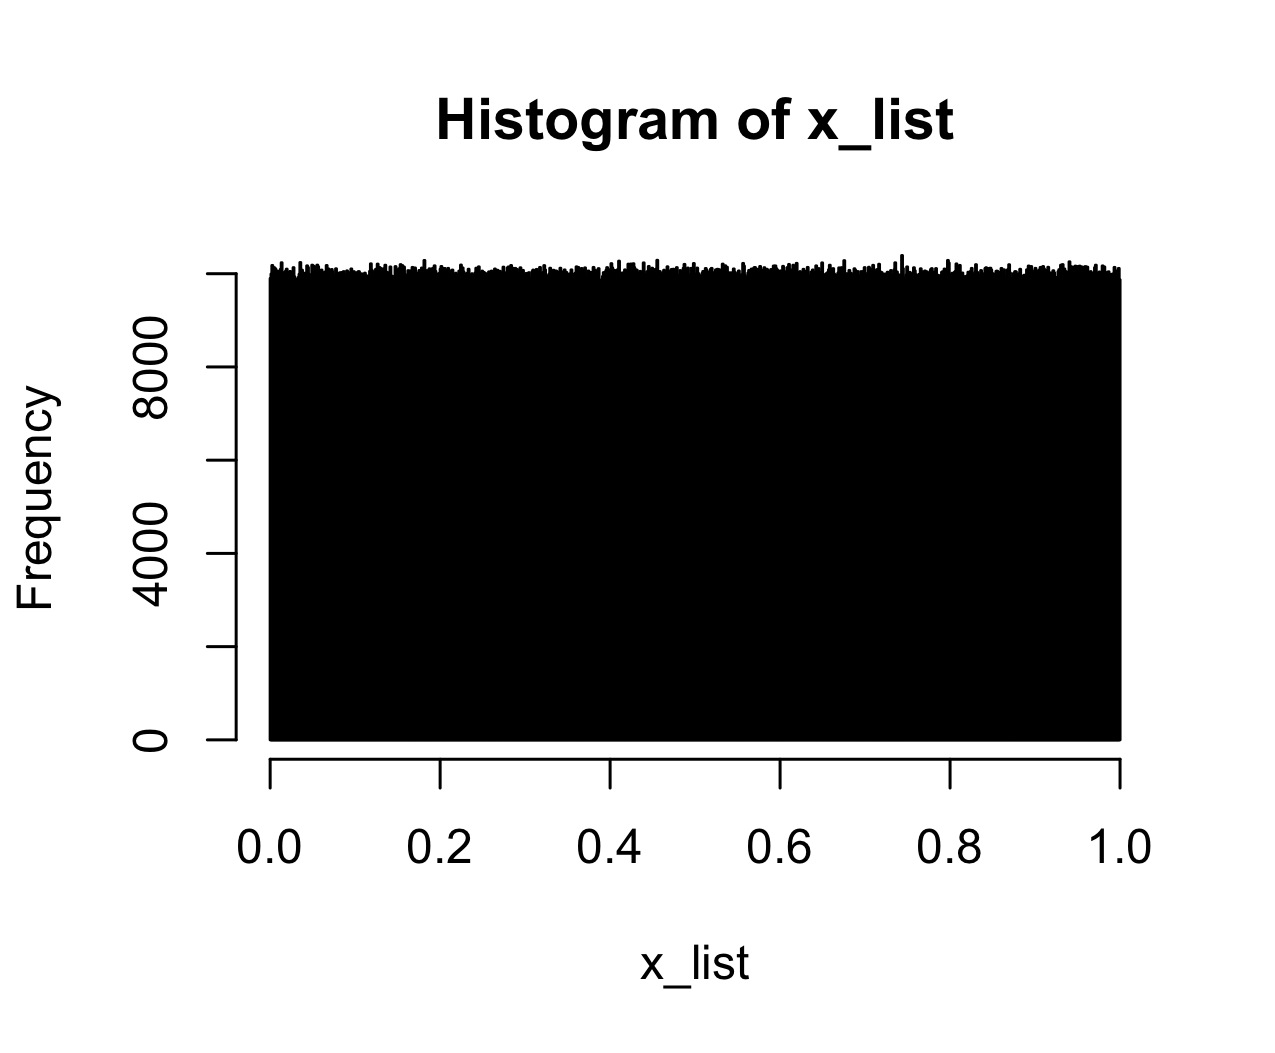
4 자리로 늘렸을 때 나오는 Histogram 입니다.
뭐가 문제점일까요? 바로 Loop 입니다. 예시로 3317 의 값을 초깃값으로 주었다고 해보겠습니다.
이러한 문제점이 이 Middle-Square Method 에 존재하며, 초깃값에 따라서 어떨 때는 RNG 의 역할을 못할 때도, 어떨 때는 괜찮게 수행할 때도 있습니다.
Linear Congruential Method
1958 년도에 만들어진 RNG 이며 가장 영향력이 큰 RNG 기법 중에서 하나입니다. 방식은 다음과 같습니다.
X0,A,C,M 을 먼저 고른다.
Xt←(AXt−1+C)modM
2 번을 계속해서 반복해준다.
이때 이 방법의 특징들이 있는데, 이는 다음과 같다.
이론적으로 최대 Period 는 M 이다 (값들만 잘 정해준다면).
Xt 에 추가시키기 전에 값을 M−1 으로 나눠주면 0∼1 사이의 값이 나오게 된다.
처음 값들을 잘 설정만 해준다면 균일분포처럼 나오게 된다.
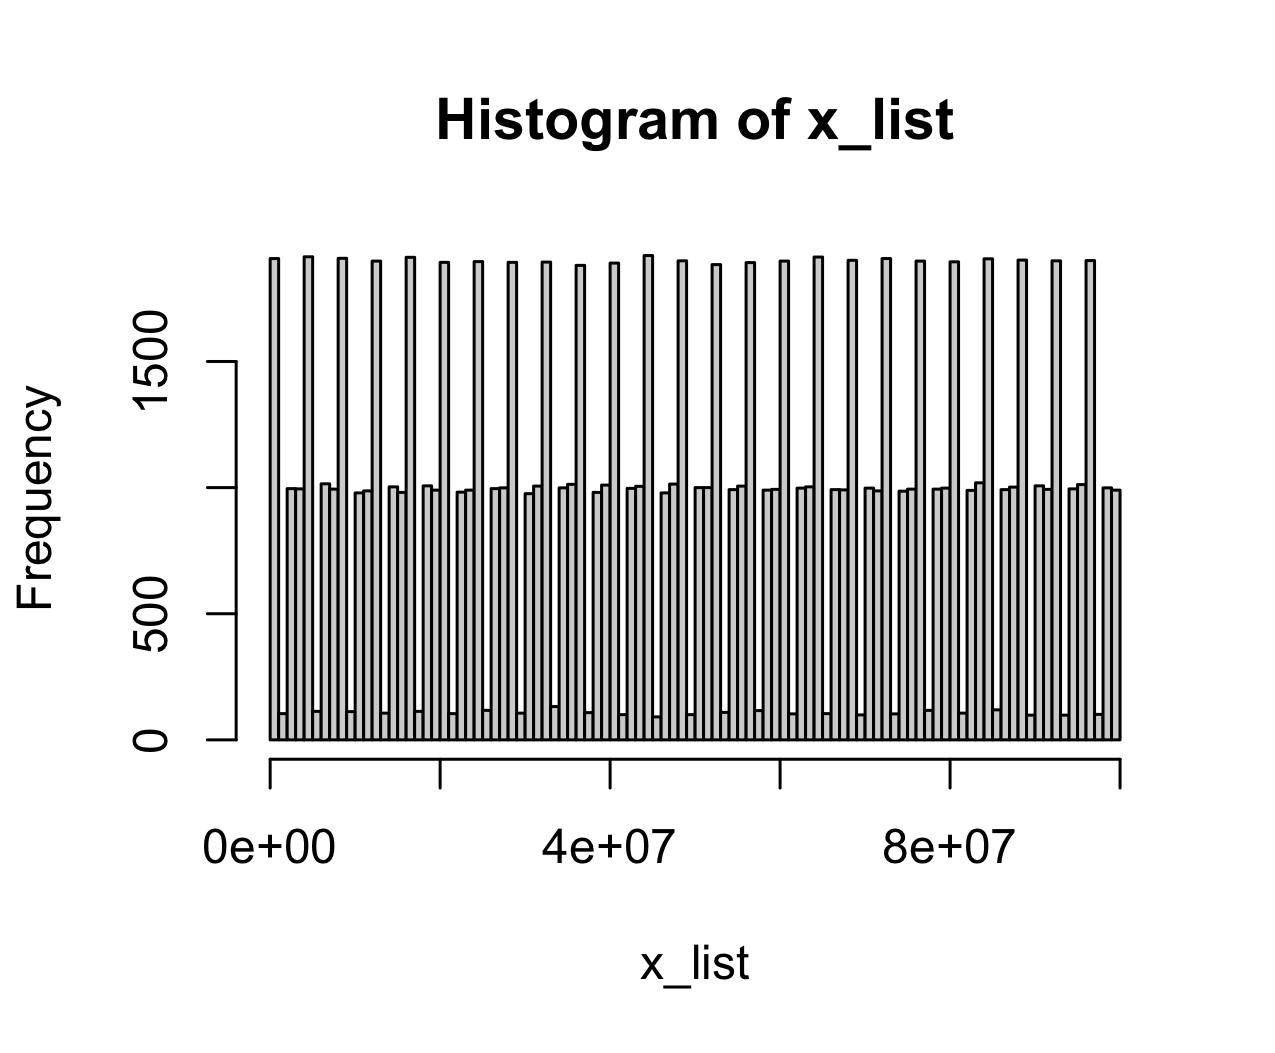
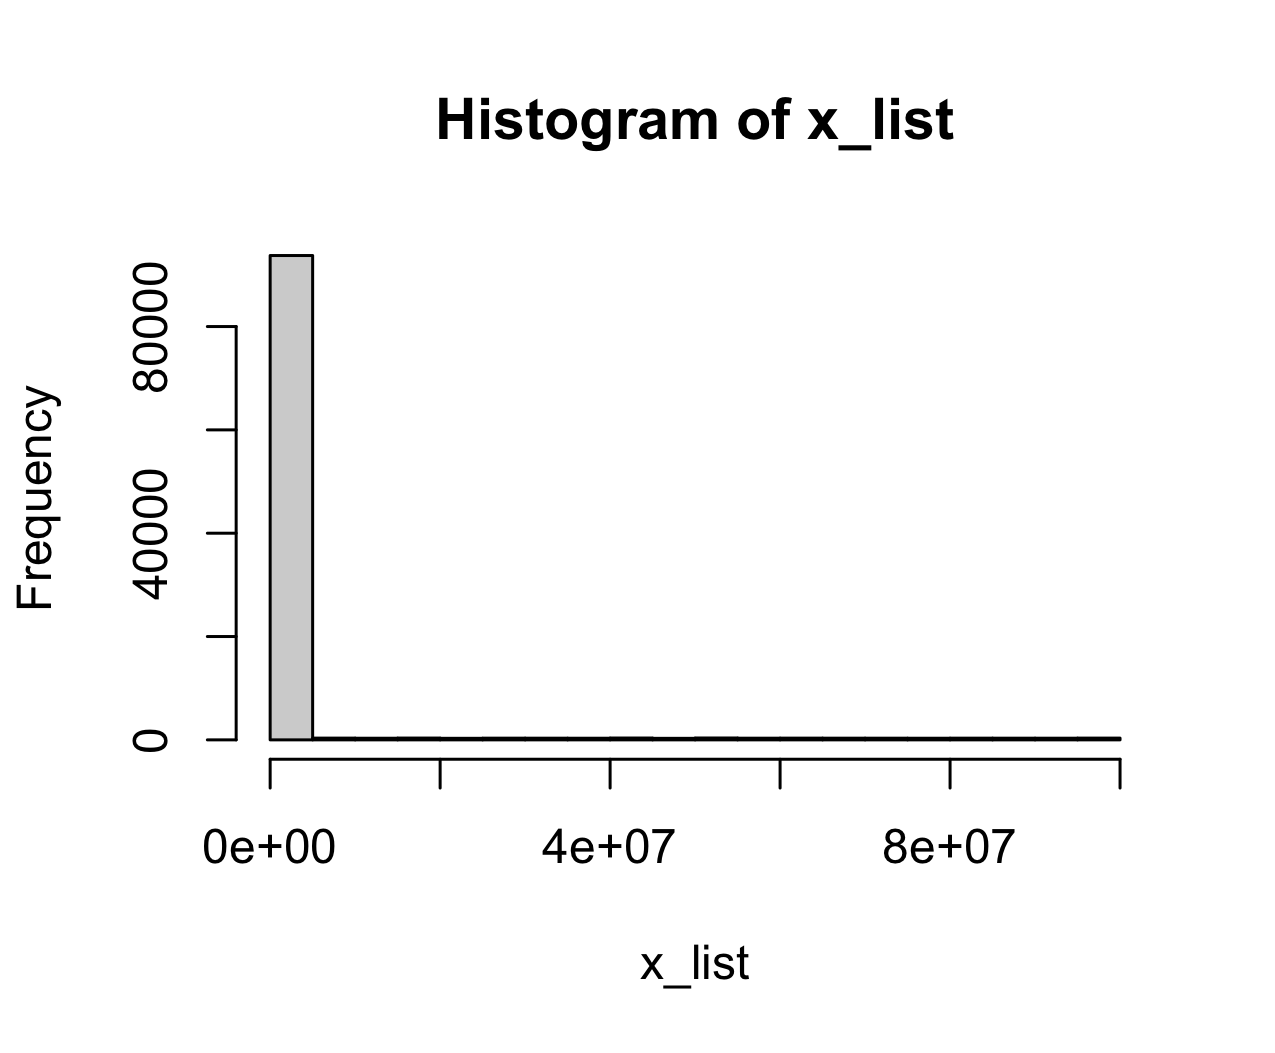
그럼 예시 결과를 한번 보겠습니다.
C = 59049, M = 34341, A = 2345, N = 10000000
C = 3^10, M = 2^32, A = 7^6, N = 10000000
보이시는 바와 같이 값들을 잘 선정하게 된다면 오른쪽과 같이 거의 균일분포의 모습을 띄우게 됩니다.
그러면 저희가 구현한 RNG 가 진정한 RNG 인 Unif(0,1) 과 같은 분포를 갖게 된다는 확인을 어떻게 할까요?
Statistical Tests for Uniformity
검정 기법들
χ2-goodness-of-fit test
Kolmogorov-Smirnov test
Double-Root Residual
그래프 기법들
히스토그램 (Histogram)
Probability Plot
QQ-Plot
runif(⋅) 도 사실은 완전히 랜덤한 RNG 는 아니지만, 사용하기에 부족함이 없다.
Monte-Carlo Integral
적분의 경우 전산적으로 어떻게 계산할까요? 그것을 알기 위해서는 적분에 대해서 잠깐 얘기해보겠습니다.
y=∫01f(x)dx
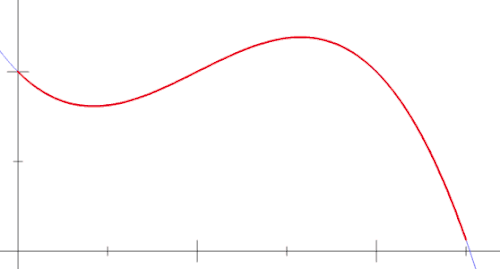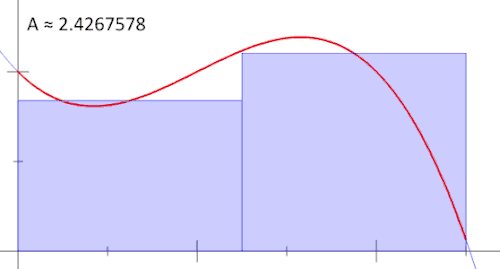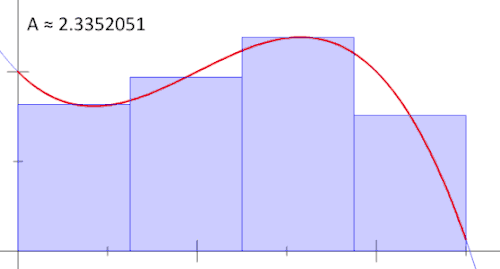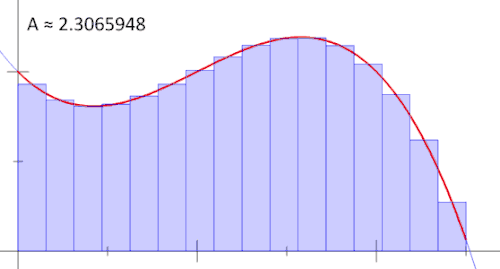
위와 같은 적분 값이 있다고 하겠습니다. 그러면 이때 f(x) 가 어떻게 생겼는지에 따라서 저희는 그저 손으로 적분도 할 수 있으며 너무 어렵다면 적분이 손으로는 현실적으로 불가능한 경우도 존재합니다. 그렇기에 저희는 이 적분 값을 근사 시켜주면 되며, Riemann Integral 를 활용하는 Numerical Integration 방법도 있지만 이 강의의 대부분은 Monte-Carlo Integration 방법을 사용한다고 보시면 됩니다.
위의 적분값을 다음과 같이 조금 다르게 해석해보겠습니다.
y=∫01f(x)dx=∫011−01⋅f(x)dx=E[f(U)],U∼Unif(0,1)
수식적으로 틀린 것은 지금까지 아무 것도 없습니다. 즉 다시말해 근사를 한 것은 아무것도 없습니다. 하지만 이때 여기서부터 저희는 Monte-Carlo Integration 을 적용시켜줍니다.
Law of Large Numbers
대수의 법칙으로도 알려져 있으며, 이것을 알기 위해서는 우선은 X1,X2,⋯,Xn∼i.i.df(x;θ) 이라고 정의하며, 특징으로는 E[Xi]=μ,Var(Xi)=σ2 이라고 하겠습니다.
추정량을 Xˉn=n1∑i=1nXi 으로 정의하겠습니다. 그러면 다음과 같이 말할 수가 있습니다.
ㄹ이 방식을 이용해서 적분값을 추정하는 것이 바로 Monte-Carlo Integral 입니다. 당연하게도 지금의 경우에는 x∈(0,1) 이라는 아주 간편한 구간 내에 있기 때문에 이렇게 쉽게 이해가 될 수 있지만, 이것이 x∈(a,b), x∈(0,∞), x∈(−∞,∞) 등의 구간에서도 활용이 충분히 가능합니다.
x∈(a,b) 인 케이스
Change of Variables 를 적용시키면 됩니다. 예시로 위와 같은 Notation 으로 다음과 같은 상황을 고려해보겠습니다.
y=∫abf(x)dx
이때 저희가 u:=b−ax−a,z∈(0,1) 으로 두며 Jacobian 은 ∣J∣=dudx=∣b−a∣ 으로 세팅한다면 다음과 같이 적분식이 변하게 됩니다. p.s. x=a+(b−a)⋅u,
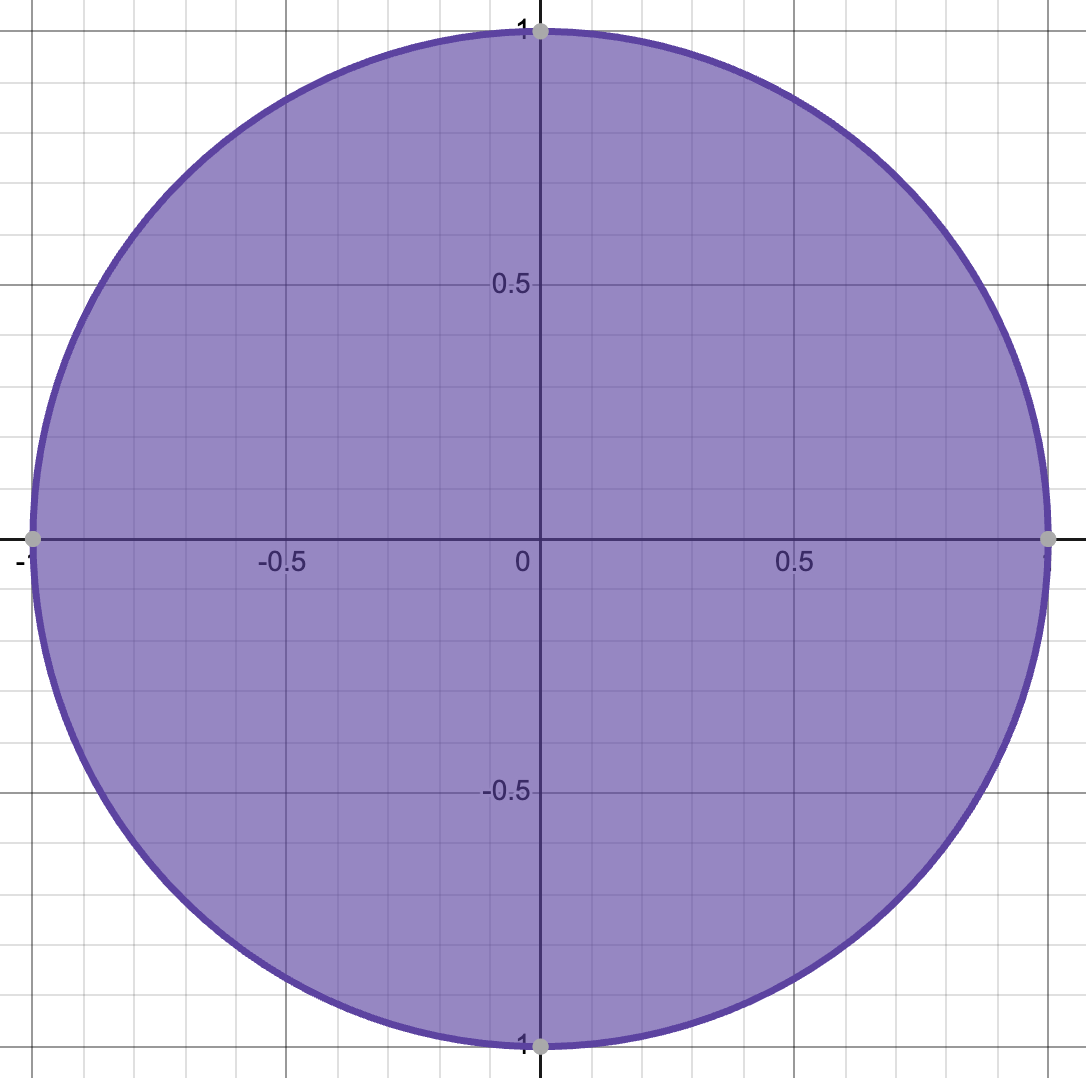
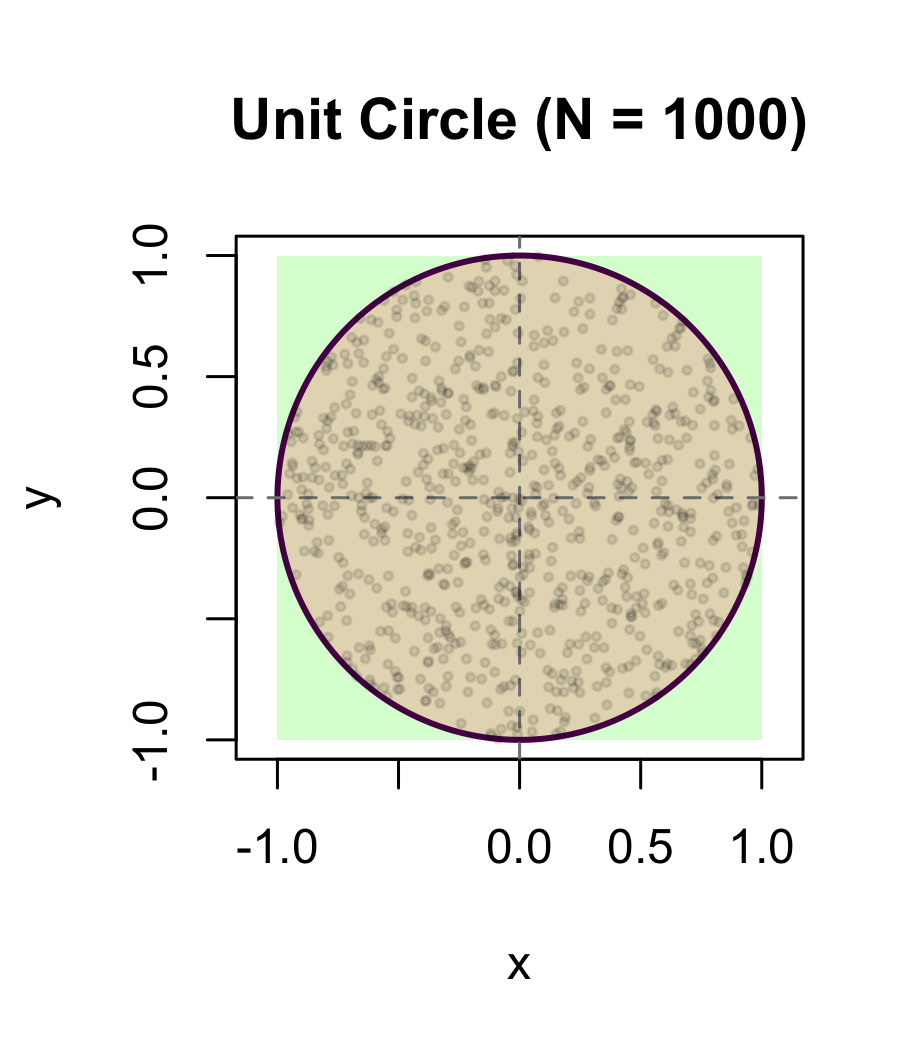
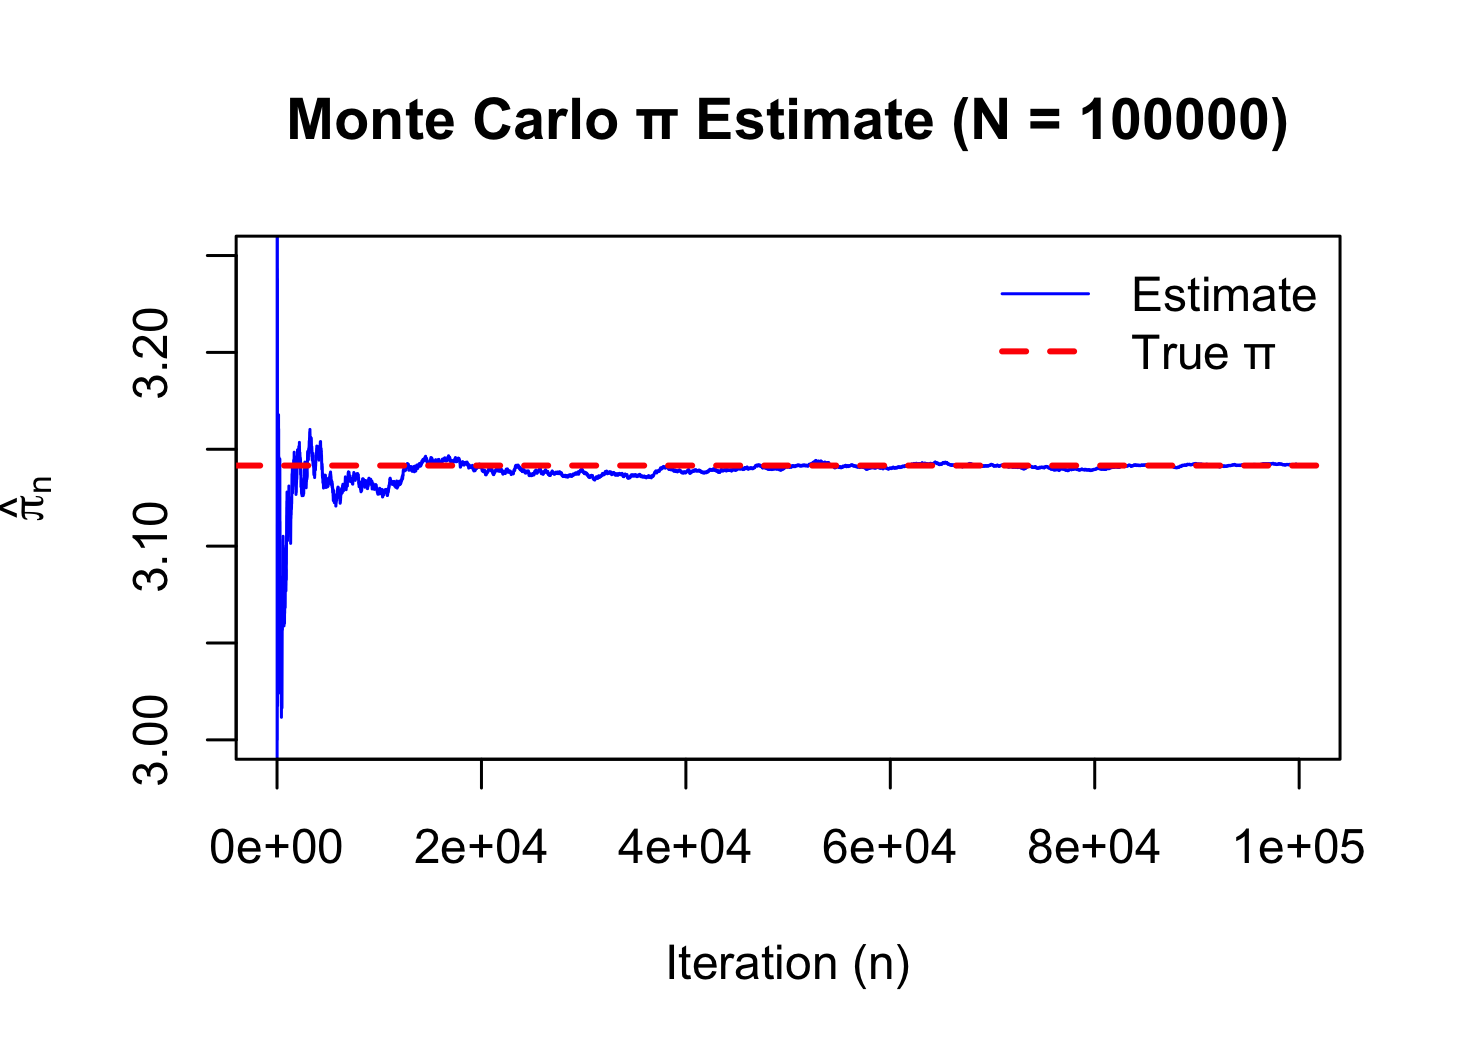
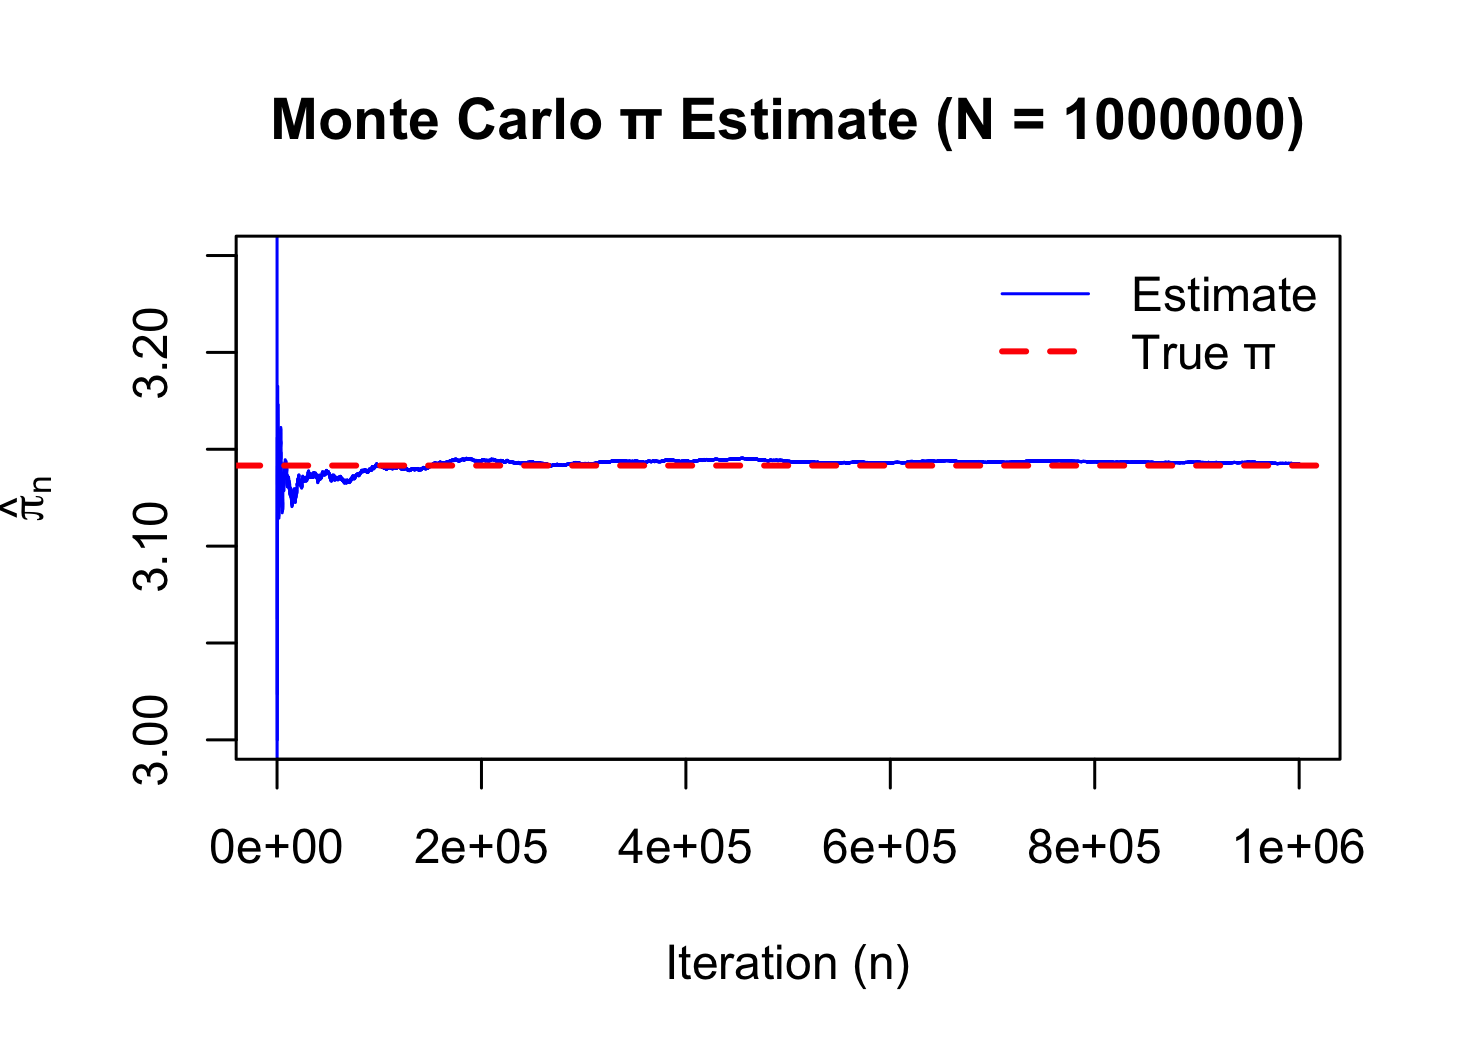
그렇다면 실제로 적용시킬만한 좋은 예시가 무엇이 있을까요? 바로 π 값을 구하는 것입니다. 동그라미의 넓이는 초등학생도 알다시피 A=πr2 입니다. 그렇다면 이 동그라미를 (−1,1)2 에 그려보면 어떻게 나올까요?
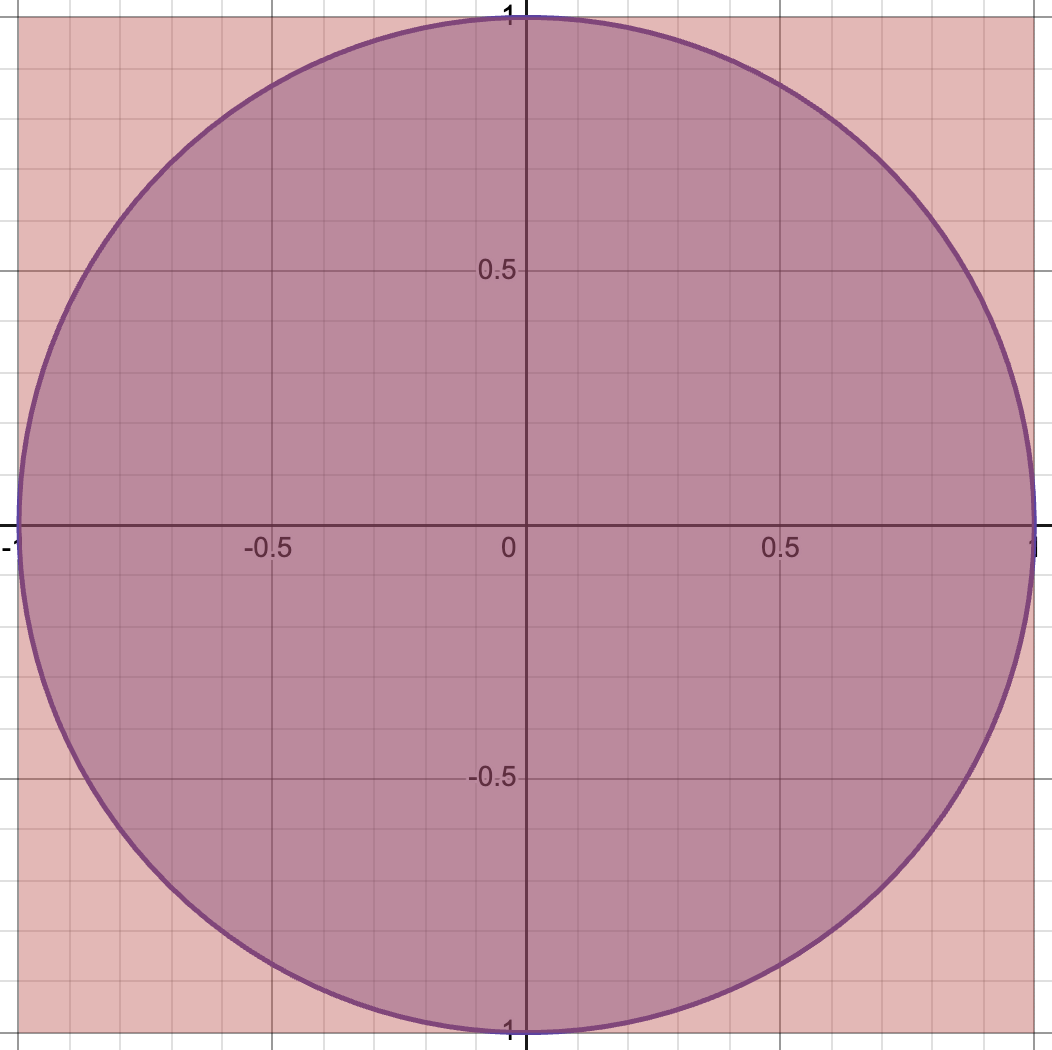
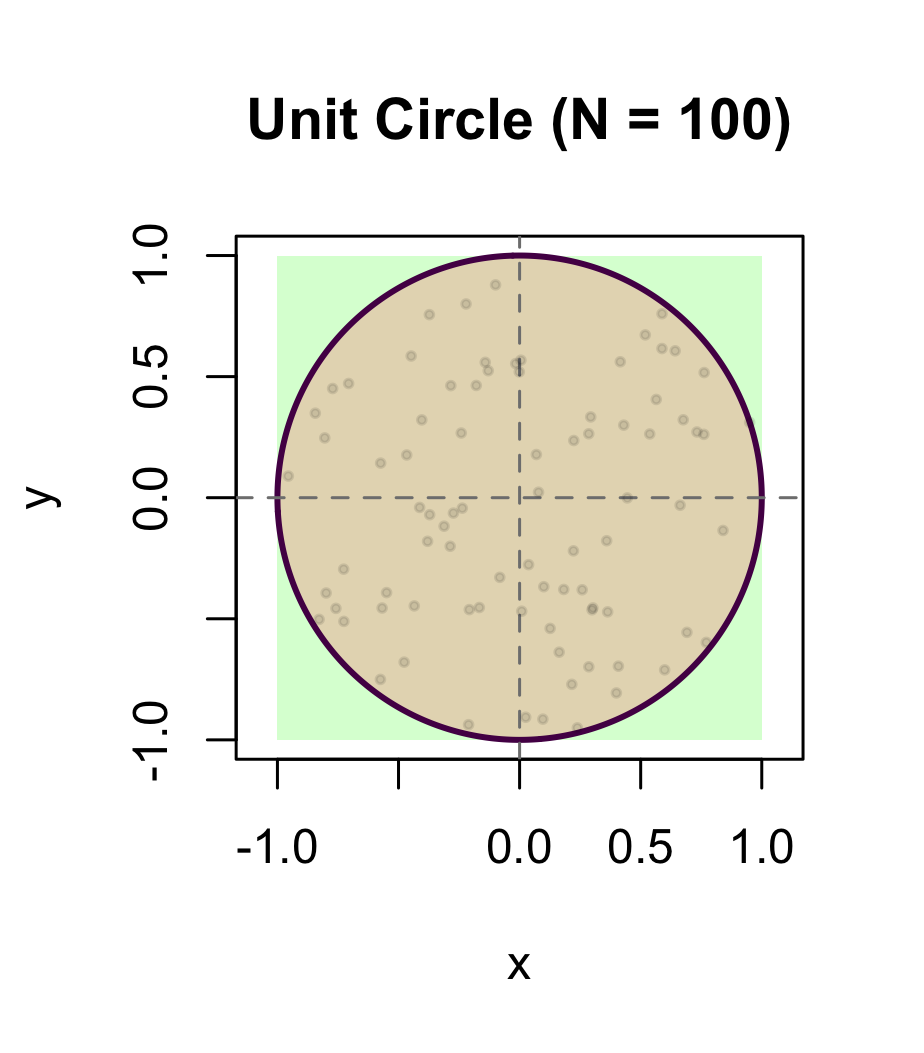
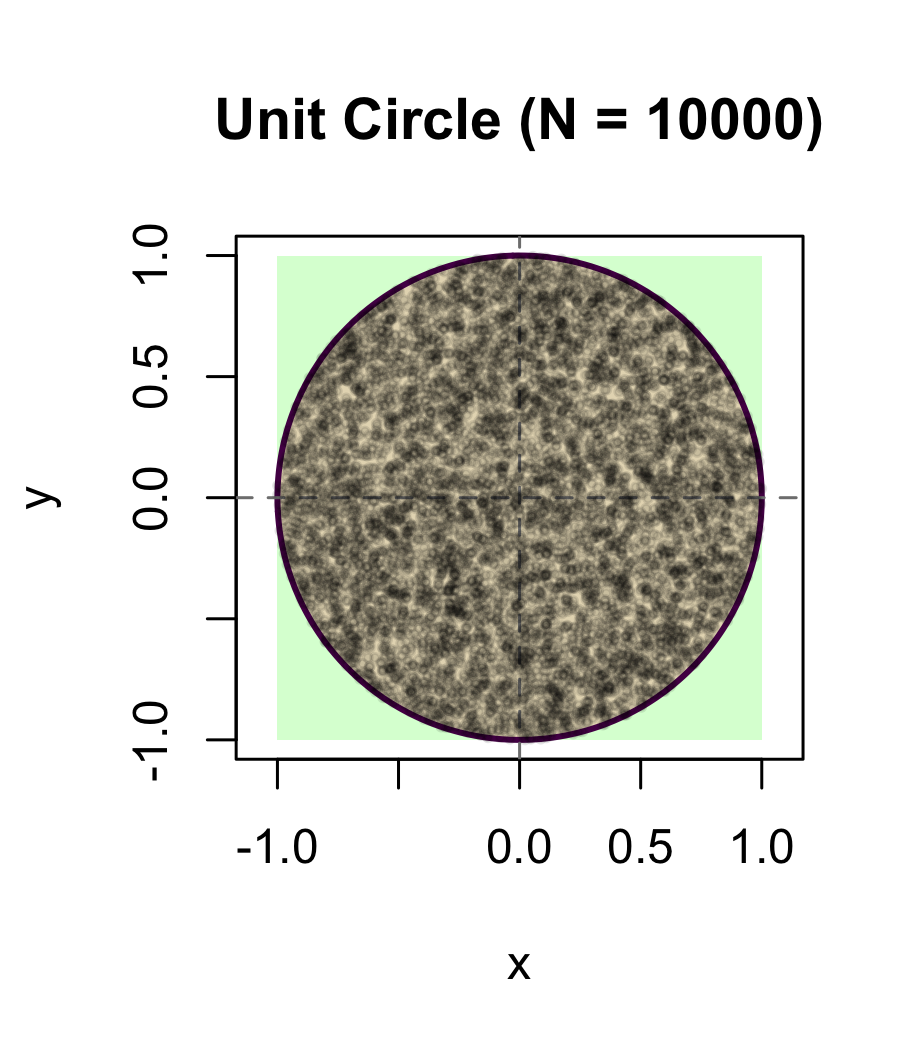
보라색 구역의 경우 x2+y2≤1 의 구역을 그대로 그린 것입니다. 동그라미 넓이에 포함되는 구역을 구했으니, 이제는 균일분포를 활용시켜야합니다. 이때 저희가 알 수 있는 것은 원을 둘러싸는 정사각형이 (−1,1)2 전체이며, 정사각형 내에서 아무 곳을 샘플하려면 그저 독립된 균일분포에서 한번 샘플하면 끝납니다.
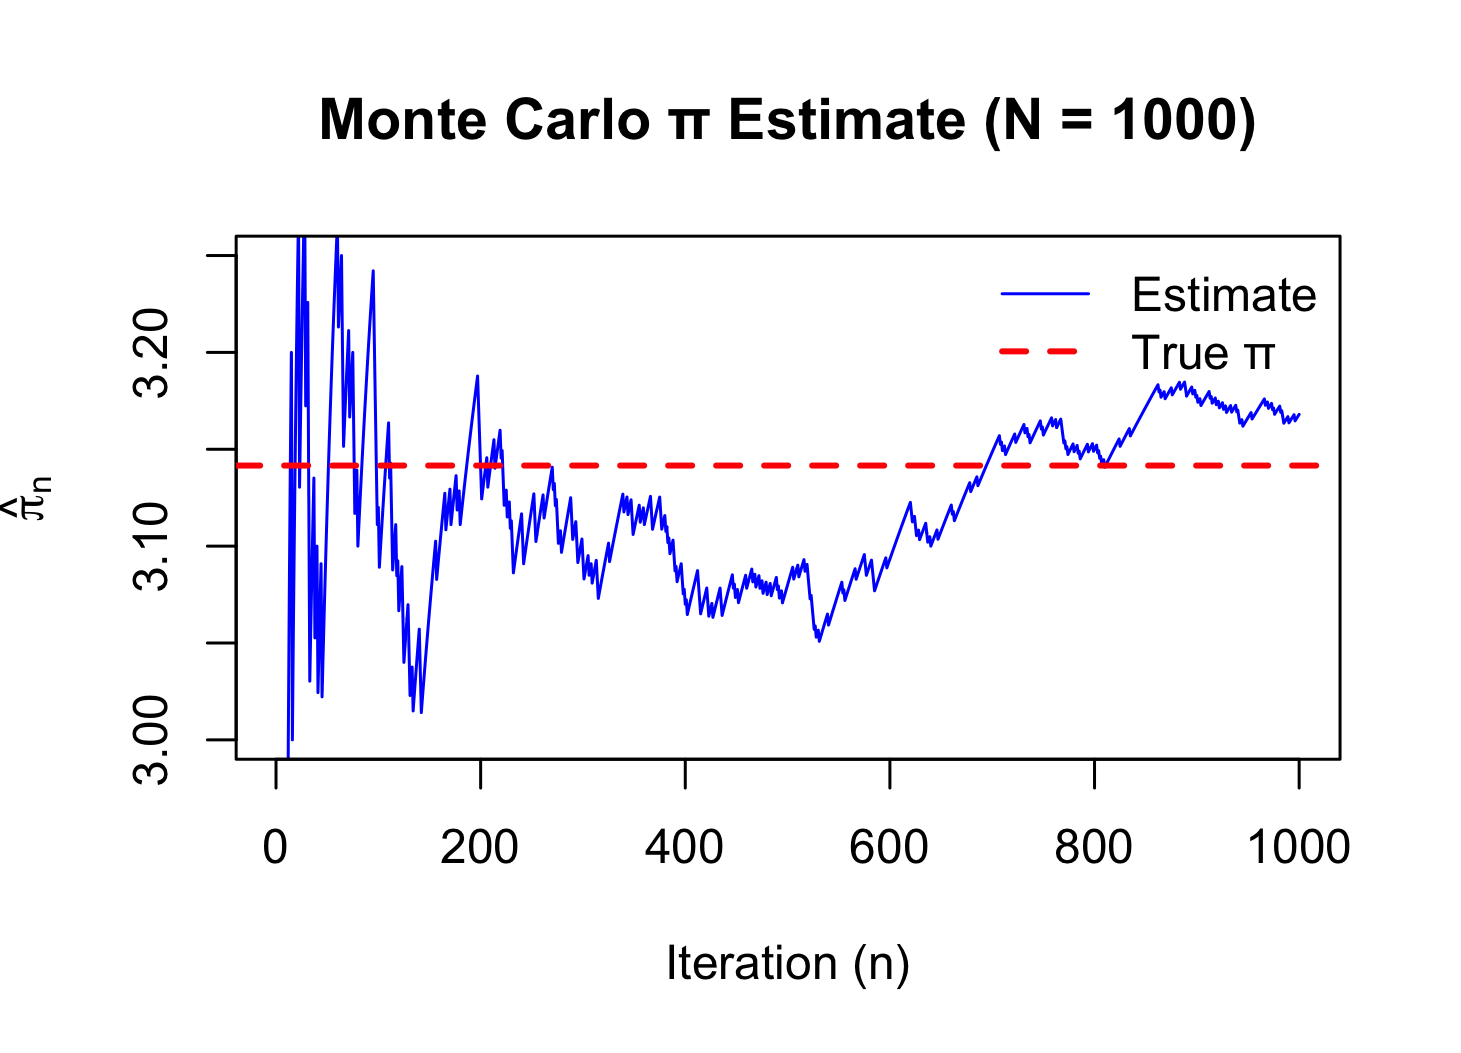
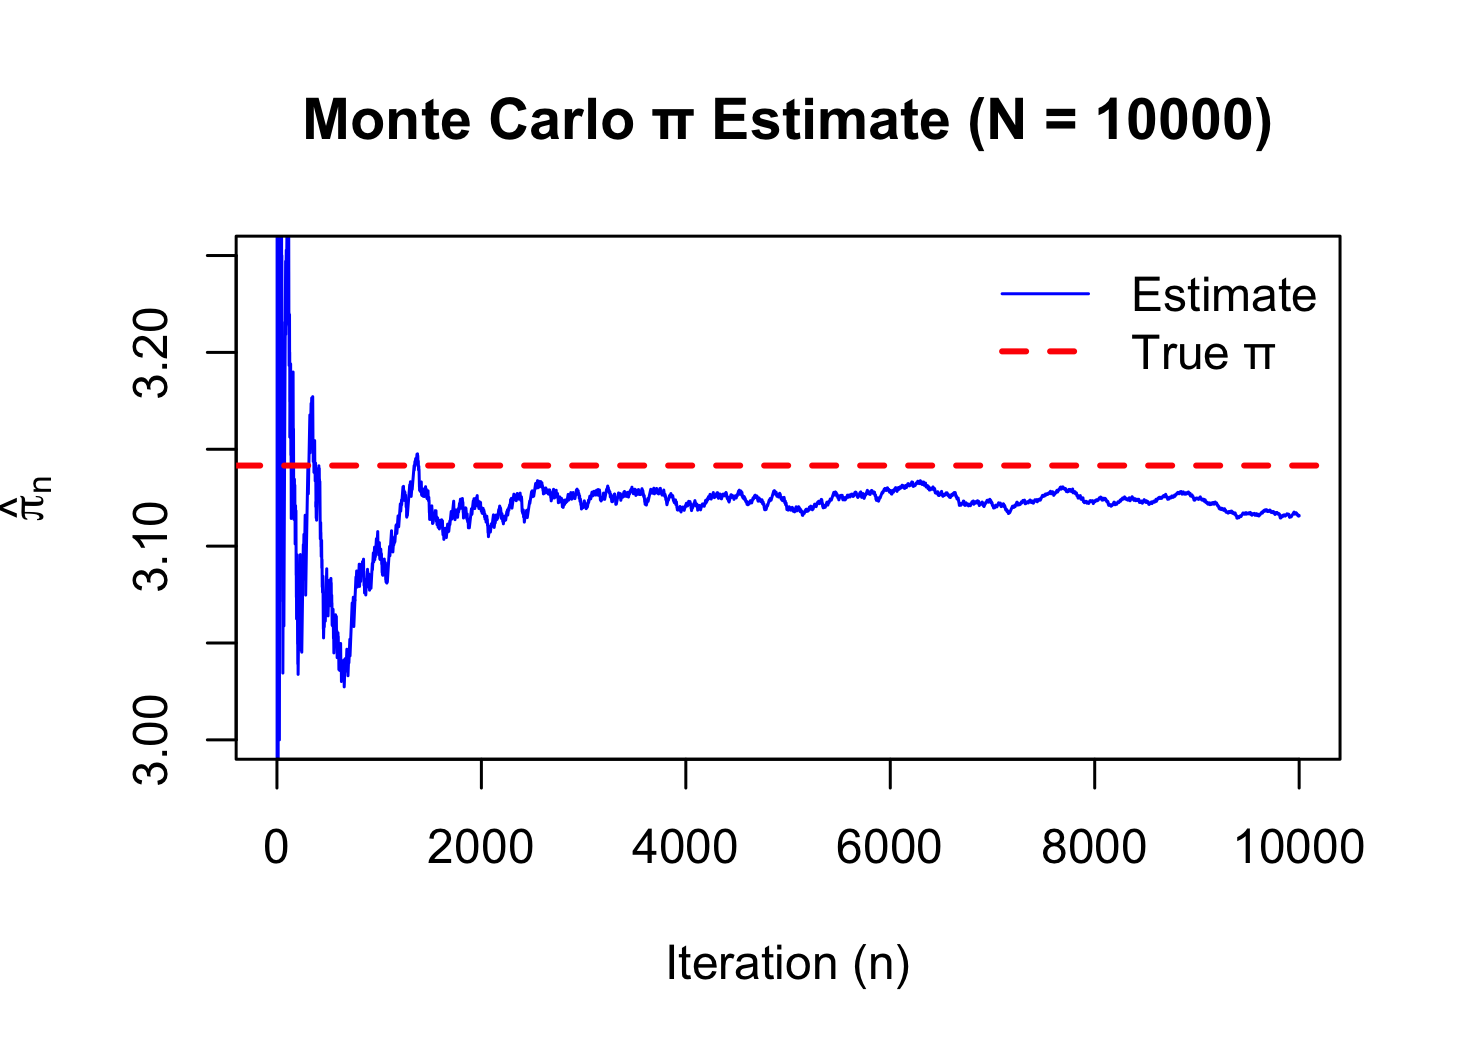
그림에서의 원의 넓이는 그러면 r=1 이기에 Acircle=πr2=π 이며, 정사각형의 넓이는 Asquare=(1−(−1))2=22=4 입니다. 그러면 정사각형 아무데나에서 샘플을 했을 때 좌표가 동그라미 안에 들어갈 비유는 다음과 같습니다.