1장에서 얘기한 바와 같이, 저희는 이미 어떻게하면 U∼i.i.dUnif(0,1) 에서 뽑을지 알고 있습니다. 하지만 이것을 활용해서 저희가 원하는 분포에서 뽑으려면 어떻게 해야 할까요? 그것에 대한 가장 간단한 1-차원 수준에서 뽑는 것이 2장에서 얘기하는 바입니다. 이것을 해결해주는 아주 간단한 방법이 3가지가 있으며, 그것들은 바로 Inverse-Transform Method, Acceptance-Rejection Method, 그리고 Transformation of Random Variables 가 있습니다.
Inverse-Transform Method
어떠한 Non-decreasing 함수 h:X→Y 가 있다고 하겠습니다. 이 함수의 Inverse 함수의 General Form 은 다음과 같이 나오게 됩니다.
∀y∈Y,h−1(y)=inf{x∈X:y≤h(x)}
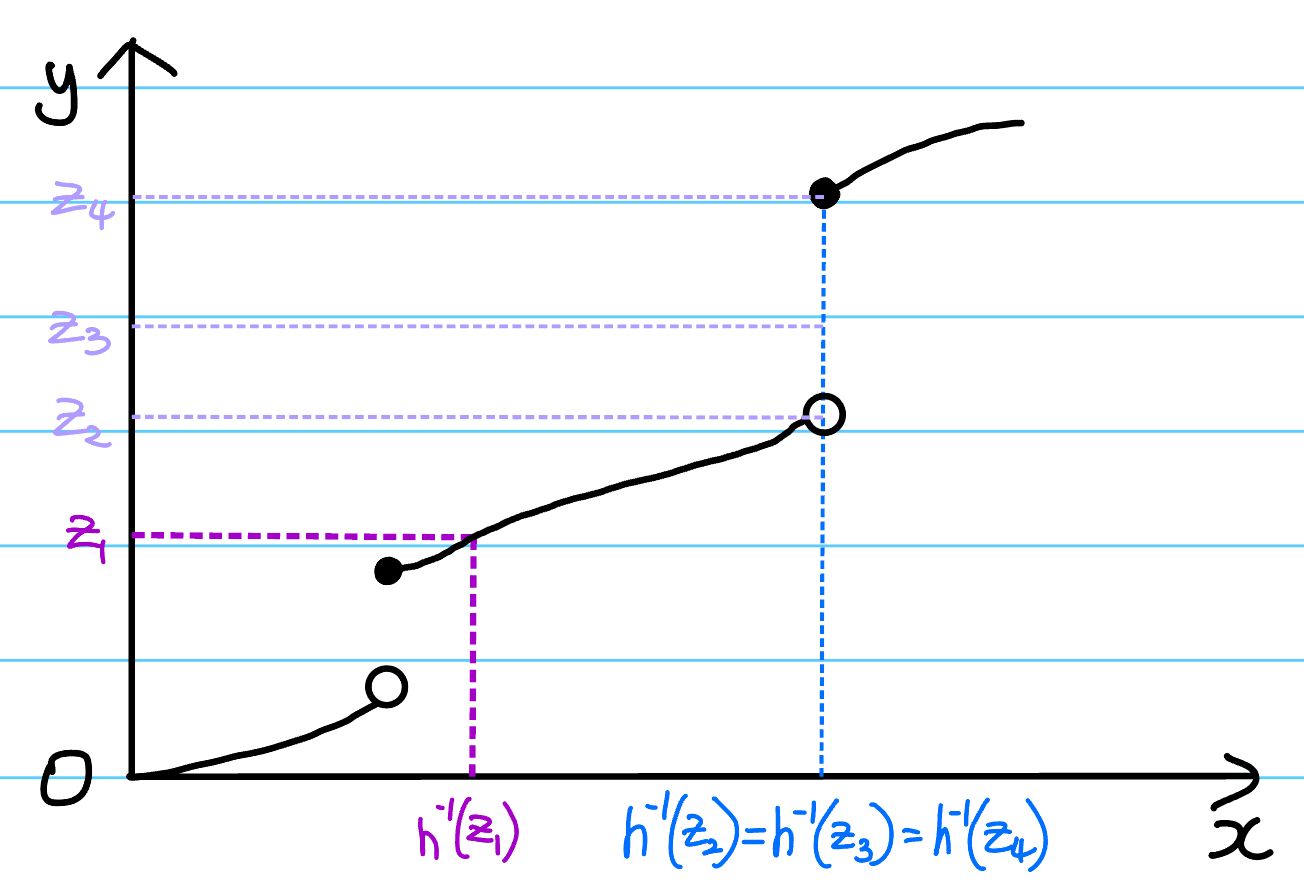
이게 의미하는 바는 무엇이냐면, 어떠한 Non-decreasing 함수 h(x) 가 있으며 이것은 때로는 Jump 가 생길 수도 있습니다. 그 점들을 고려하기 위해서 inf 을 넣어주게 됩니다. 아래 사진을 보겠습니다.
여기에서 z2, z3, z4 에 해당되는 x 값들은 다 똑같습니다. 즉 h−1(z2)=h−1(z3)=h−1(z4) 입니다. 해석을 하자면, z3 보다 큰 h(x) 값은 z4 이상 밖에 없습니다. 그렇기에 그것의 Local 최솟값 인 inf (물론 inf 의 정의는 다르긴 하지만) 으로 잡는다면 z3 에 대한 Inverse 값을 h−1(z4) 으로 둘 수 있습니다.
이제는 이 h 함수를 cdf 함수 F 으로 바라보겠습니다. F 의 경우 Non-decreasing 하다는 특징이 있으며, 만약에 F 에 대한 역함수가 존재한다면, 다음과 같이 세팅해줄 수 있습니다.
X=F−1(U),U∼Unif(0,1),X∼F
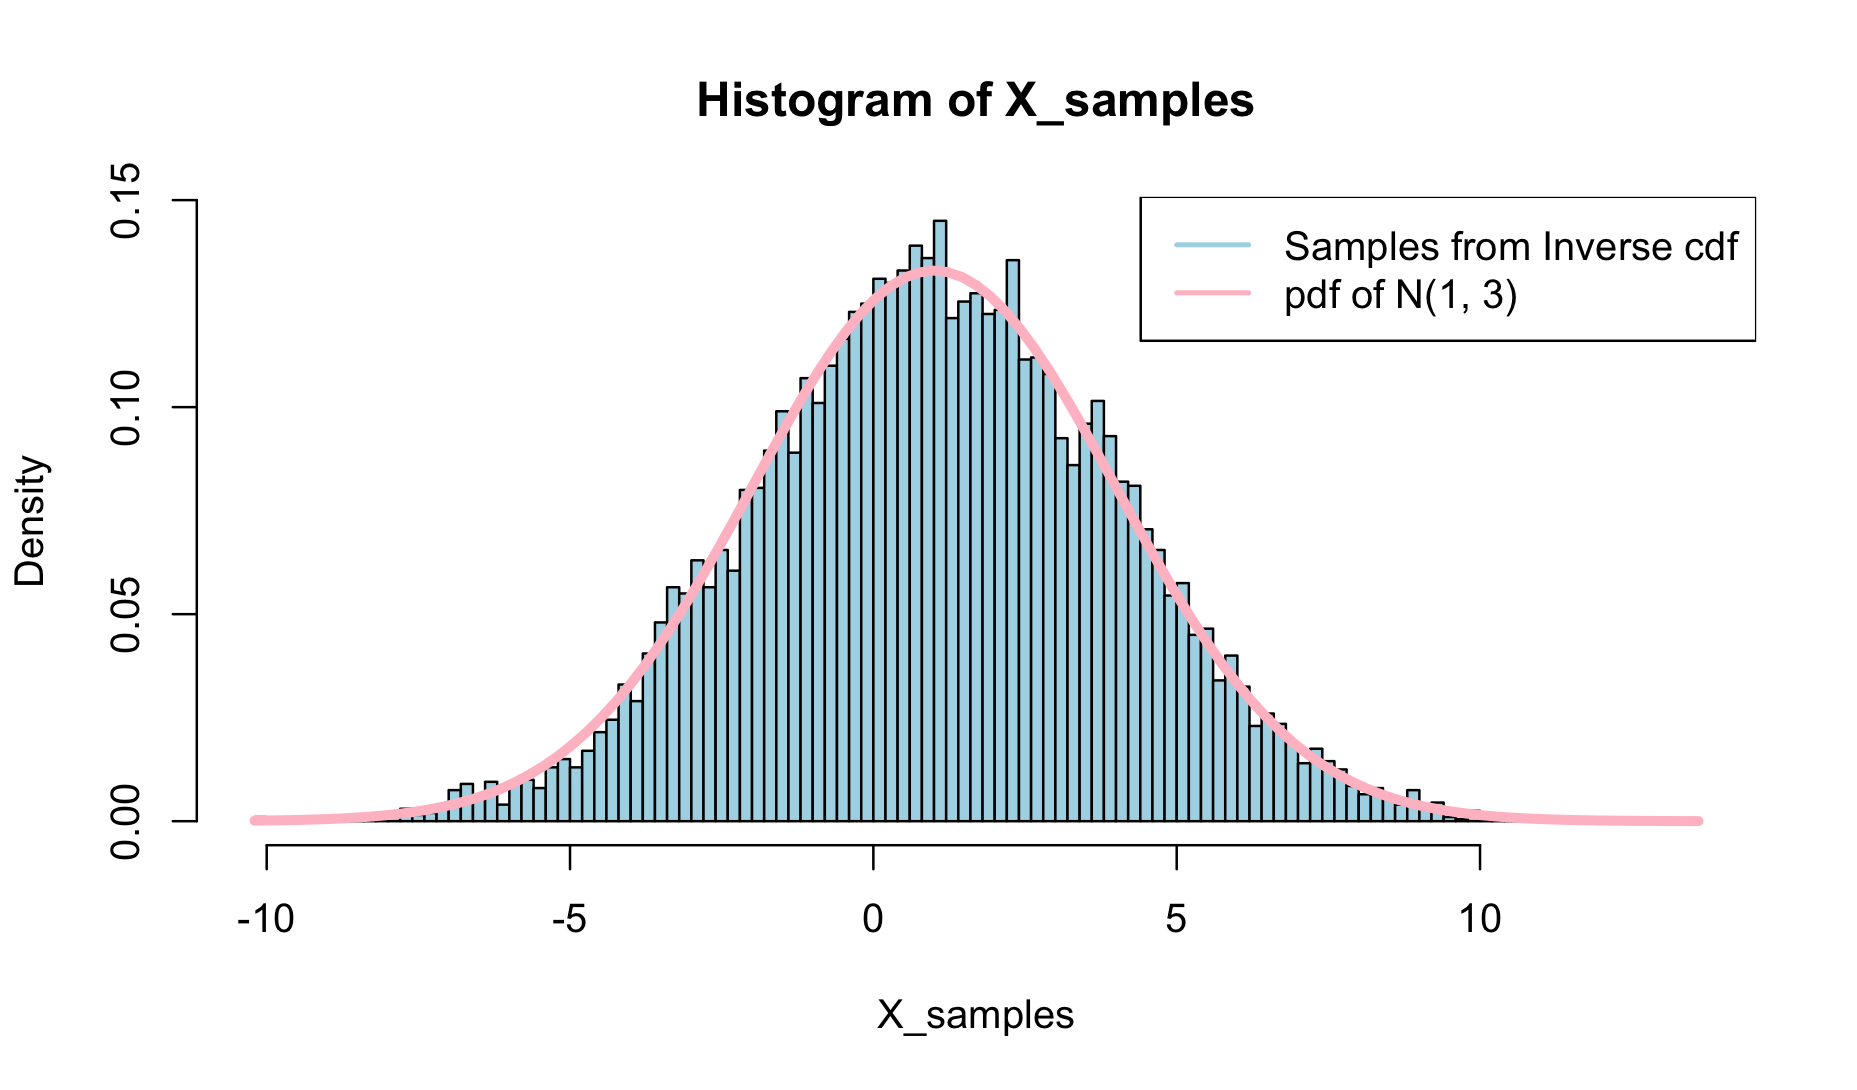
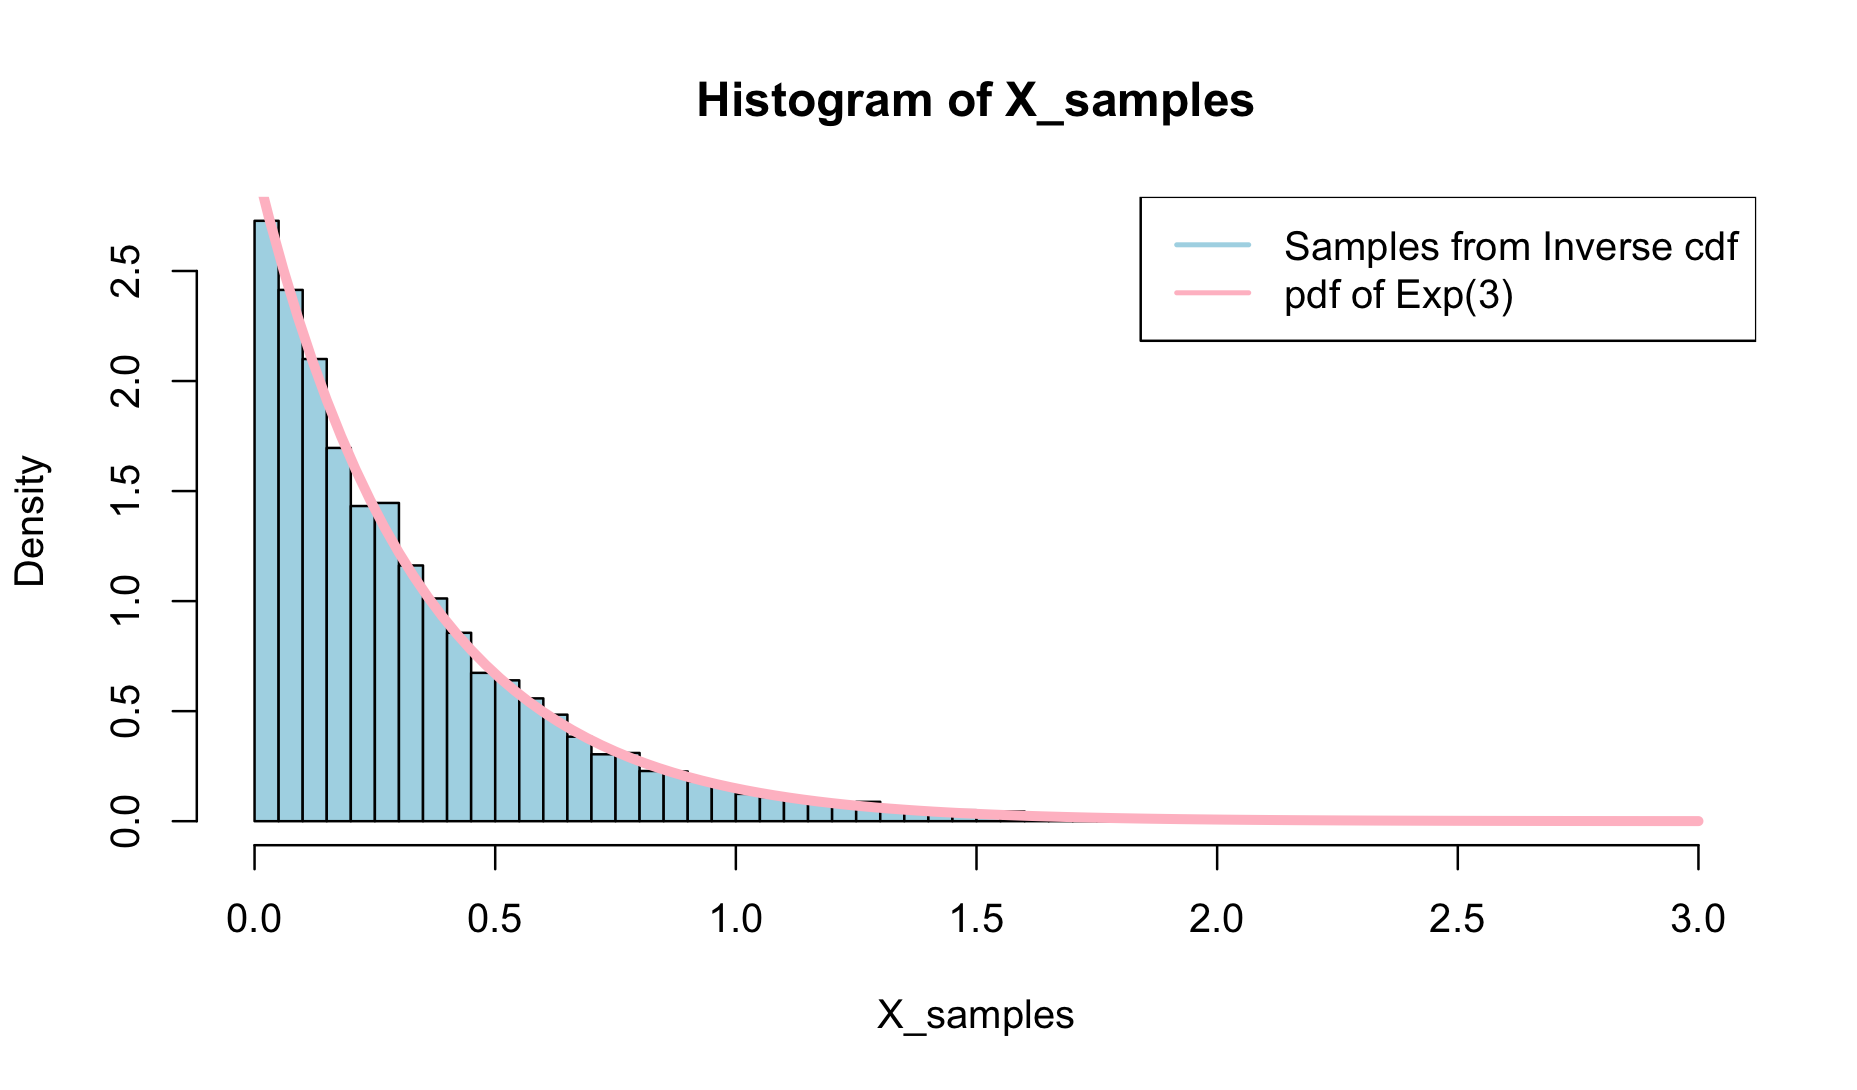
즉 다시 말하자면 X 에 대해서 뽑기 위해서 저희가 쉽게 뽑을 수 있는 균일 확률변수 U∼Unif(0,1) 에서 뽑은 뒤 그 값을 cdf 의 Inverse 함수에 넣으면 X 에서 뽑는 것과 똑같아 지는 효과를 줍니다. 즉 다시 말해, X=F−1(U) 으로 세팅하게 된다면 다음과 같이 나오게 됩니다.
Permutation A=[y1,y2,⋯,yn] 으로 시작하며 k=n 으로 세팅한다.
U∼Unif(0,1) 을 뽑고, I=⌊kU⌋+1 을 구합니다.
A[I]↔A[k] 즉 둘의 순서를 바꿉니다.
k=k−1 으로 업데이트 시키며 2,3 을 k=1 이 도달할 때까지 반복합니다.
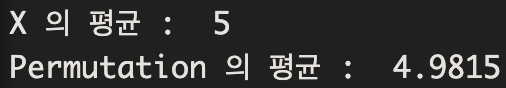
예시로 위의 Permutation 을 (1,2,3,4,5,6,7,8,9), 즉 n=9 에서 진행하겠습니다. 그러면 Random Permutation 이 성공했다면 1-번째 자리에서 나올 값이 List 의 평균인 4.5 와 동일하겠죠. 이를 한번 코드로 실행해보겠습니다.
random_permutation <- function(x){
  n = length(x)
  for(k in n:2){
    u <- runif(1)
    I <- floor(k * u) + 1
    I_th <- x[I]
    x[I] <- x[k]
    x[k] <- I_th
    k = k - 1
  }
  return(x)
}


x <- c(1, 2, 3, 4, 5, 6, 7, 8, 9)
N <- 10000
x_1st_list <- rep(NA, N)
for(i in 1:N){
  x_1st_list[i] = random_permutation(x)[1]
}
cat("X 의 평균 : ", mean(x),
    "\nPermutation 의 평균 : ", mean(x_1st_list))
그러면 결과는 다음과 같이 나옵니다.
Acceptance-Rejection Method
우선은 Discrete 인 상황을 고려해보겠습니다. 예시로 아까 보았던 이산형 확률변수를 생각해보겠습니다.
색깔 X
뽑을 확률 p(X=x)
초록색, X=1
0.20
보라색, X=2
0.10
노랑색, X=3
0.25
주황색, X=4
0.45
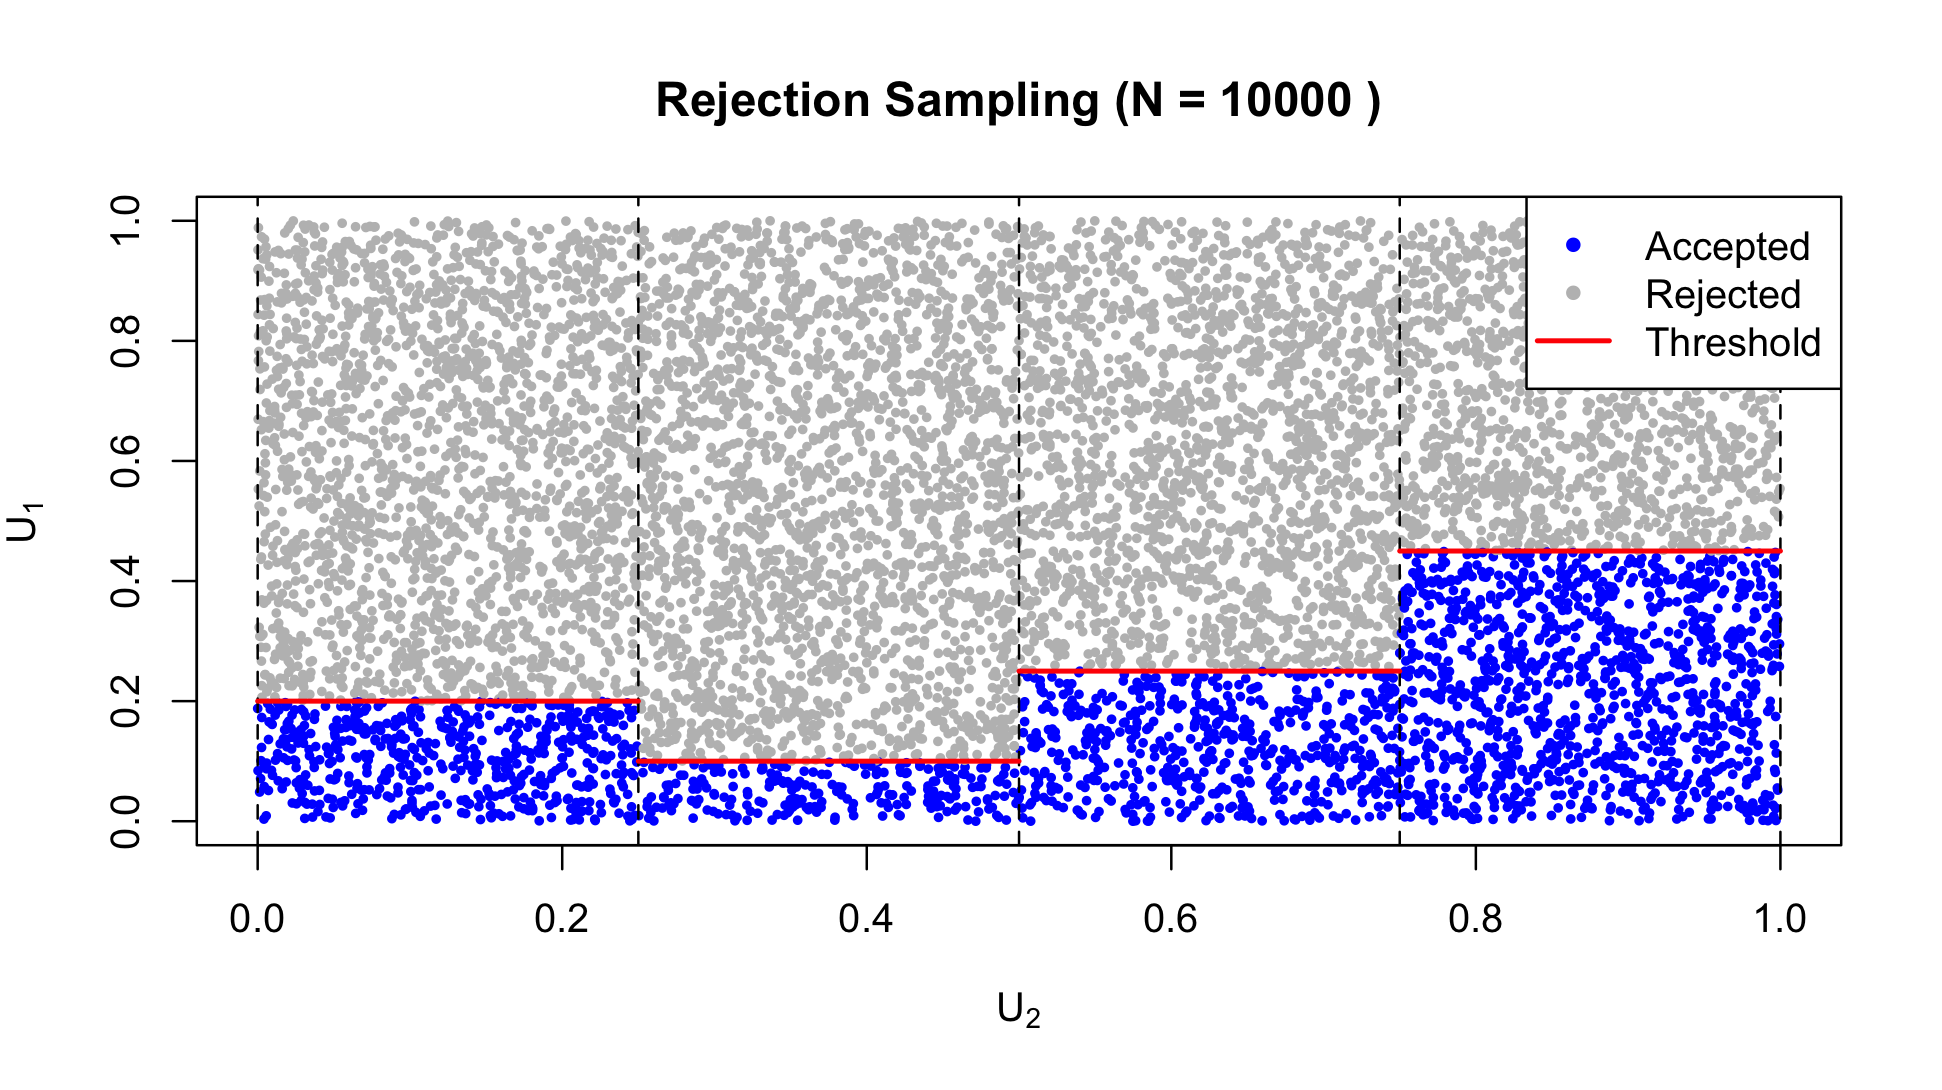
이때 ∀y∈{1,2,3,4},q(Y=y)=0.25 이라는 비교적 쉬운 분포 (위에 보았던 예시) 를 고려해보겠습니다. 그러면 X 를 뽑기 위해서는 다음과 같은 Rejection Method Algorithm 으로 뽑아주면 됩니다.
U1∼Unif(0,1)
U2∼Unif(0,1), Y=Int(4U2)+1
If U1≤p(X=Y), X=Y 으로 세팅해준 뒤에 멈춘다.
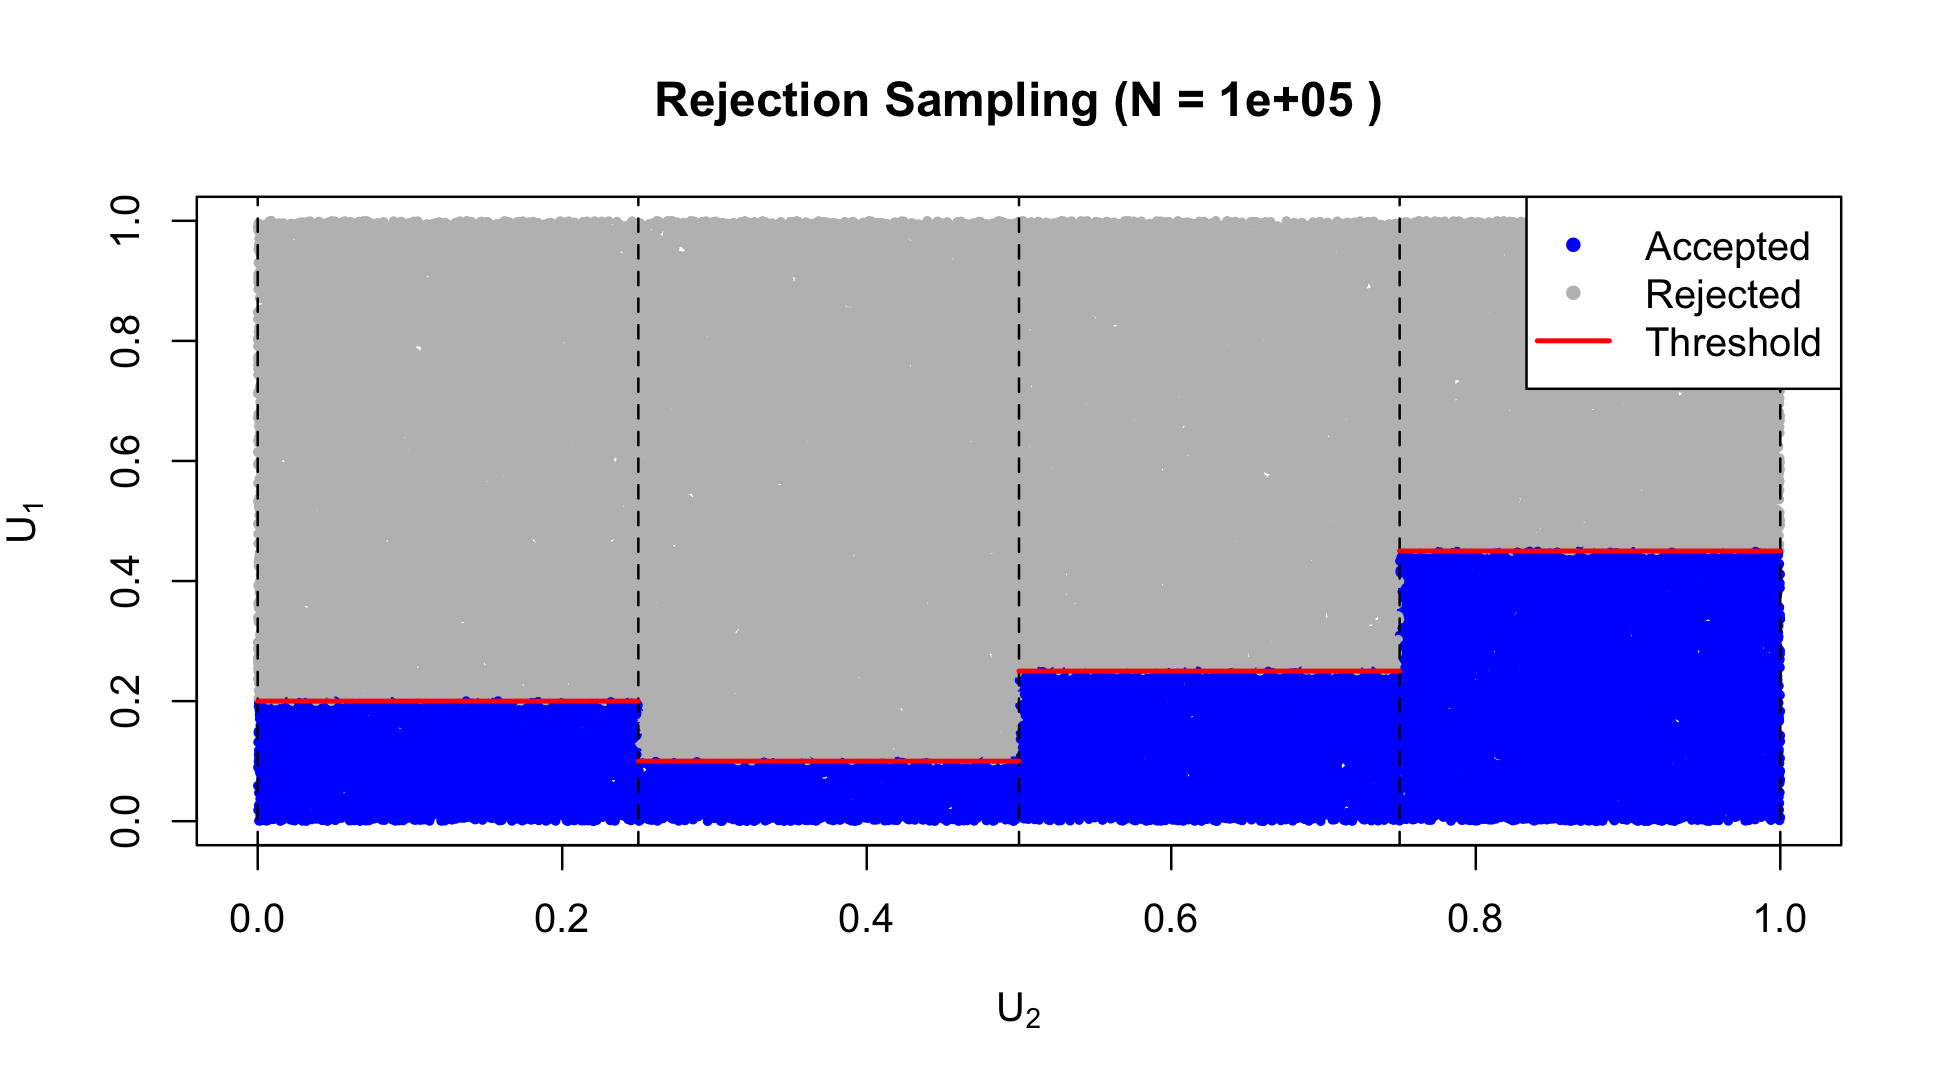
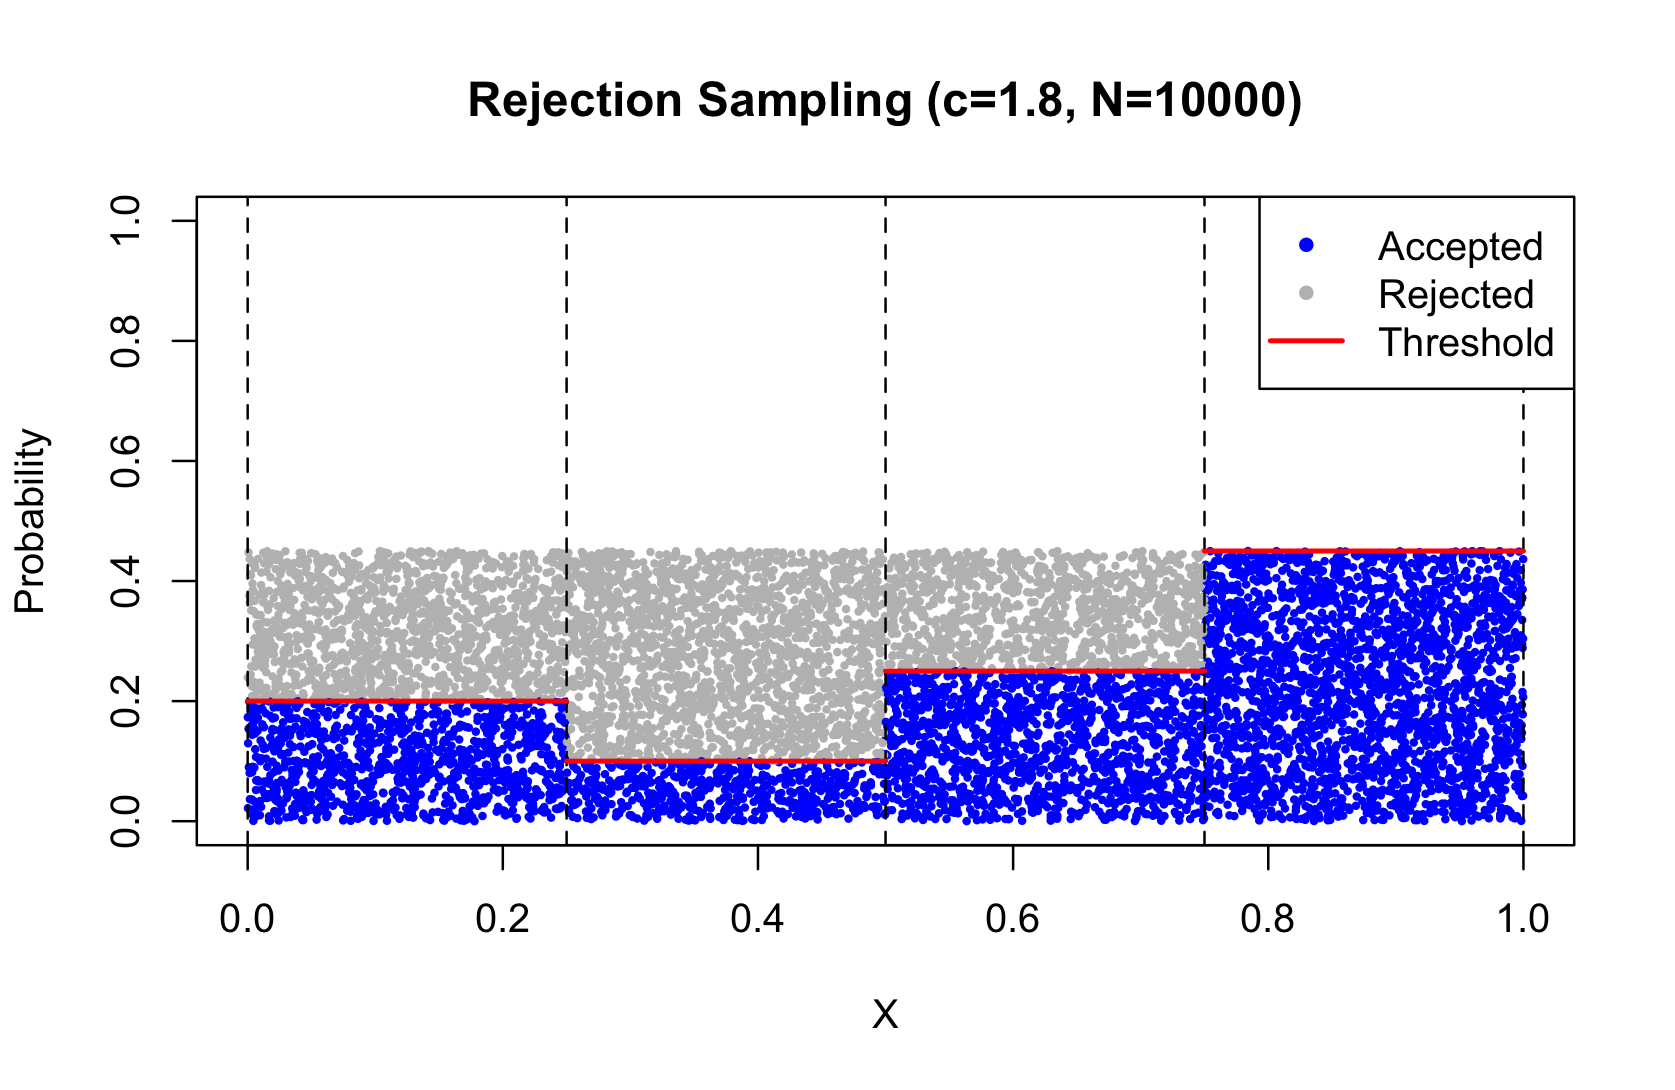
이것을 그림과 같이 해석을 해보겠습니다.
그림에 보이시는 바와 같이 그저 파랑색 쪽에 대해서 샘플링을 하는 것이 목표입니다. 이것을 이루기 위해서 보다 더 쉬운 분포 Y∼qY 에서 샘플링 해준 다음에 그 값이 pX 위에서는 파랑색 영역에 들어가는지 아닌지에 따라서 샘플링을 해줍니다.
위와 같은 알고리즘으로 진행하게 된다면 당연하게도 굉장히 비효율적입니다. for-loop 을 각 Y 샘플에 대해서 사용해야하기 때문입니다. 심지어는 가장 높은 Threshold 까지 뽑아도 되지만 굳이 그 위까지 샘플링하고 있죠.
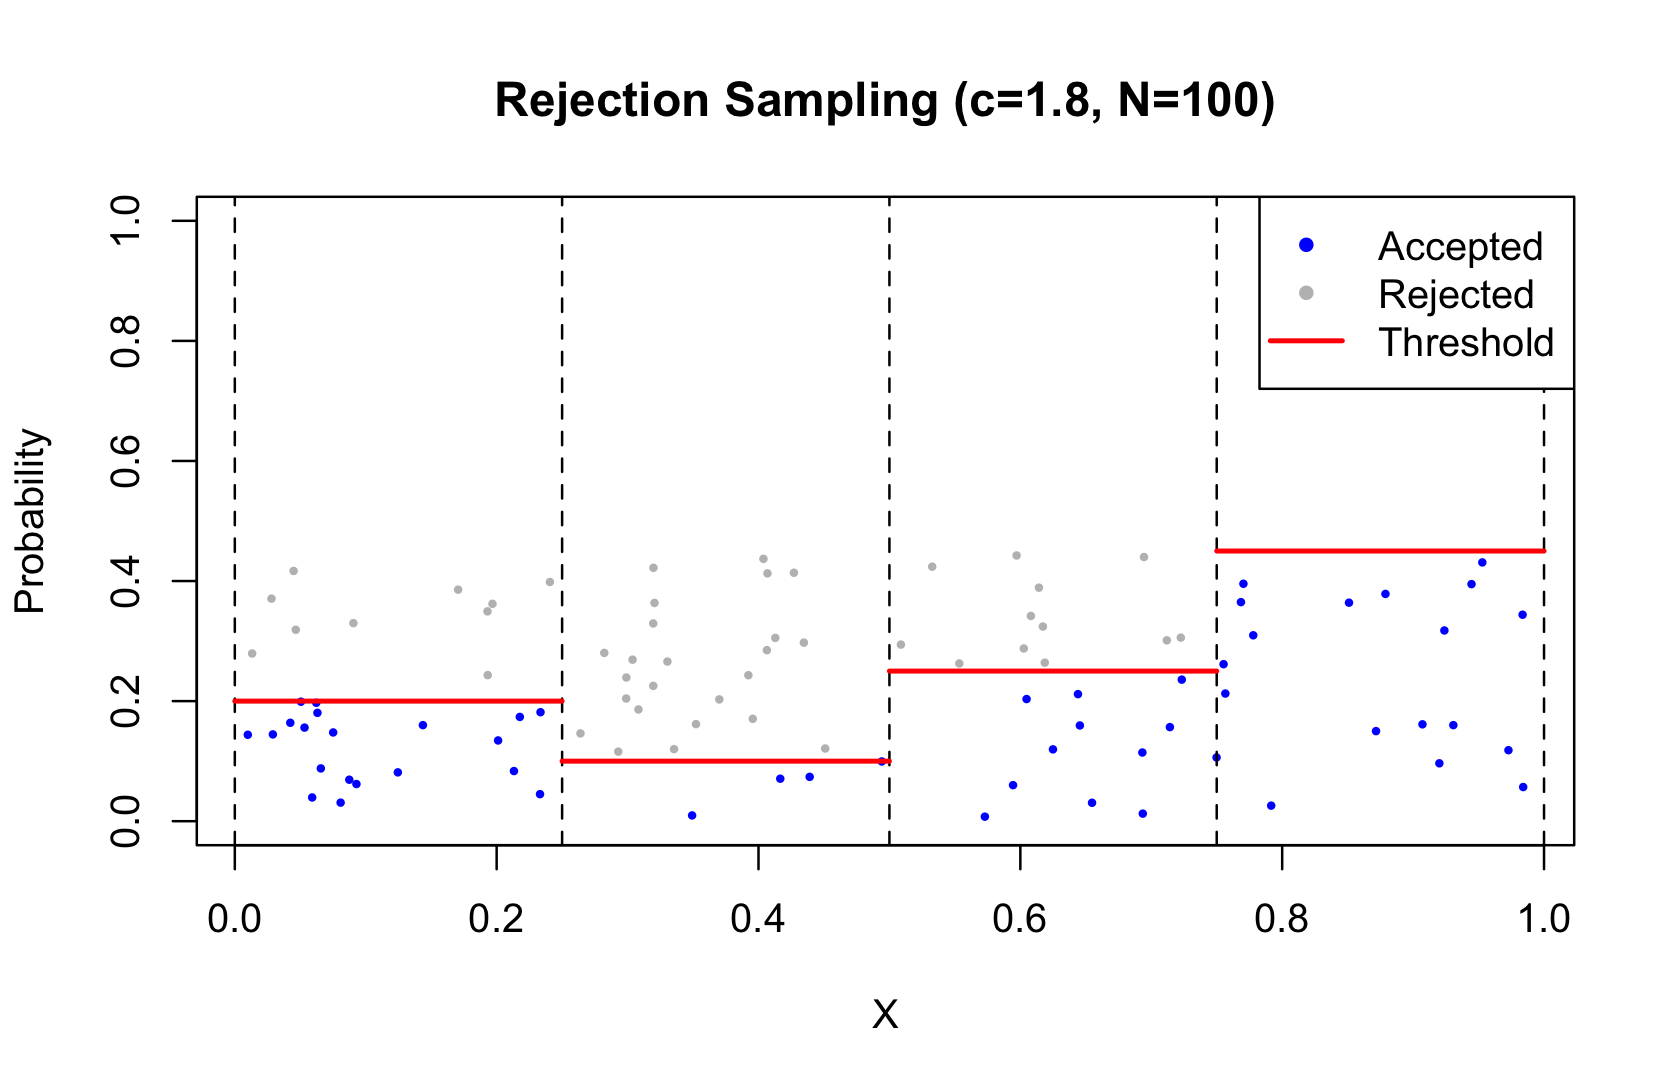
그렇기에 저희는 다음과 같은 상수를 규명하겠습니다.
c=xmaxq(Y=x)p(X=x)=0.250.45=1.8
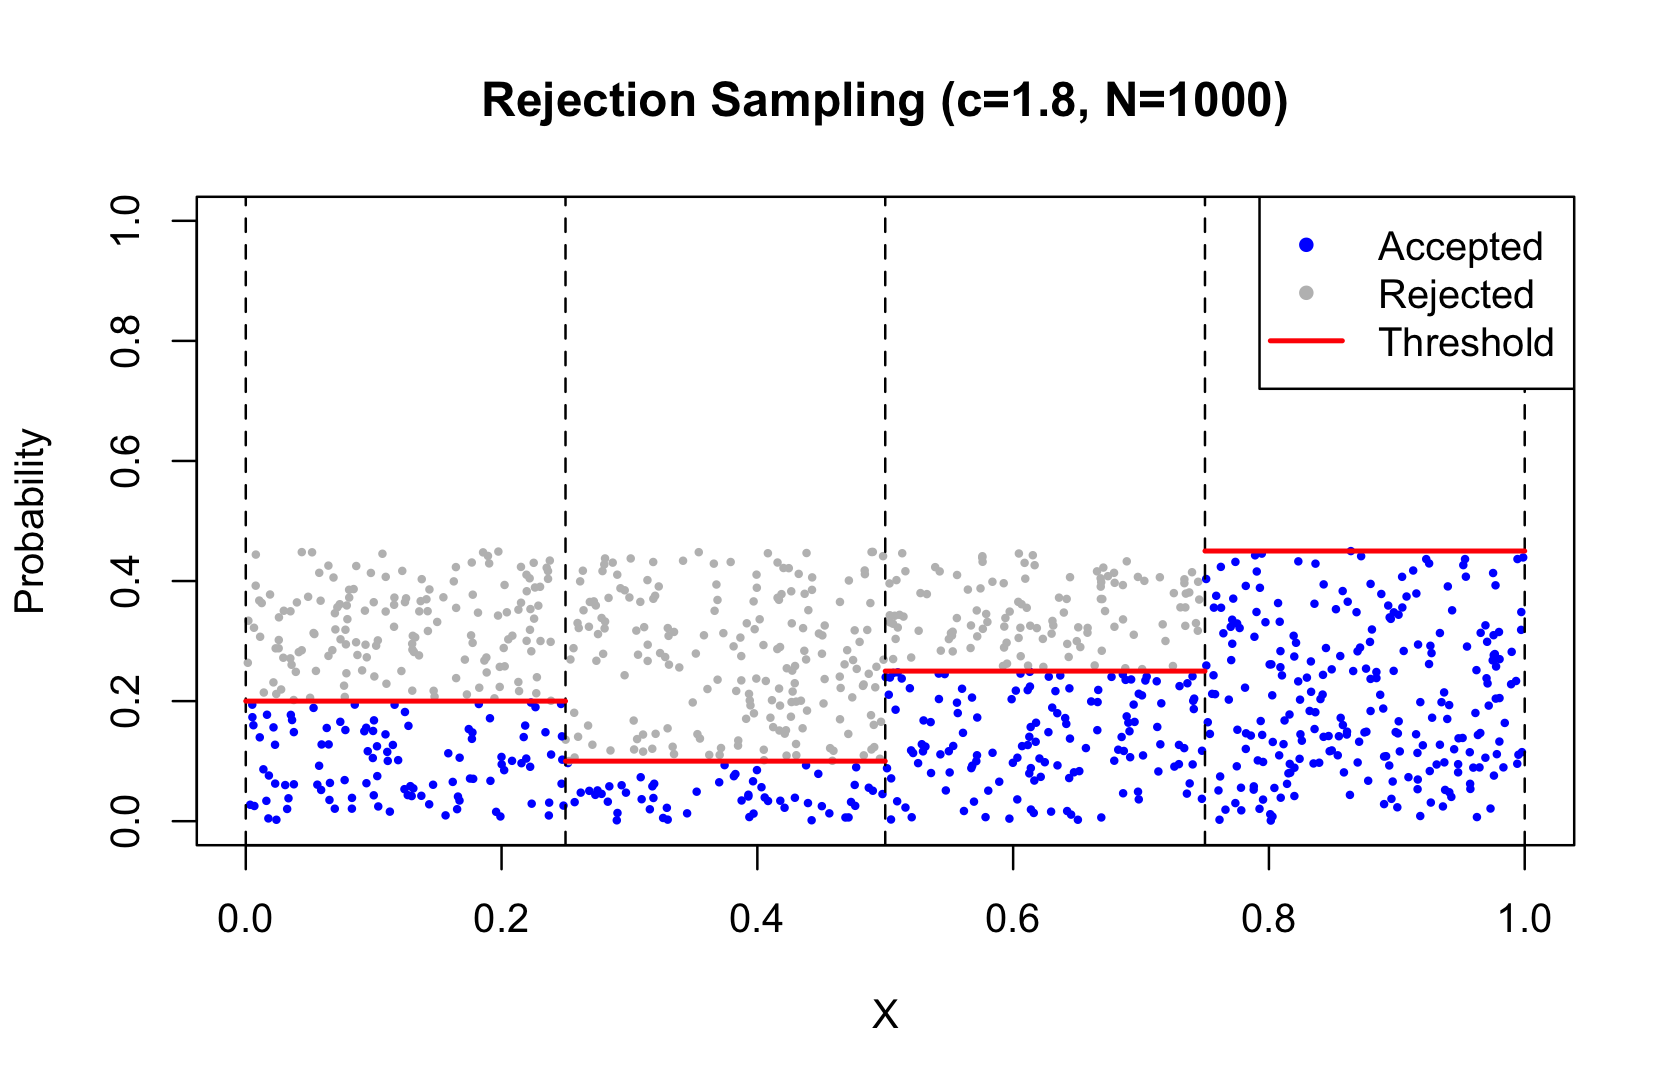
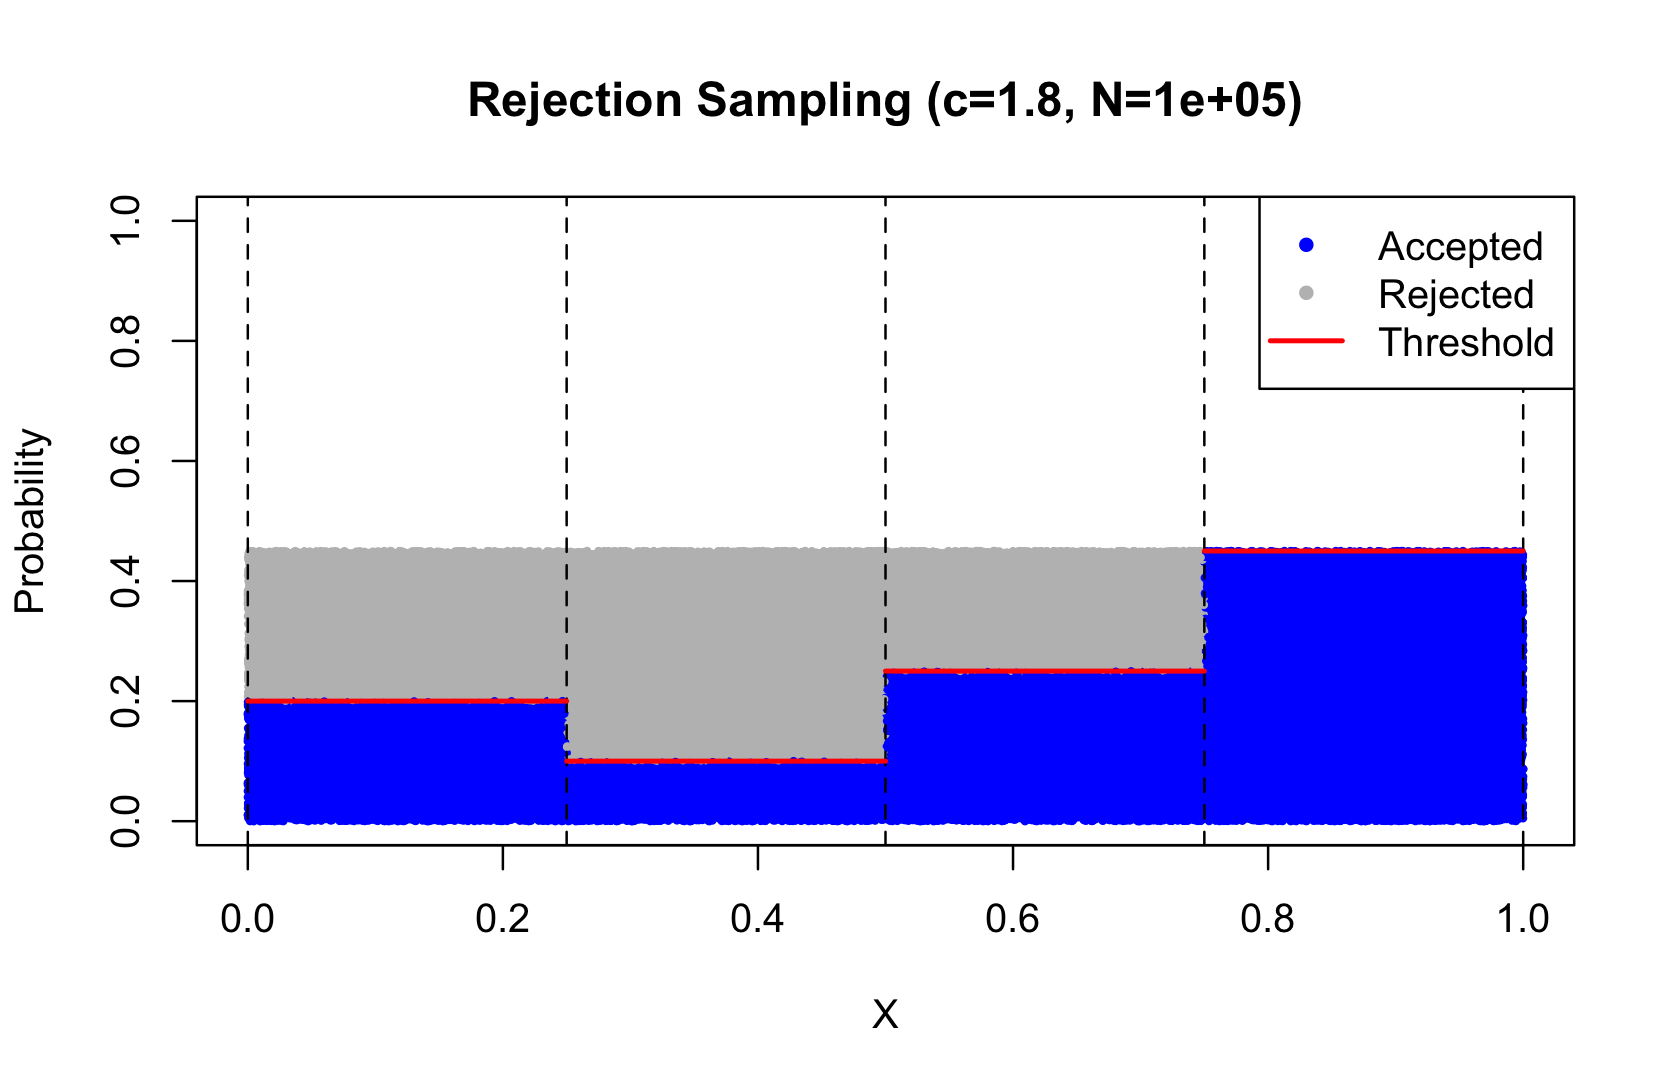
사실 위의 알고리즘의 3 번은 U1≤c⋅q(Y=Y)p(X=Y) 와 똑같습니다. qY 가 그저 41 의 균일분포이기에 모든 Y 값에 대해서 0.25 가 나오며, 이 값에 c=4 를 세팅해준다면 위의 알고리즘과 같은 조건이 되며, 이것을 c=maxxq(Y=x)p(X=x) 으로 세팅한다면 qY 분포를 최대한 파랑색에 당기게끔 만들어줍니다. 예시로 위의 똑같은 시뮬레이션을 c=1.8 일 때 다시 해보겠습니다.
이렇게 하게 된다면 버리는 샘플들을 최소화 시킬 수가 있게 됩니다. 이때 c 의 값이 1 에 가까워질 수록 Rejection Method 가 더 빨라지며, c 만큼 뽑으면 1번 pX 에서 뽑는 효과를 가집니다.
qY 를 일종의 pX 를 둘러싸는 쉬운 분포라고 생각해주시면 됩니다. 연속적일 때도 비슷하며, 이는 다음과 같은 알고리즘을 띄우게 됩니다.
목표 : X∼F, Proposal Y∼G
먼저 c=supxg(x)f(x) 세팅부터 한다.
Y∼G, U∼Unif(0,1) 을 샘플한다.
만약에 U≤c⋅g(Y)f(Y) 이면, X=Y 으로 세팅하면서 뽑으며, 그게 아니라면 2번으로 다시 돌아갑니다.
예시로 Mixture of 정규분포에서 뽑아보겠습니다.
f(x)=0.5⋅dnorm(x, -1, 0.5)+0.5⋅dnorm(x, 4, 0.8)
이것의 Density Plot 은 다음과 같이 나옵니다.
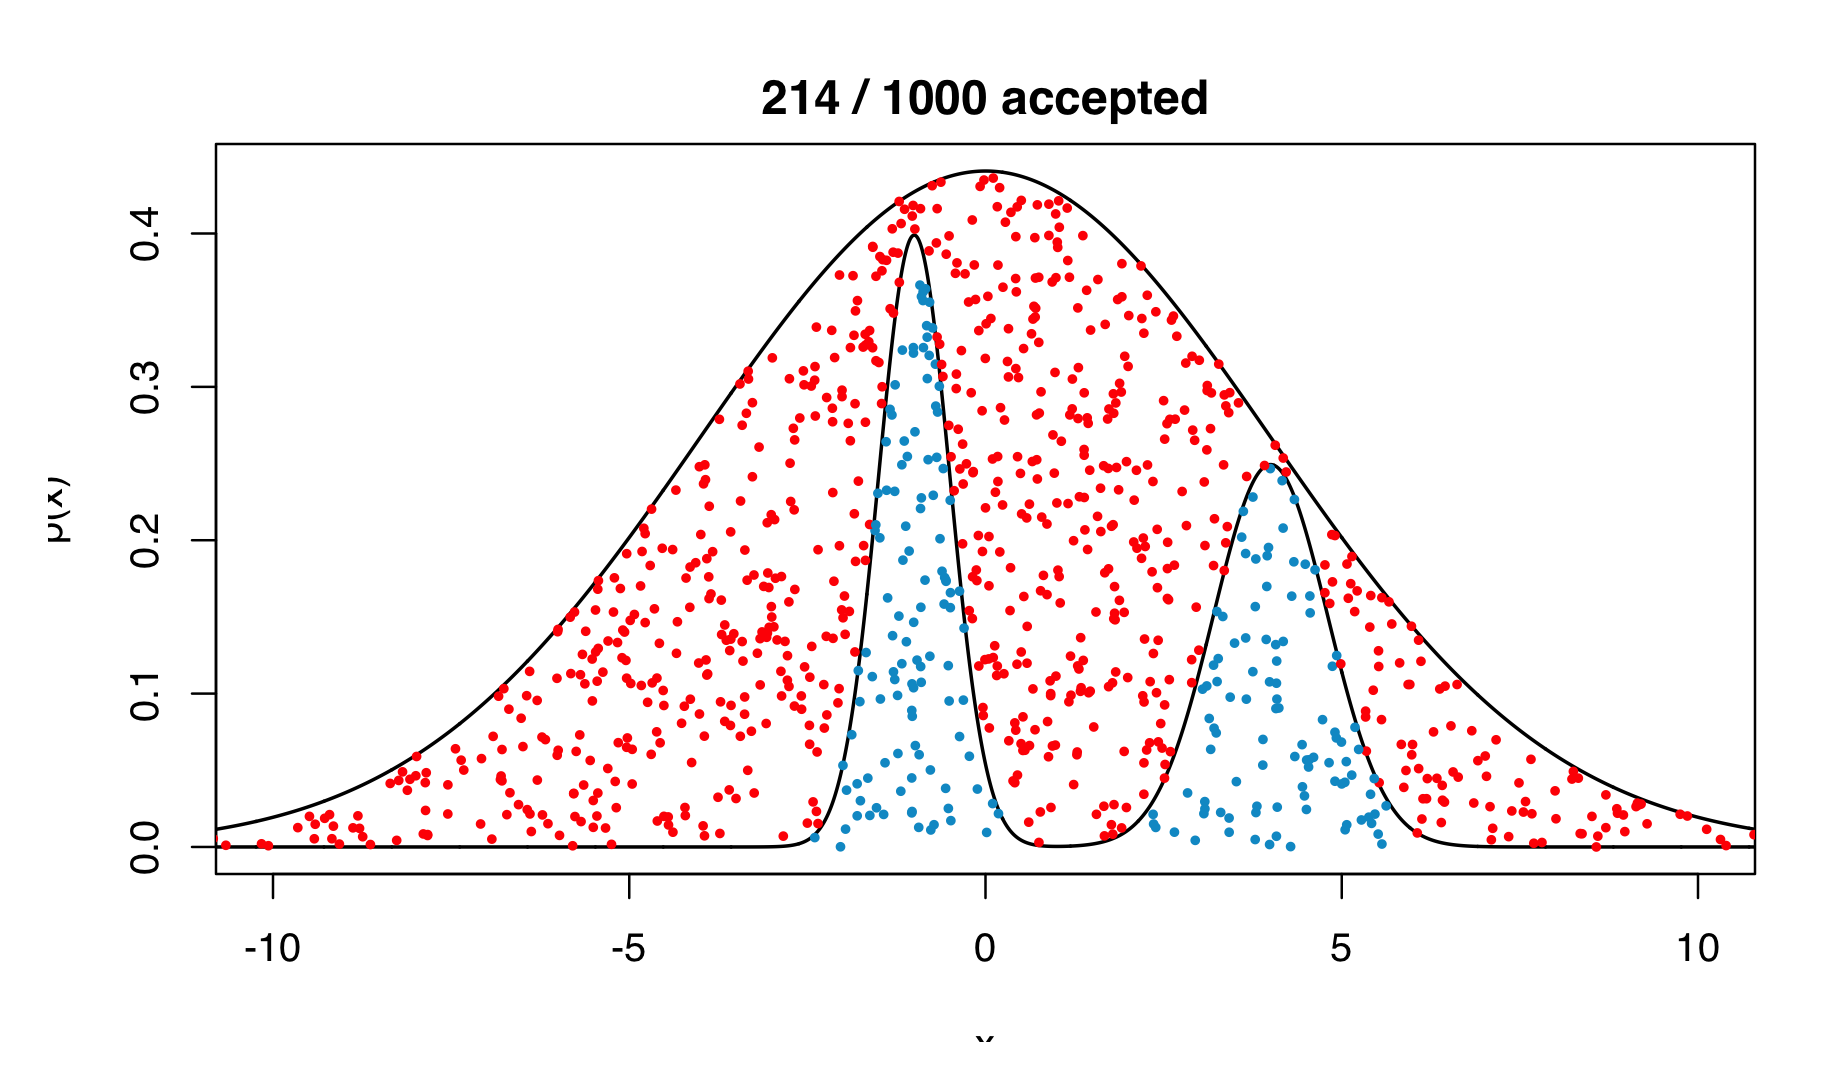
이때 이 분포 내에서 한번 샘플을 뽑아 달라고 했을 때, Rejection Method 를 통해서 쉽게 수행하는 것이 가능합니다. Proposal Density 의 경우 g(x)=dnorm(x;0,4) 으로 설정해두겠습니다. 그러면 다음과 같이 Rejection Method 를 거리에서 하면 다음과 같은 결과가 나옵니다.
c=maxxg(x)f(x)=4.418967
Y∼G,U2∼Unif(0,1), where Y,U2∈RN
ifelse(U2≤c⋅g(Y)f(Y),Y,Skip)
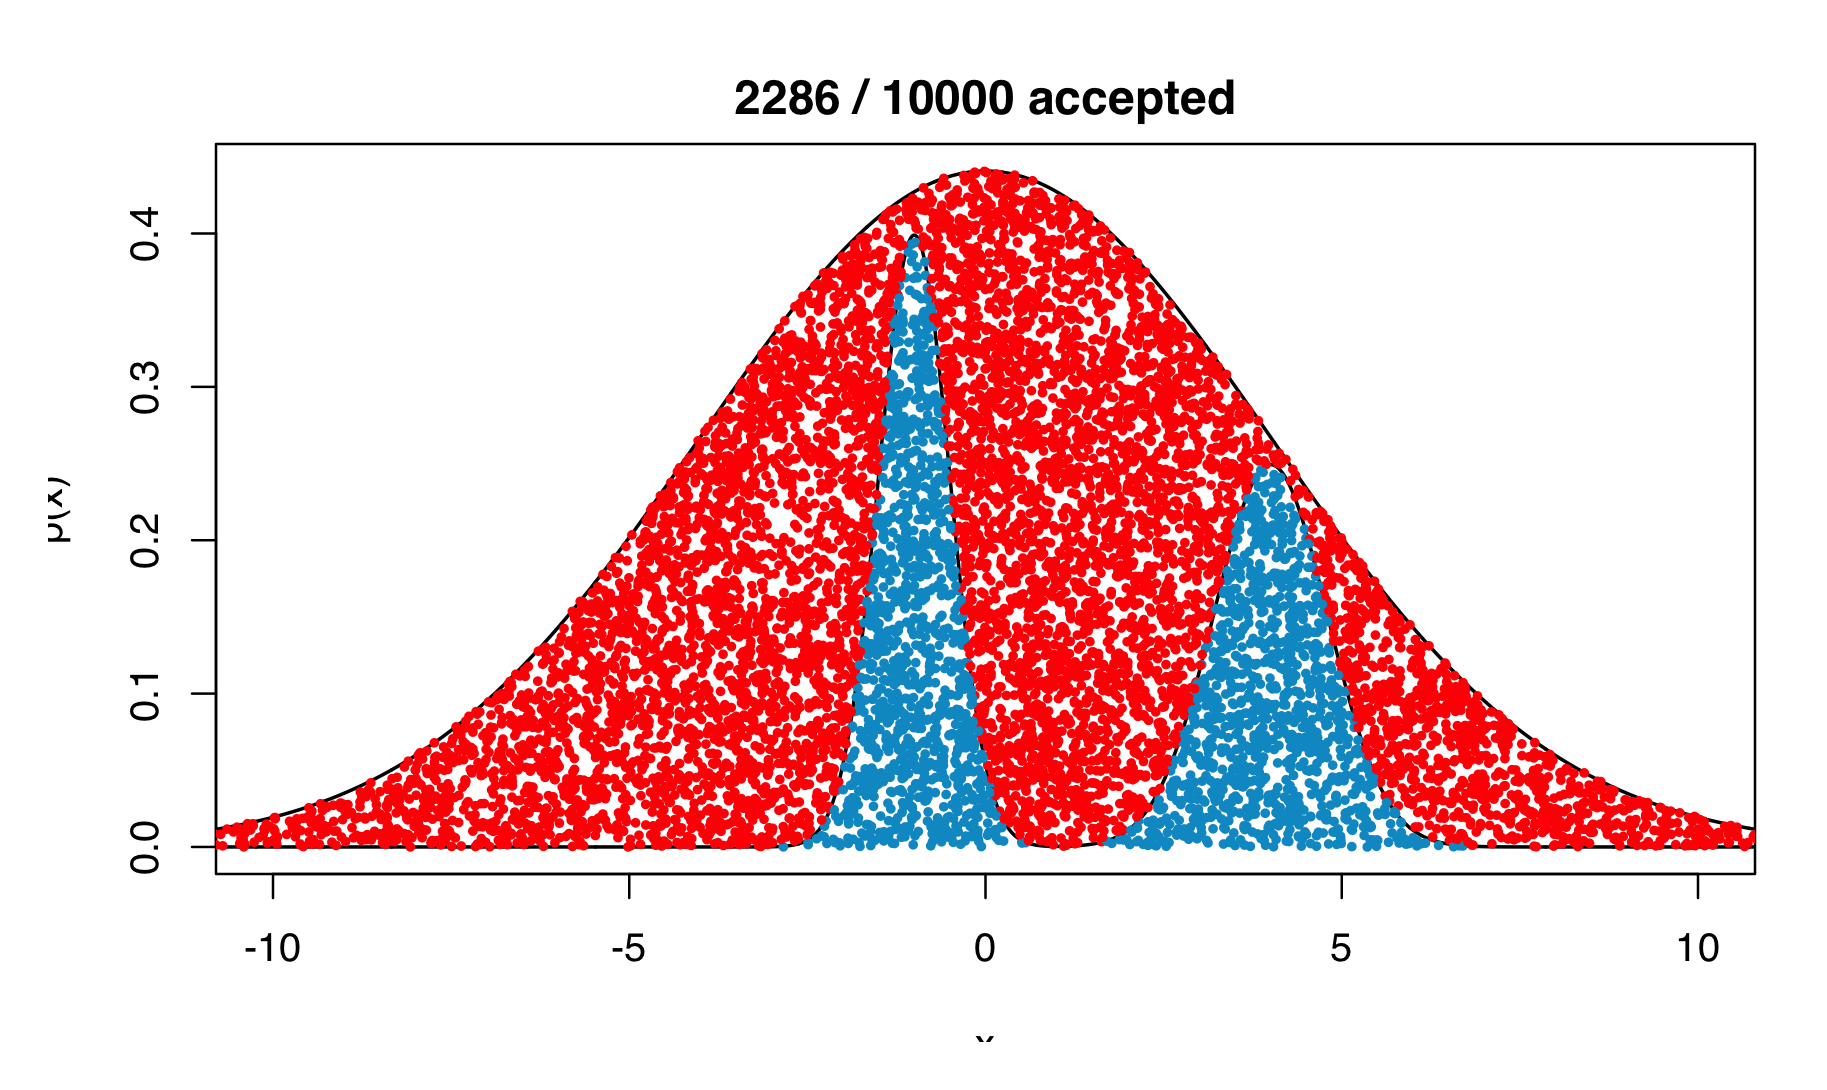
이것을 시각화 시키게 된다면 다음과 같이 나옵니다.
위에 보이시는 바와 같이 c1 정도의 샘플들을 버리긴 하지만 결국에는 파랑색 분포 (Target) 에서 샘플링하는 효과를 해주게 됩니다.
Transformation of Random Variables
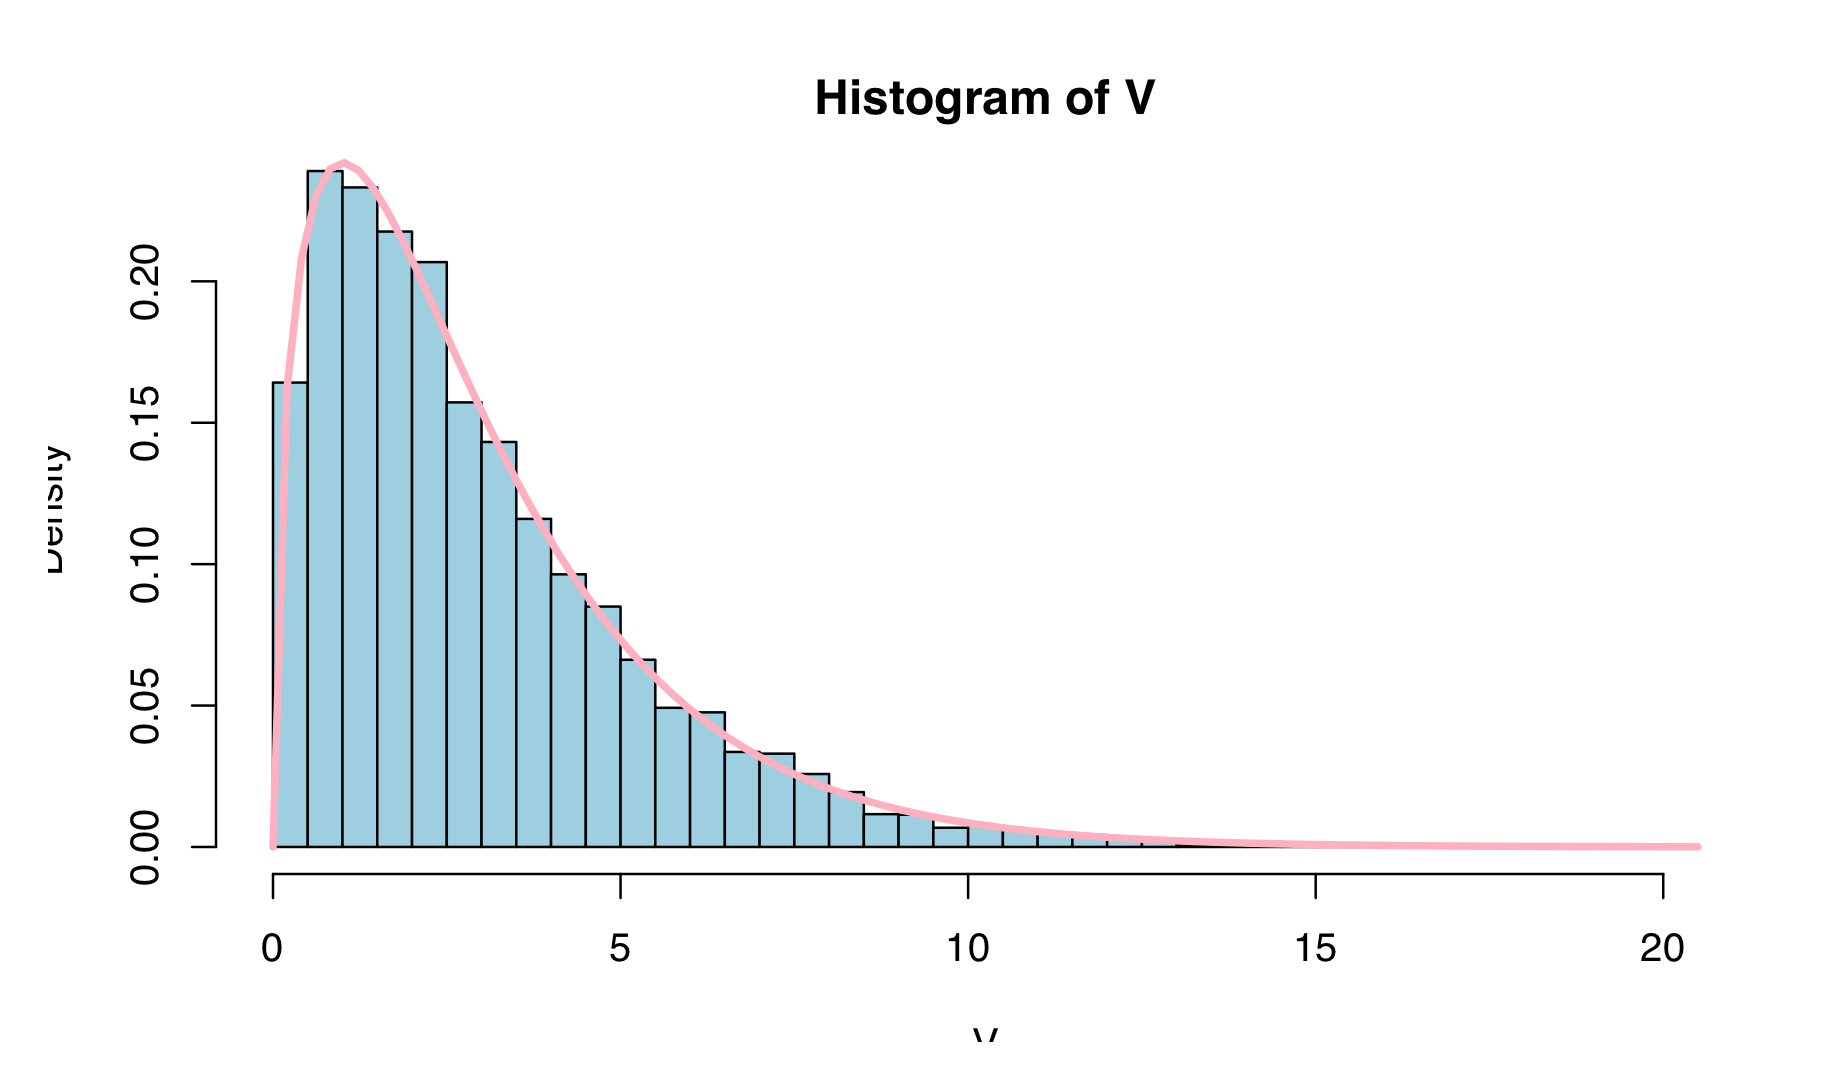
마지막으로는 Transformation of R.V’s 입니다. 직관적인 예시를 위해서 X2(3) 에서 뽑고 싶다고 하겠습니다. 저희는 Z∼N(0,1) 에서 어떻게 뽑는지 Inverse Transform Method 를 통해서 이미 알고 있습니다. 그렇기에 표준정규분포와 카이제곱 분포가 가지는 관계를 이용해서 X2(3) 에서 뽑아보겠습니다.
Z2∼X(1)
Z1,Z2,Z3∼i.i.dN(0,1)
V=∑i=13Zi2∼X(3)
V 를 시각화 시켜서 원래 X2(3) 의 pdf 와 비교해서 그린다면 다음과 같이 나오게 됩니다.
이처럼 표준정규분포에서 쉽게 뽑을 수 있기에 함수들을 활용시켜서 다른 분포들에게서도 뽑을 수 있게 됩니다. 이것도 일종의 Inverse Transform Method 이라고 부르기도 합니다.