Using Inverse & Rejection Methods Multivariate Normal Distribution Copulas (Joint Distributions) 고차원 확률분포에서 샘플링을 하는 것은 쉬운 일이 아니며, 이는 대표적으로 차원의 저주라는 문제 때문에 하기가 어렵습니다.
확률분포 내의 변수들이 독립적이라면 사실 그저 모든 변수들을 독립적으로 뽑으면 되지만, 상관관계가 있다면 그것을 고려한채로 뽑는 것이 어렵습니다.
Using Inverse & Rejection Methods
Multivariate Inverse Transform Method 어떠한 다변량 분포에 대한 CDF 를 F 1 , ⋯ , d ( x 1 , ⋯ , x d ) F_{1, \cdots, d} (x_1, \cdots , x_d) F 1 , ⋯ , d ( x 1 , ⋯ , x d )
F 1 , ⋯ , d ( x 1 , ⋯ , x d ) = F 1 ( x 1 ) F 2 ∣ 1 ( x 2 ∣ x 1 ) ⋯ F d ∣ 1 , ⋯ , d − 1 ( x d ∣ x 1 , ⋯ , x d − 1 )
F_{1, \cdots, d} (x_1, \cdots , x_d)
= F_1(x_1) F_{2 \mid 1}(x_2 \mid x_1) \cdots F_{d \mid 1 , \cdots, d-1}(x_d \mid x_1, \cdots, x_{d-1}) F 1 , ⋯ , d ( x 1 , ⋯ , x d ) = F 1 ( x 1 ) F 2 ∣ 1 ( x 2 ∣ x 1 ) ⋯ F d ∣ 1 , ⋯ , d − 1 ( x d ∣ x 1 , ⋯ , x d − 1 ) 그러면 저희는 다음과 같이 Inverse Transform Method 를 적용하는 것이 가능합니다.
X 1 = F 1 − 1 ( U 1 ) X 2 = F 2 ∣ 1 − 1 ( U 2 ∣ X 1 ) X 3 = F 3 ∣ 1 , 2 − 1 ( U 3 ∣ X 1 , X 2 ) ⋮ X d = F d ∣ 1 , ⋯ , d − 1 − 1 ( U d ∣ X 1 , ⋯ , X d − 1 ) \begin{aligned}
X_1 &= F_1^{-1}(U_1) \\
X_2 &= F_{2\mid 1}^{-1}(U_2 \mid X_1) \\
X_3 &= F_{3\mid 1, 2}^{-1}(U_3 \mid X_1, X_2) \\
&\vdots \\
X_d &= F_{d \mid 1, \cdots, d-1}^{-1}(U_d \mid X_1, \cdots, X_{d-1})
\end{aligned} X 1 X 2 X 3 X d = F 1 − 1 ( U 1 ) = F 2 ∣ 1 − 1 ( U 2 ∣ X 1 ) = F 3 ∣ 1 , 2 − 1 ( U 3 ∣ X 1 , X 2 ) ⋮ = F d ∣ 1 , ⋯ , d − 1 − 1 ( U d ∣ X 1 , ⋯ , X d − 1 ) 물론 이렇게 진행하면 각각에 대한 식을 구해야 된다는 단점이 존재하며, d d d
Example 다변량 정규분포 특성상 조건부 분포는 다음과 같이 구할 수가 있습니다.
( X 1 X 2 ) ∼ N ( ( μ 1 μ 2 ) ⏟ μ , ( Σ 11 Σ 12 Σ 21 Σ 22 ) ⏟ Σ ) \binom{X_1}{X_2} \sim \mathrm{N}\left(\underbrace{\binom{\mu_1}{\mu_2}}_\mu, \underbrace{\left(\begin{array}{ll}
\Sigma_{11} & \Sigma_{12} \\
\Sigma_{21} & \Sigma_{22}
\end{array}\right)}_{\Sigma}\right) ( X 2 X 1 ) ∼ N μ ( μ 2 μ 1 ) , Σ ( Σ 11 Σ 21 Σ 12 Σ 22 ) X 2 ∣ X 1 = x 1 ∼ N ( μ 2 + Σ 21 Σ 11 − 1 ( x 1 − μ 1 ) ⏟ m 2 ∣ 1 , Σ 22 − Σ 21 Σ 11 − 1 Σ 12 ⏟ v 2 ∣ 1 ) X_2 \mid X_1=x_1 \sim \mathrm{N}\left(\underbrace{\mu_2+\Sigma_{21} \Sigma_{11}^{-1}\left(x_1-\mu_1\right)}_{m_{2 \mid 1}}, \underbrace{\Sigma_{22}-\Sigma_{21} \Sigma_{11}^{-1} \Sigma_{12}}_{v_{2 \mid 1}}\right) X 2 ∣ X 1 = x 1 ∼ N m 2 ∣ 1 μ 2 + Σ 21 Σ 11 − 1 ( x 1 − μ 1 ) , v 2 ∣ 1 Σ 22 − Σ 21 Σ 11 − 1 Σ 12 이것은 Generalize 될 수가 있으며, 이것을 다음과 같은 예시 분포에 적용해보겠습니다.
( X 1 X 2 X 3 ) ∼ N ( [ 0 0 0 ] , [ 1.0 0.4 0.2 0.4 1.5 0.3 0.2 0.3 2.0 ] ) \left(\begin{aligned}
X_1 \\
X_2 \\
X_3
\end{aligned}\right) \sim
\mathrm{N}
\left(\left[\begin{matrix}
0 \\ 0 \\ 0
\end{matrix}\right],
\left[\begin{matrix}
1.0 & 0.4 & 0.2 \\
0.4 & 1.5 & 0.3 \\
0.2 & 0.3 & 2.0
\end{matrix}\right]
\right) X 1 X 2 X 3 ∼ N 0 0 0 , 1.0 0.4 0.2 0.4 1.5 0.3 0.2 0.3 2.0 x 1 x_1 x 1 X 1 ∼ N ( 0 , 1.0 ) X_1 \sim \mathrm{N}(0, 1.0) X 1 ∼ N ( 0 , 1.0 ) F 1 ( x 1 ) = Φ ( x 1 − 0 1.0 ) F_1(x_1) = \Phi\left(
\frac{x_1 - 0}{\sqrt{1.0}}
\right) F 1 ( x 1 ) = Φ ( 1.0 x 1 − 0 ) F 1 − 1 ( u ) = 0 + 1.0 ⋅ Φ − 1 ( u ) = x 1 F_1^{-1}(u) = 0 + \sqrt{1.0} \cdot \Phi^{-1}(u) = x_1 F 1 − 1 ( u ) = 0 + 1.0 ⋅ Φ − 1 ( u ) = x 1 x 2 x_2 x 2 X 2 ∣ x 1 ∼ N ( 0 + 0.4 1.0 ( X 1 − 0 ) , 1.5 − 0.4 2 1.0 ) = N ( 0.4 ⋅ X 1 , 1.34 ) X_2 \mid x_1 \sim \mathrm{N}\left(
0+\frac{0.4}{1.0}\left(X_1-0\right),
1.5-\frac{0.4^2}{1.0}
\right) = \mathrm{N}\left(
0.4 \cdot X_1, 1.34
\right) X 2 ∣ x 1 ∼ N ( 0 + 1.0 0.4 ( X 1 − 0 ) , 1.5 − 1.0 0. 4 2 ) = N ( 0.4 ⋅ X 1 , 1.34 ) F 2 ∣ 1 ( x 2 ∣ x 1 ) = Φ ( x 2 − 0.4 ⋅ x 1 1.34 ) F_{2\mid 1}(x_2\mid x_1) = \Phi\left(
\frac{x_2 - 0.4 \cdot x_1}{\sqrt{1.34}}
\right) F 2 ∣ 1 ( x 2 ∣ x 1 ) = Φ ( 1.34 x 2 − 0.4 ⋅ x 1 ) F 2 ∣ 1 − 1 ( u ∣ x 1 ) = 0.4 ⋅ x 1 + 1.34 ⋅ Φ − 1 ( u ) F_{2\mid 1}^{-1}(u\mid x_1) = 0.4 \cdot x_1 + \sqrt{1.34} \cdot \Phi^{-1}(u) F 2 ∣ 1 − 1 ( u ∣ x 1 ) = 0.4 ⋅ x 1 + 1.34 ⋅ Φ − 1 ( u ) x 3 x_3 x 3 Σ 11 : 22 = [ 1.0 0.4 0.4 1.5 ] , Σ 13 : 23 = [ 0.2 0.3 ] , Σ 31 : 32 = [ 0.2 0.3 ] , Σ 33 = 2.0 \Sigma_{11:22} = \left[\begin{matrix}
1.0 & 0.4 \\
0.4 & 1.5
\end{matrix} \right], \quad
\Sigma_{13:23} = \left[\begin{matrix}
0.2 \\ 0.3
\end{matrix}\right], \quad
\Sigma_{31:32} = \left[\begin{matrix}
0.2 & 0.3
\end{matrix}\right], \quad
\Sigma_{33} = 2.0 Σ 11 : 22 = [ 1.0 0.4 0.4 1.5 ] , Σ 13 : 23 = [ 0.2 0.3 ] , Σ 31 : 32 = [ 0.2 0.3 ] , Σ 33 = 2.0 X 3 ∣ x 1 , x 2 ∼ N ( 0 + Σ 13 : 23 Σ 11 : 22 − 1 ( [ x 1 x 2 ] ) , Σ 33 − Σ 31 : 32 Σ 11 : 22 − 1 Σ 13 : 23 ) = : N ( m 3 ∣ 12 , v 3 ∣ 12 ) X_3 \mid x_1, x_2 \sim \mathrm{N}\left(
0 + \Sigma_{13:23} \Sigma^{-1}_{11:22}\left(
\left[\begin{matrix}
x_1 \\ x_2
\end{matrix} \right]
\right) , \;
\Sigma_{33} - \Sigma_{31:32} \Sigma_{11:22}^{-1} \Sigma_{13:23}
\right)\\ =: \mathrm{N}\left( m_{3\mid 12}, v_{3 \mid 12}\right) X 3 ∣ x 1 , x 2 ∼ N ( 0 + Σ 13 : 23 Σ 11 : 22 − 1 ( [ x 1 x 2 ] ) , Σ 33 − Σ 31 : 32 Σ 11 : 22 − 1 Σ 13 : 23 ) =: N ( m 3 ∣ 12 , v 3 ∣ 12 ) F 3 ∣ 1 , 2 ( x 3 ∣ x 1 , x 2 ) = Φ ( x 3 − m 3 ∣ 12 v 3 ∣ 12 ) F_{3\mid 1, 2}(x_3\mid x_1, x_2) = \Phi\left(
\frac{x_3 - m_{3 \mid 12}}{\sqrt{v_{3 \mid 12}}}
\right) F 3 ∣ 1 , 2 ( x 3 ∣ x 1 , x 2 ) = Φ ( v 3 ∣ 12 x 3 − m 3 ∣ 12 ) F 3 ∣ 12 − 1 ( u ∣ x 1 , x 2 ) = m 3 ∣ 12 + v 3 ∣ 12 ⋅ Φ − 1 ( u ) F^{-1}_{3\mid 12} (u \mid x_1, x_2) = m_{3 \mid 12} + \sqrt{v_{3 \mid 12}} \cdot \Phi^{-1}\left( u\right) F 3 ∣ 12 − 1 ( u ∣ x 1 , x 2 ) = m 3 ∣ 12 + v 3 ∣ 12 ⋅ Φ − 1 ( u ) 이것을 코드로 진행하게 된다면 다음과 같이 나오게 됩니다.
mu    <- c(0, 0, 0)
Sigma <- matrix(c(
  1.0, 0.4, 0.2,
  0.4, 1.5, 0.3,
  0.2, 0.3, 2.0
), nrow = 3, byrow = TRUE)

sample_mvnorm_inverse <- function(mu, Sigma) {
  # X1 ~ N(mu1, Sigma[1,1])
  u1 <- runif(1); z1 <- qnorm(u1)
  x1 <- mu[1] + sqrt(Sigma[1,1]) * z1

  # X2 | X1=x1 ~ N(m21, v21)
  m21 <- mu[2] + (Sigma[2,1]/Sigma[1,1]) * (x1 - mu[1])
  v21 <- Sigma[2,2] - Sigma[2,1]^2 / Sigma[1,1]
  u2  <- runif(1);   z2 <- qnorm(u2)
  x2  <- m21 + sqrt(v21) * z2

  # X3 | (X1,X2) ~ N(m312, v312)
  S11  <- Sigma[1:2, 1:2]
  S21  <- Sigma[3, 1:2]
  S12  <- Sigma[1:2, 3]
  invS <- solve(S11)
  delta <- c(x1, x2) - mu[1:2]
  m312  <- mu[3] + as.numeric(S21 %*% invS %*% delta)
  v312  <- Sigma[3,3] - as.numeric(S21 %*% invS %*% S12)
  u3    <- runif(1); z3 <- qnorm(u3)
  x3    <- m312 + sqrt(v312) * z3

  c(x1, x2, x3)
}
손으로 연산만 해도 굉장히 힘들며 오래 걸립니다. 식을 매번 구해야 된다는 단점이 있기 때문이죠. 추가적으로 Inverse CDF 도 매번 구해야 되는 단점도 있으며 이게 존재하지 않을 수도 있습니다.
반면에 Rejection Method 를 다변량에 적용시키면 어떨까요? 똑같은 방법으로 적용시키면 되지만, 좋은 Proposal Density q q q
Multivariate Normal Distribution 다변량 정규 분포 X ∼ N n ( μ , Σ ) \mathbf{X} \sim \mathrm{N}_n\left(\boldsymbol{\mu}, \mathbf{\Sigma}\right) X ∼ N n ( μ , Σ )
f ( x ) = det ( 2 π Σ ) − 1 / 2 ⋅ exp { − 1 2 ( x − μ ) ⊤ Σ − 1 ( x − μ ) } f(\mathbf{x}) = \det\left( 2 \pi \mathbf{\Sigma} \right)^{-1/2} \cdot \exp\left \{
-\frac 1 2 \left(
\mathbf{x} - \boldsymbol{\mu} \right)^\top \mathbf{\Sigma}^{-1} \left(\mathbf{x} - \boldsymbol{\mu} \right)
\right\} f ( x ) = det ( 2 π Σ ) − 1/2 ⋅ exp { − 2 1 ( x − μ ) ⊤ Σ − 1 ( x − μ ) } 하지만 정규분포들끼리는 서로 선형적인 관계를 가진다는 것을 저희는 알고 있습니다. 다음과 같은 독립적인 분포의 다변량 표준정규분포는 쉽게 뽑을 수가 있습니다. 그저 표준정규분포에서 i.i.d 하게 뽑은 다음에 그것을 벡터 형태로 바꿔주면 되죠.
Z ∼ N m ( 0 m , I m ) ↔ Z i ∼ i.i.d N ( 0 , 1 ) , Z ∈ R m \mathbf{Z} \sim \mathrm{N}_m(\mathbf{0}_m, \mathbf{I}_m) \leftrightarrow Z_i \stackrel{\text{i.i.d}}{\sim} \mathrm{N}(0,1), \quad \mathbf{Z}\in \mathbb{R}^{m} Z ∼ N m ( 0 m , I m ) ↔ Z i ∼ i.i.d N ( 0 , 1 ) , Z ∈ R m X \mathbf{X} X
X = A Z + μ ∼ N n ( μ , A A ⊤ ) , X ∈ R n , A ∈ R n × m \mathbf{X} = \mathbf{A} \; \mathbf{Z} \; + \; \boldsymbol{\mu} \; \sim \; \mathrm{N}_n\left(\boldsymbol{\mu}, \mathbf{A} \mathbf{A}^\top \right), \quad
\mathbf{X} \in \mathbb{R}^{n}, \; \mathbf{A} \in \mathbb{R}^{n \times m} X = A Z + μ ∼ N n ( μ , A A ⊤ ) , X ∈ R n , A ∈ R n × m 이때의 가정은 A A ⊤ \mathbf{AA}^\top AA ⊤
그러면 만약에 X \mathbf{X} X Σ = A A ⊤ \mathbf{\Sigma} = \mathbf{AA}^\top Σ = AA ⊤ A \mathbf{A} A X : = A Z + μ \mathbf{X} := \mathbf{AZ}+\boldsymbol \mu X := AZ + μ X \mathbf{X} X
이때 Cholesky Decomposition 을 활용해서 A \mathbf{A} A
Cholesky Decomposition 이란 Σ \mathbf{\Sigma} Σ A \mathbf{A} A Σ = A A ⊤ \mathbf{\Sigma} = \mathbf{AA}^\top Σ = AA ⊤
이것을 위의 예시 문제에 다시 한번 적용시켜보겠습니다.
( X 1 X 2 X 3 ) ∼ N ( [ 0 0 0 ] , [ 1.0 0.4 0.2 0.4 1.5 0.3 0.2 0.3 2.0 ] ) \left(\begin{aligned}
X_1 \\
X_2 \\
X_3
\end{aligned}\right) \sim
\mathrm{N}
\left(\left[\begin{matrix}
0 \\ 0 \\ 0
\end{matrix}\right],
\left[\begin{matrix}
1.0 & 0.4 & 0.2 \\
0.4 & 1.5 & 0.3 \\
0.2 & 0.3 & 2.0
\end{matrix}\right]
\right) X 1 X 2 X 3 ∼ N 0 0 0 , 1.0 0.4 0.2 0.4 1.5 0.3 0.2 0.3 2.0 n <- 10000
d <- 3
z_vals <- qnorm(runif(n * d))
z_mat <- matrix(data = z_vals, nrow = 3)
mu <- c(0, 0, 0)
Sigma <- matrix(c(
1.0, 0.4, 0.2,
0.4, 1.5, 0.3,
0.2, 0.3, 2.0
), nrow = 3, byrow = TRUE)
A <- t(chol(Sigma))
X <- A %*% z_mat + mu이렇게 진행하게 된다면 위의 Inverse CDF 방법보다 더 빠르게 샘플링을 할 수 있게 됩니다.
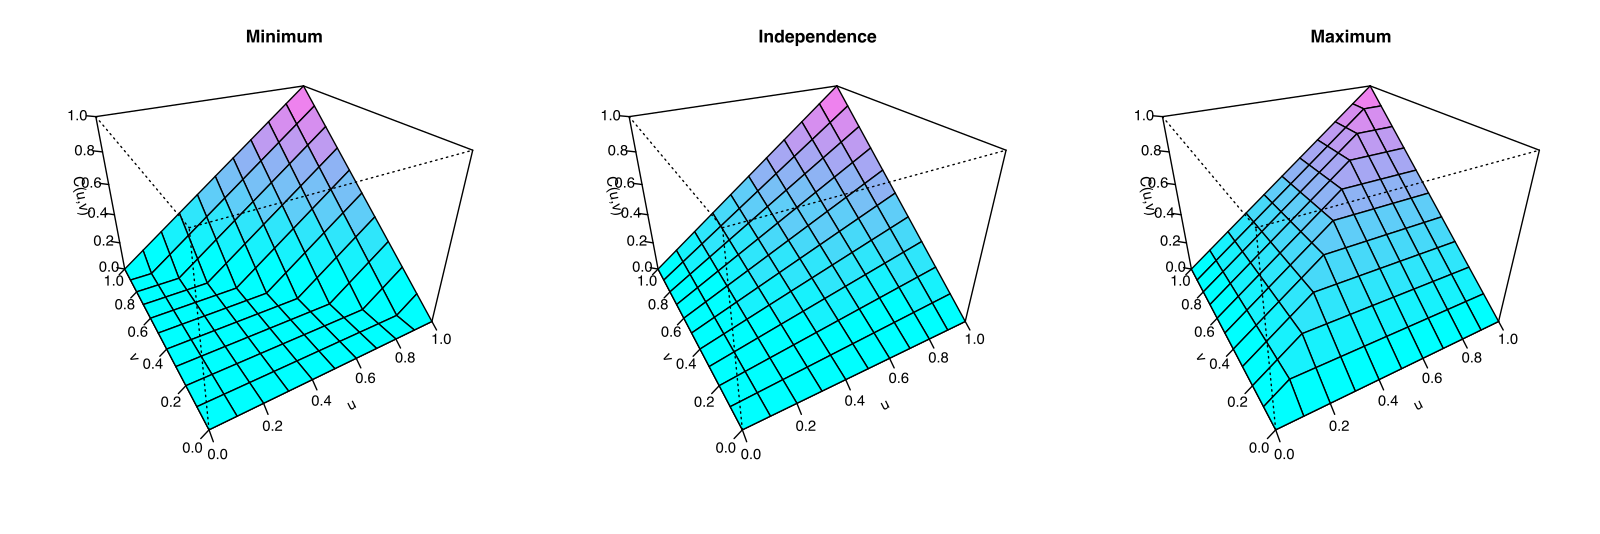
Copulas (Joint Distributions) Copula 란 그저 [ 0 , 1 ] d [0,1]^d [ 0 , 1 ] d
예시로 2-차원일 때의 Copula 는 C ( x , y ) , 0 ≤ x ≤ 1 , 0 ≤ y ≤ 1 C(x,y), \; 0 \le x \le 1, \; 0\le y \le 1 C ( x , y ) , 0 ≤ x ≤ 1 , 0 ≤ y ≤ 1
C ( x , 0 ) = 0 , C ( 0 , y ) = 0 , C(x,0) = 0, \quad C(0, y) = 0, C ( x , 0 ) = 0 , C ( 0 , y ) = 0 , C ( x , 1 ) = x , C ( 1 , y ) = y C(x,1) = x, \quad C(1,y) = y C ( x , 1 ) = x , C ( 1 , y ) = y 이 예시를 이어가서 만약에 Joint Distribution 이 ( X , Y ) ∼ H (X,Y) \sim H ( X , Y ) ∼ H X ∼ F X\sim F X ∼ F Y ∼ G Y\sim G Y ∼ G H H H C H C_H C H
C H ( x , y ) = P r { F ( X ) ≤ x , G ( Y ) ≤ y } = P r { X ≤ F − 1 ( x ) , Y ≤ G − 1 ( y ) } = H ( F − 1 ( x ) , G − 1 ( y ) ) \begin{aligned}
C_H(x,y) &= \mathrm{Pr}\left\{ F(X) \le x, G(Y) \le y\right\} \\
& = \mathrm{Pr}\left\{
X \le F^{-1}(x), Y \le G^{-1}(y)
\right\} \\
& = H\left(
F^{-1}(x), G^{-1}(y)
\right)
\end{aligned} C H ( x , y ) = Pr { F ( X ) ≤ x , G ( Y ) ≤ y } = Pr { X ≤ F − 1 ( x ) , Y ≤ G − 1 ( y ) } = H ( F − 1 ( x ) , G − 1 ( y ) ) 이를 Sklar’s 정리에 의해서 Copula 도 알고 Marginal 도 안다면 다음과 같이 Joint Distribution 인 H ( x , y ) H(x,y) H ( x , y )
H ( x , y ) = P r { X ≤ x , Y ≤ y } = P r { F ( X ) ≤ F ( x ) , G ( Y ) ≤ G ( y ) } = C H ( F ( x ) , G ( y ) ) \begin{aligned}
H(x,y) &= \mathrm{Pr}\left\{
X \le x, Y \le y\right\} \\
&= \mathrm{Pr}\left\{
F(X) \le F(x), G(Y) \le G(y)
\right\} \\
& = C_H\left(F(x), G(y) \right)
\end{aligned} H ( x , y ) = Pr { X ≤ x , Y ≤ y } = Pr { F ( X ) ≤ F ( x ) , G ( Y ) ≤ G ( y ) } = C H ( F ( x ) , G ( y ) ) 이게 무슨 말이냐면, ( U 1 , U 2 ) (U_1, U_2) ( U 1 , U 2 ) C H C_H C H U 1 U_1 U 1 U 2 U_2 U 2 X = F − 1 ( U 1 ) , Y = G − 1 ( U 2 ) X = F^{-1}(U_1), \; Y = G^{-1}(U_2) X = F − 1 ( U 1 ) , Y = G − 1 ( U 2 )
반대로 얘기하자면, ( X , Y ) ∼ H (X,Y) \sim H ( X , Y ) ∼ H U 1 = F ( X ) , U 2 = G ( Y ) U_1 = F(X), \; U_2 = G(Y) U 1 = F ( X ) , U 2 = G ( Y ) ( U 1 , U 2 ) ∼ C H (U_1, U_2) \sim C_H ( U 1 , U 2 ) ∼ C H
예시로 Gaussian Copula 를 보겠습니다.
Gaussian Copula Copula 는 그저 [ 0 , 1 ] d [0,1]^d [ 0 , 1 ] d ( X , Y ) (X,Y) ( X , Y )
( X Y ) ∼ N 2 ( ( 0 0 ) , [ 1 ρ ρ 1 ] ) \left(\begin{matrix}
X \\ Y
\end{matrix} \right) \sim \mathrm{N}_2\left(
\left(\begin{matrix}
0 \\ 0
\end{matrix} \right),
\left[\begin{matrix}
1 & \rho \\ \rho & 1
\end{matrix}\right]
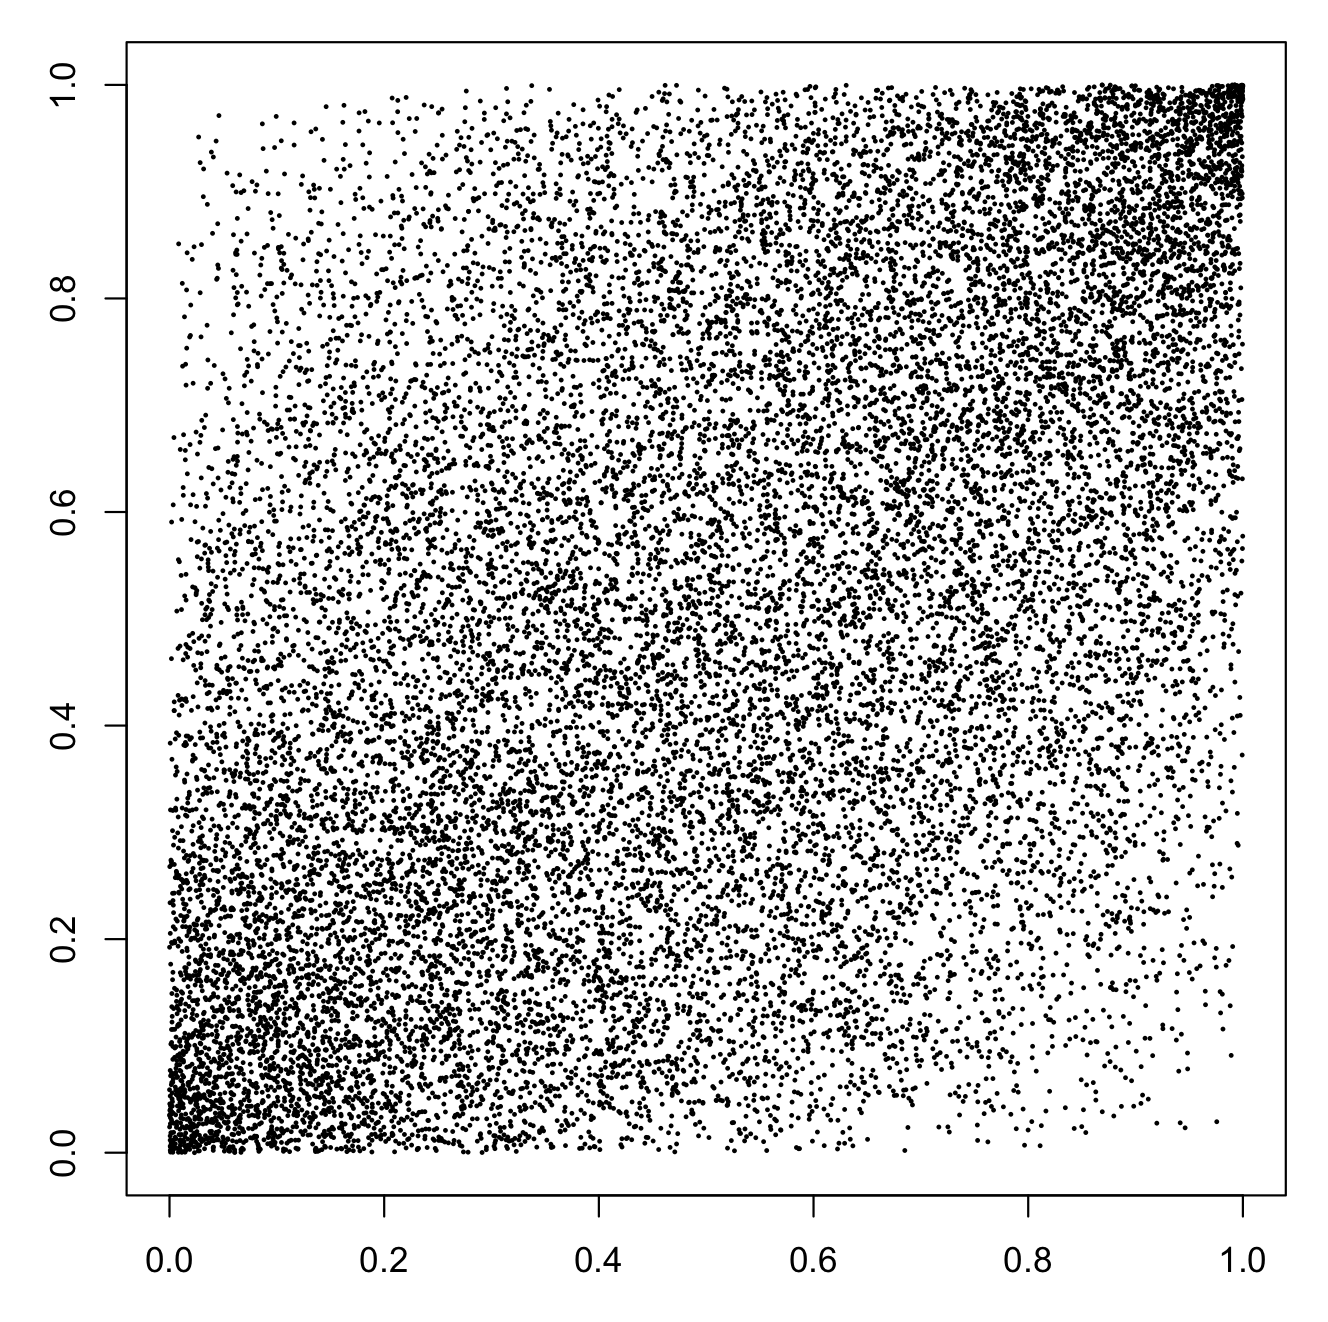
\right) ( X Y ) ∼ N 2 ( ( 0 0 ) , [ 1 ρ ρ 1 ] ) 그러면 Φ ( X ) \Phi(X) Φ ( X ) Φ ( Y ) \Phi(Y) Φ ( Y ) ρ = 0.5 \rho = 0.5 ρ = 0.5
rm(list=ls())
n <- 20000
rho = 0.5

x <- qnorm(runif(n))
z_2 <- qnorm(runif(n))
y <- x * rho + sqrt(1 -
      rho^2) * z_2

u_1 <- pnorm(x)
u_2 <- pnorm(y)

plot(u_1, u_2, cex = 0.25,
		pch = 20)
이런 방식으로 Copula 에서 뽑는 것이 가능합니다. 위의 코드에서는 사실 다음과 같이 흘러갑니다.
그 다음에 Y Y Y Y = ρ σ 2 Z 1 + σ 2 1 − ρ 2 Z 2 + μ 2 Y = \rho \sigma_2 Z_1 + \sigma_2 \sqrt{1-\rho^2}Z_2 + \mu_2 Y = ρ σ 2 Z 1 + σ 2 1 − ρ 2 Z 2 + μ 2 U 1 : = F ( X ) U_1 := F(X) U 1 := F ( X ) U 2 : = G ( Y ) U_2 := G(Y) U 2 := G ( Y ) 위의 방법이 사실상 Copula 부분에서 설명한 것이랑 정확히 똑같습니다.
이 방법을 활용시켜서 다음과 같은 예시에 적용해보겠습니다.
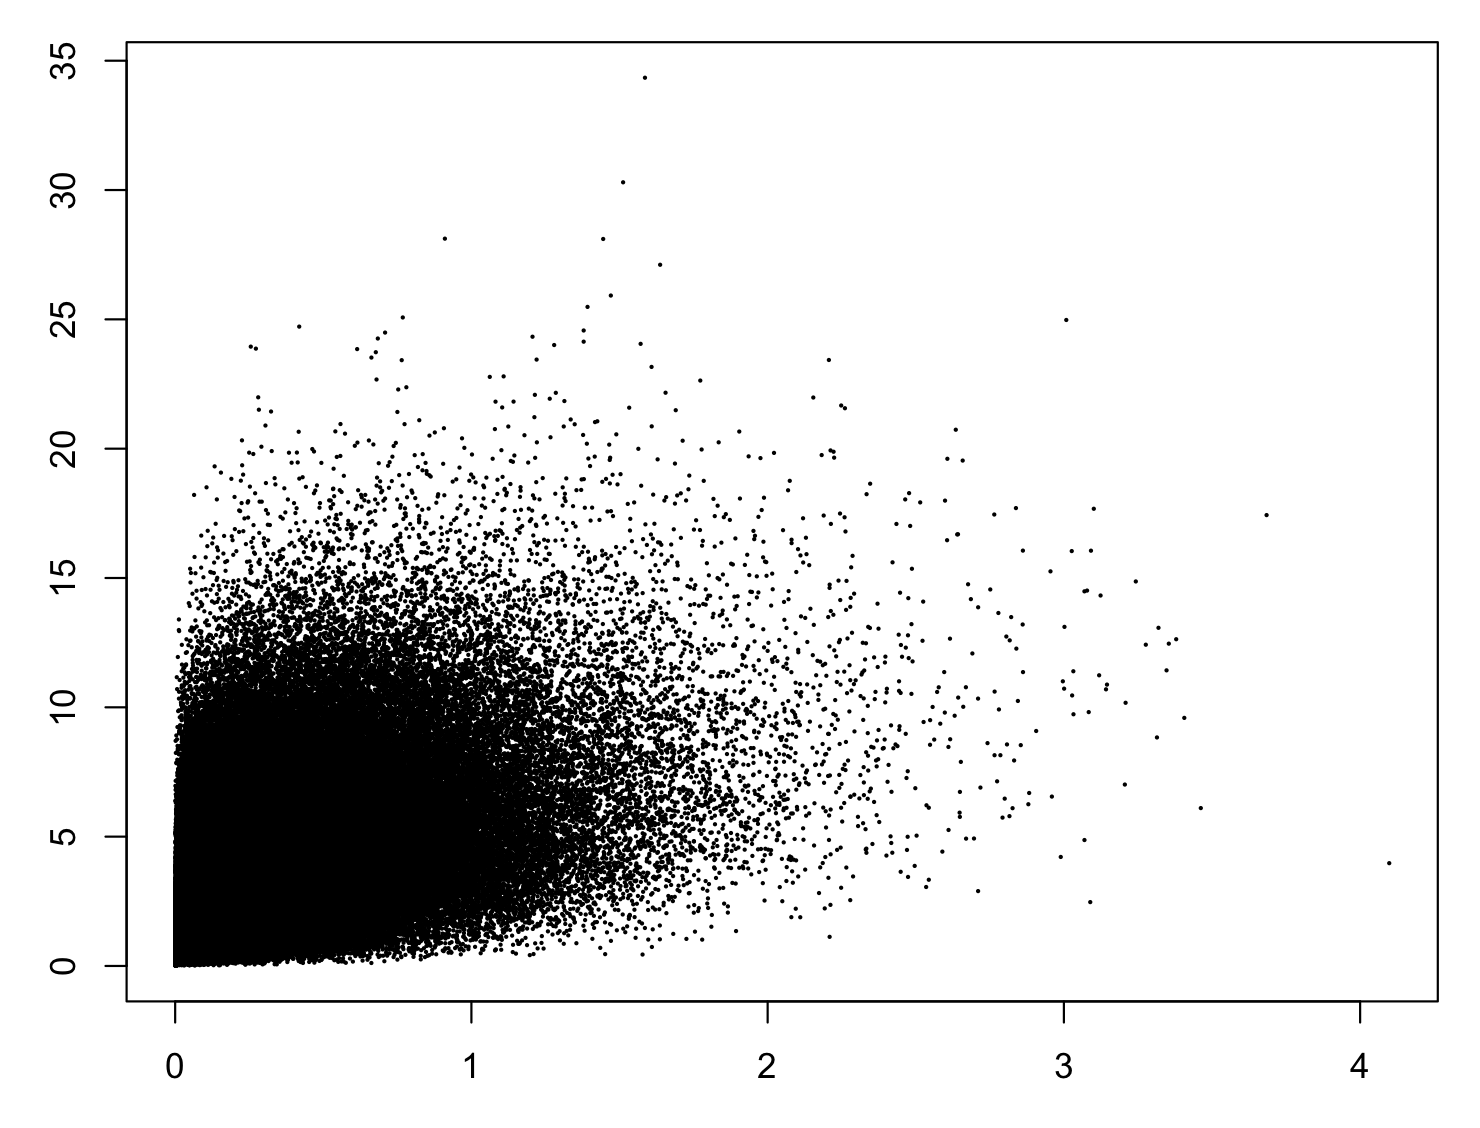
예시 문제 X ∼ E x p ( 3 ) , Y ∼ Γ ( 2 , 2 ) X \sim \mathrm{Exp}(3), \; Y \sim \Gamma(2, 2) X ∼ Exp ( 3 ) , Y ∼ Γ ( 2 , 2 ) C o r r ( X , Y ) = ρ = 0.5 \mathrm{Corr}(X, Y) = \rho = 0.5 Corr ( X , Y ) = ρ = 0.5 ( X , Y ) (X,Y) ( X , Y )
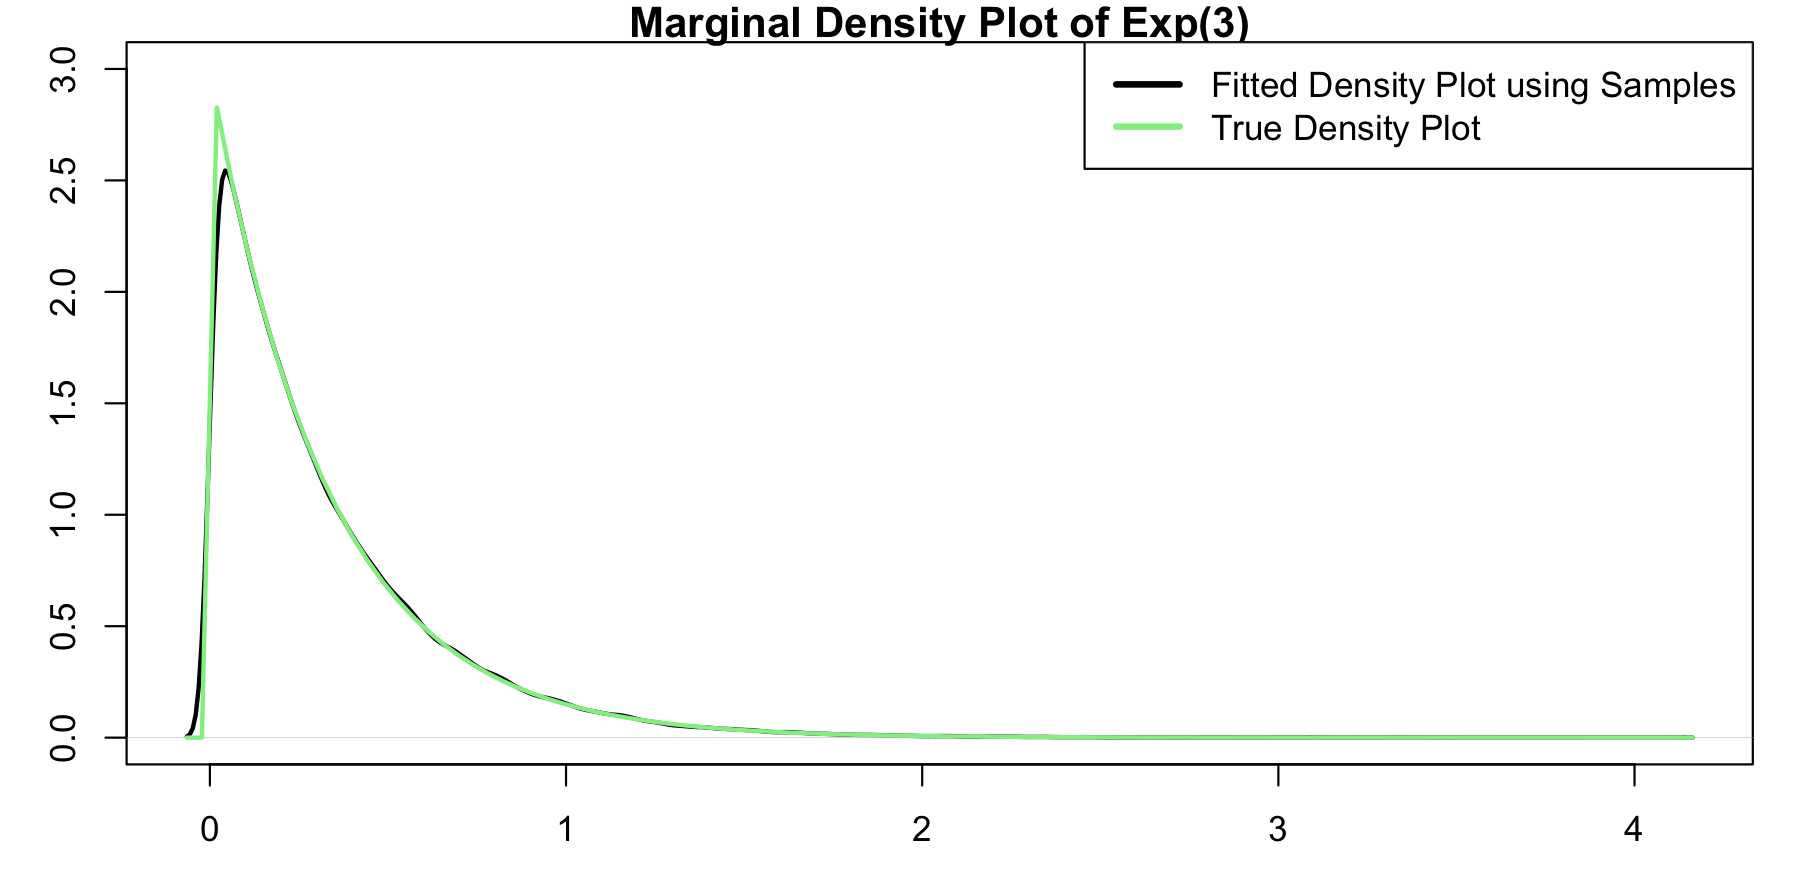
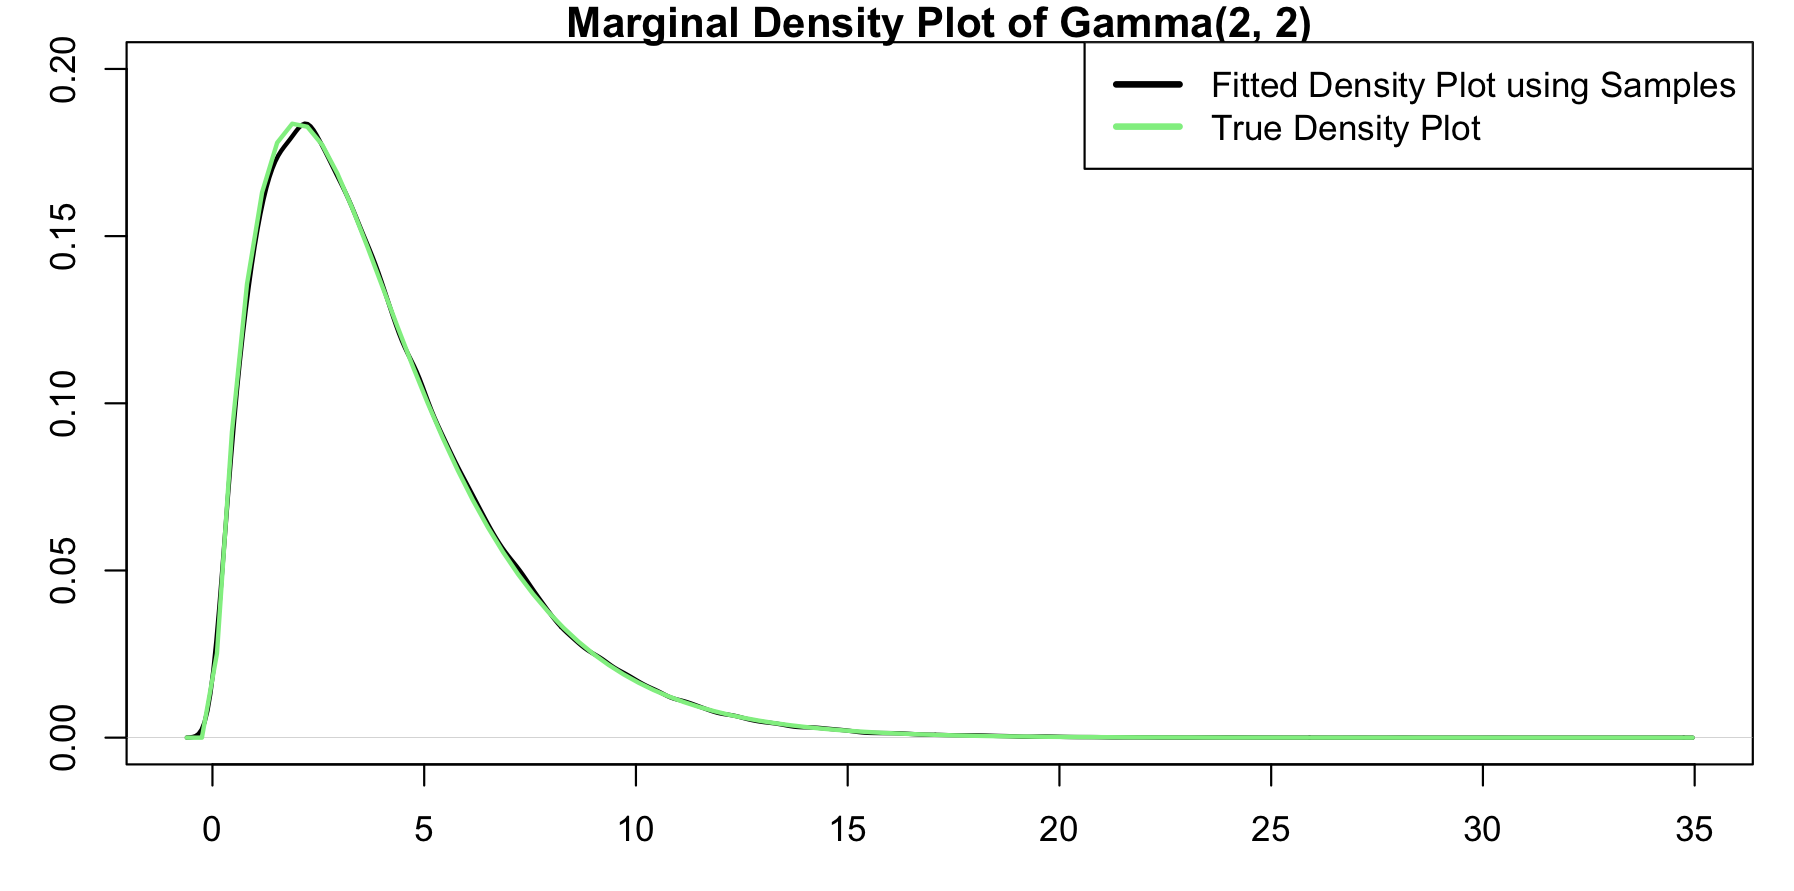
우선은 ρ = 0.5 \rho = 0.5 ρ = 0.5 ( U 1 , U 2 ) (U_1, U_2) ( U 1 , U 2 ) 0.5 0.5 0.5 X : = F − 1 ( U 1 ) , Y : = G − 1 ( U 2 ) X:= F^{-1}(U_1), \; Y:= G^{-1}(U_2) X := F − 1 ( U 1 ) , Y := G − 1 ( U 2 ) Marginal 들을 그려주면 다음과 같습니다.
X X X Y Y Y
N = 10000
rho = -0.5

x = qnorm(runif(N))
z_2 = qnorm(runif(N))
y = x * rho + sqrt(1 - rho^2) * z_2

plot(x,y, cex = 0.2, pch = 20) # Joint Distribution of Gaussian

u_1 <- pnorm(x)
u_2 <- pnorm(y)

plot(u_1, u_2, cex = 0.2, pch = 20) # Gaussian Copula

new_x <- qexp(u_1, 3)
new_y <- qgamma(u_2, 2, scale = 2)

plot(new_x, new_y, cex = 0.2, pch = 20) # Joint Distribution

hist(new_x, breaks = 100)
hist(new_y, breaks = 100)
이것이 가능한 이유는 사실은 다음과 같이 Copula 에 Monte-Carlo 를 적용시키는 것이 가능하기 때문입니다.
E [ g ( X 1 , ⋯ , X d ) ] = ∫ g ( x 1 , ⋯ , x d ) d H ( x 1 , ⋯ , x d ) = ∫ g ( x 1 , ⋯ , x d ) d C ( F 1 ( x 1 ) , … , F d ( x d ) ) = ∫ [ 0 , 1 ] d g ( F − 1 ( u 1 ) , ⋯ , F − 1 ( u d ) ) d C ( u 1 , … , u d ) = E [ g ( F 1 − 1 ( U 1 ) , ⋯ , F d − 1 ( U d ) ) ] , ( U 1 , ⋯ , U d ) ∼ C . \begin{aligned}E\left[g\left(X_1, \cdots, X_d\right)\right] & =\int g\left(x_1, \cdots, x_d\right) d H\left(x_1, \cdots, x_d\right) \\& =\int g\left(x_1, \cdots, x_d\right) d C\left(F_1\left(x_1\right), \ldots, F_d\left(x_d\right)\right) \\& =\int_{[0,1]^d} g\left(F^{-1}\left(u_1\right), \cdots, F^{-1}\left(u_d\right)\right) d C\left(u_1, \ldots, u_d\right) \\& =E\left[g\left(F_1^{-1}\left(U_1\right), \cdots, F_d^{-1}\left(U_d\right)\right)\right], \quad\left(U_1, \cdots, U_d\right) \sim C .\end{aligned} E [ g ( X 1 , ⋯ , X d ) ] = ∫ g ( x 1 , ⋯ , x d ) d H ( x 1 , ⋯ , x d ) = ∫ g ( x 1 , ⋯ , x d ) d C ( F 1 ( x 1 ) , … , F d ( x d ) ) = ∫ [ 0 , 1 ] d g ( F − 1 ( u 1 ) , ⋯ , F − 1 ( u d ) ) d C ( u 1 , … , u d ) = E [ g ( F 1 − 1 ( U 1 ) , ⋯ , F d − 1 ( U d ) ) ] , ( U 1 , ⋯ , U d ) ∼ C . 만약에 Copula C C C
번외 Marshall-Olkin Copula 란 그저 Copula 를 Multivariate Exponential 에 적용시킨 Copula 입니다.