5장 Statistical Analysis of Simulated Data
- Successive Computation
- Bootstrapping
이번 장에서는 이미 일어난 일에 대한 통계적 분석을 진행하는 내용입니다.
Successive Computation
수통 2 에서 배웠듯이 저희가 원하는 추정량은 다음과 같은 3 가지 성질을 만족시키는 추정량입니다.
- Unbiasedness - 추정량에 대한 기댓값이 우리의 모수다.
- Consistency - 추정량이 모수로 분포수렴한다.
- Efficiency - 추정량의 분산이 Cramer-Rao Lower Bound 이다.
, 평균이 그리고 분산이 이라고 한다면,
- 표본평균 는 에 대해서 Unbiased 하다,
- 표본분산 는 에 대해서 Unbiased 하다,
표본 평균의 분산은 뭘까?
아무리 이 크더라도 우리의 표본평균의 분산은 Sample Size 가 늘어날 수록 줄어들 수가 있습니다.
한 마디로 그냥 을 키워서 많이 뽑게 된다면 가 더 정확해진다는 얘기입니다.
그러면 언제까지 을 키우는게 적당할까요?
By CLT
CLT 에 의하면 에 대해서 다음과 같이 둘 수가 있다고 말합니다.
General 하게 표현하자면,
그러면 저희는 예시로 이라 한다면, 이 만족이 됩니다. 이것을 활용하면, 다음과 같이 알고리즘을 구성할 수 있습니다.
- 으로 먼저 세팅해줍니다. 이게 저희의 Threshold 이 됩니다.
- 최소한 개의 들을 샘플해줍니다 (CLT 를 만족하기 위해서).
- 가 만족이 될 때까지 추가적인 들을 샘플해줍니다.
- 으로 두어줍니다.
이것을 직접 해보면 다음 코드 처럼 나옵니다.
n = 1
x_list = c(rnorm(1, 10, 2))
x_bar = 0
x_bar_SE = 1000
d = 0.01 / 1.96

start <- Sys.time()
while(TRUE){
  x = rnorm(1, 10, 2)
  n = n + 1
  x_list = c(x_list, x)
  x_bar = mean(x_list)
  x_bar_SE = var(x_list)

  if(x_bar_SE / sqrt(n) < d){
    break
  }
}
end <- Sys.time()
elapsed <- end - start
cat("Time Elapsed : ", elapsed, "\nn : ", n, "\nActual Error : ", abs(x_bar - 10))
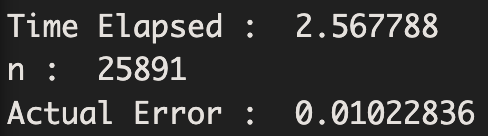
결과로는 굉장히 오래 걸리며, 이는 큰 값에 대해서는 오래 걸린다는 단점이 존재합니다.
그러면 어떻게 이것을 효율적으로 할까요? 바로 Sucessive Computation 을 활용하는 것입니다.
이렇게 진행한다면 기존의 리스트를 모두 저장할 필요 없이 와 만으로 구하는게 가능해집니다.
코드로 위와 똑같은 예시를 갖고온다면, 다음과 같습니다.
n = 0
x_bar = 0
x_bar_SE = 0

d = 0.01 / 1.96

# j + 1 = 1
x = rnorm(1, 10, 2)
x_bar = x_bar + (x - x_bar) / (n + 1)
x_bar_SE = 0
n = n + 1

# j = 1, j + 1 = 2
start <- Sys.time()
while(TRUE){
  x = rnorm(1, 10, 2)
  old_x_bar = x_bar
  x_bar = old_x_bar + (x - old_x_bar) / (n + 1)
  x_bar_SE = (1 - 1/n) * x_bar_SE + (n + 1) * (x_bar - old_x_bar)^2


  n = n + 1
  if(x_bar_SE / sqrt(n) < d){
    break
  }
}
end <- Sys.time()
elapsed <- end - start
cat("Time Elapsed : ", elapsed, "\nn : ", n, "\nActual Error : ", abs(x_bar - 10))
Bootstrapping
실제 분포가 구하기 어렵지만 그 분포에 대한 일부 샘플들이 있으면 샘플들만을 이용해서 실제 통계량에 대한 분포를 추정하는 방법입니다.
Resampling 을 활용시키며, 알고리즘은 다음과 같습니다.
- 저희의 샘플 (데이터) 가 이라고 하겠습니다.
- 에서 까지 다음 루프를 돌립니다.
- With Replacement (복원 추출) 으로 을 뽑습니다.
- 이 샘플들을 활용해서 저희가 궁금한 통계량 을 구해줍니다.
- 2번을 반복하면 가 있으며, 이것을 활용해서 실제 통계량 에 대한 Empirical 분포를 구할 수가 있게 됩니다.
왜 이게 될까요? (수업에는 없음)
- Glivenko–Cantelli theorem 에 의하면 Empirical CDF 이 Population CDF 으로 Uniformly Converge 합니다.
- 통계량 가 에 대한 Functional (함수에 대한 함수) 으로 바라볼 수가 있습니다.
- 가 적당히 Smooth 하다면, 은 에 대해서 Linearly 하게만 Dependent 합니다.
예시 문제 1 :
데이터가 으로 주어졌으며 표본 Median 이 일 때 이것에 대한 MSE 를 추정하고 싶다면?
x <- c(5, 7, 11)
B = 100000
mse_list = rep(NA, B)
for(b in 1:B){
  rint <- ceiling(runif(3) * 3)
  mse_b <- (median(x[rint]) - 7) ** 2
  mse_list[b] <- mse_b
}
mean(mse_list)
예시 문제 2 :
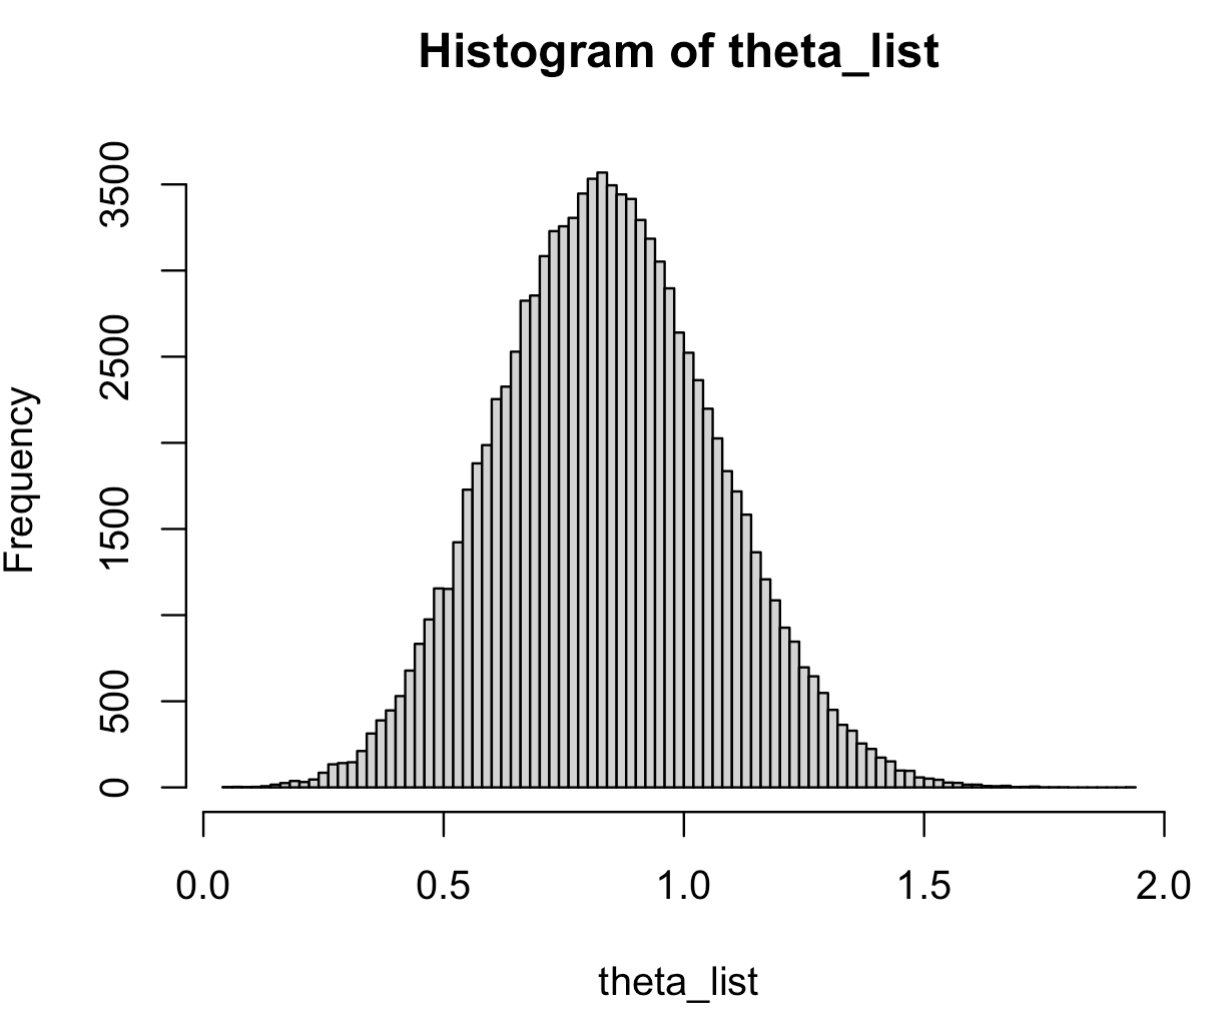
CLT 를 보여주고 싶다고 하자. 근데 우리의 데이터가 개만 있다고 가정해보자. 그럴 때 CLT 를 어떻게 보이지?
n = 10
x <- rexp(n)
B = 100000
theta_list = rep(NA, B)

for(b in 1:B){
  rint <- ceiling(runif(n) * n)
  x_samples = x[rint]
  theta_list[b] <- mean(x_samples)
}

hist(theta_list, breaks = 100)
mean(theta_list)