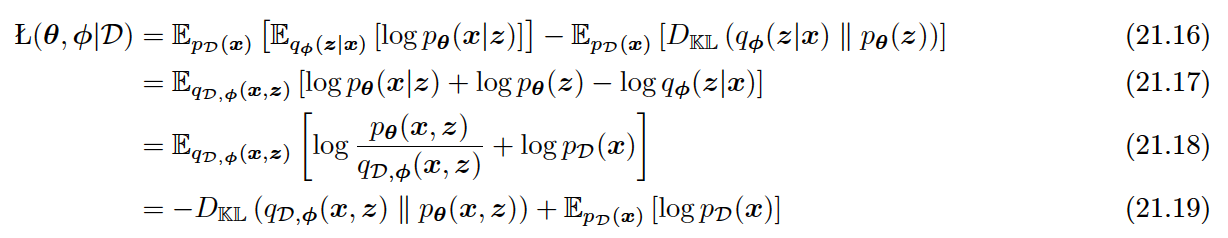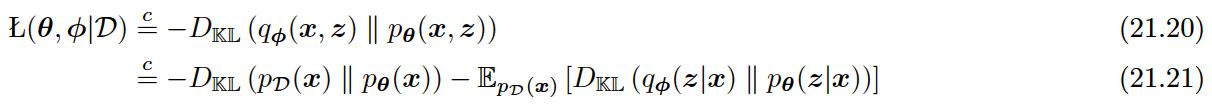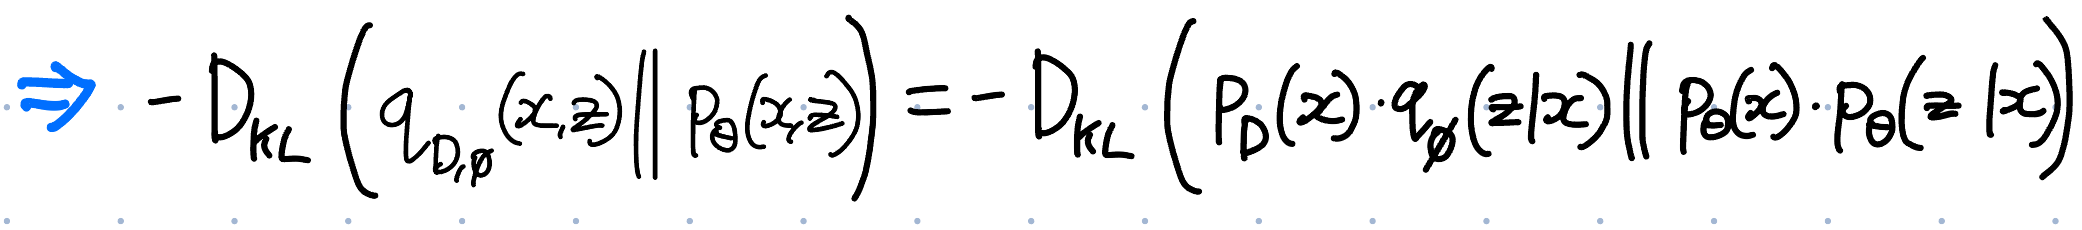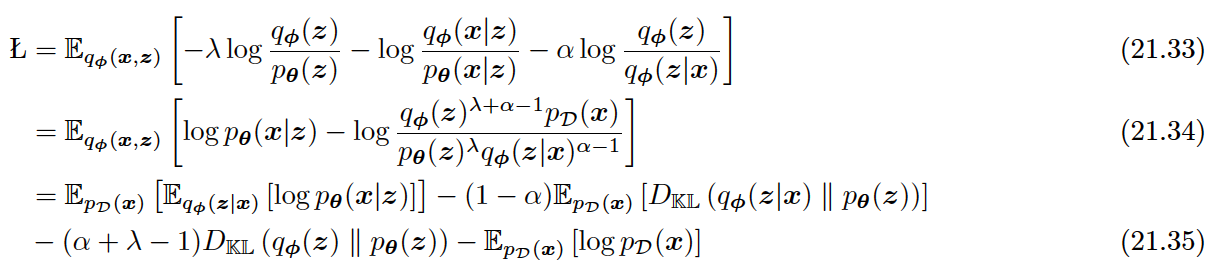21.3 - VAE Generalizations (간단하게 Motivation + 컨셉까지만)
21.4 - Avoiding Posterior Collapse
21.1 Introduction Generative Models / 생성모델 - 데이터셋 X \mathcal X X
우리의 데이터 x \mathbf{x} x q ( z ∣ x ) q(\mathbf{z}\mid \mathbf x) q ( z ∣ x ) z \mathrm{z} z p ( x ∣ z ) p(\mathbf x \mid \mathbf z) p ( x ∣ z )
이 장에서 z , x ∣ z \mathrm z, \mathbf x \mid \mathrm z z , x ∣ z
z ∼ p θ ( z ) \mathbf z \sim p_{\boldsymbol \theta}(\mathbf z) z ∼ p θ ( z ) x ∣ z ∼ E x p f a m ( x ∣ d θ ( z ) ) \mathbf x \mid \mathbf z \sim \mathrm{Expfam}\left(
\mathbf x \mid d_{\boldsymbol \theta}\left(\mathbf z\right)
\right) x ∣ z ∼ Expfam ( x ∣ d θ ( z ) ) p ( z ) : p(\mathbf z) : p ( z ) : z \mathbf z z d θ ( z ) : d_{\boldsymbol \theta}(\mathbf z) : d θ ( z ) : E x p f a m ( x ∣ η ) : \mathrm{Expfam}\left(
\mathbf x \mid \mathbf \eta
\right) : Expfam ( x ∣ η ) : Message Passing Algorithms 개념을 빌리자면,
p ( z ∣ x ) : p(z \mid x) : p ( z ∣ x ) : x x x z z z p ( x ∣ z ) : p(x \mid z) : p ( x ∣ z ) : z z z x x x z z z VI 개념을 빌리자면, p ( z ∣ x ) = p ( x ∣ z ) p ( z ) p ( x ) p(z \mid x) = \frac{p(x \mid z) p(z)}{p(x)} p ( z ∣ x ) = p ( x ) p ( x ∣ z ) p ( z ) p ( x ) = ∫ p ( x ∣ z ) p ( z ) d z p(x) = \int p(x \mid z) p(z) dz p ( x ) = ∫ p ( x ∣ z ) p ( z ) d z q q q p p p
z z z p ( x ∣ z ) p(x\mid z) p ( x ∣ z ) p ( x ∣ z ) p(x\mid z) p ( x ∣ z ) z z z
21.2 VAE Basics 아주 기본적인 세팅에서 VAE 의 생성모델 부분 (Generative Model) 이 정의해주는 것은 :
p θ ( z , x ) = p θ ( z ) p θ ( x ∣ z ) p_{\boldsymbol{\theta}}(\boldsymbol{z}, \boldsymbol{x})=
p_{\boldsymbol{\theta}}(\boldsymbol{z})
p_{\boldsymbol{\theta}}(\boldsymbol{x} \mid \boldsymbol{z}) p θ ( z , x ) = p θ ( z ) p θ ( x ∣ z ) p θ ( z ) : p_{\boldsymbol{\theta}}(\boldsymbol{z}) : p θ ( z ) : z z z p θ ( x ∣ z ) = ∏ d = 1 D B e r ( x d ∣ σ ( d θ ( z ) ) : p_{\boldsymbol{\theta}}(\boldsymbol{x} \mid \boldsymbol{z}) = \prod_{d=1}^{D}\mathrm{Ber}\left(
x_d \mid \sigma\left(
d_{\boldsymbol \theta}(\boldsymbol{z}
\right)
\right) : p θ ( x ∣ z ) = ∏ d = 1 D Ber ( x d ∣ σ ( d θ ( z ) ) : 아주 기본적인 세팅에서 VAE 의 추론 부분 (Recognition Model) 이 정의해주는 것은 :
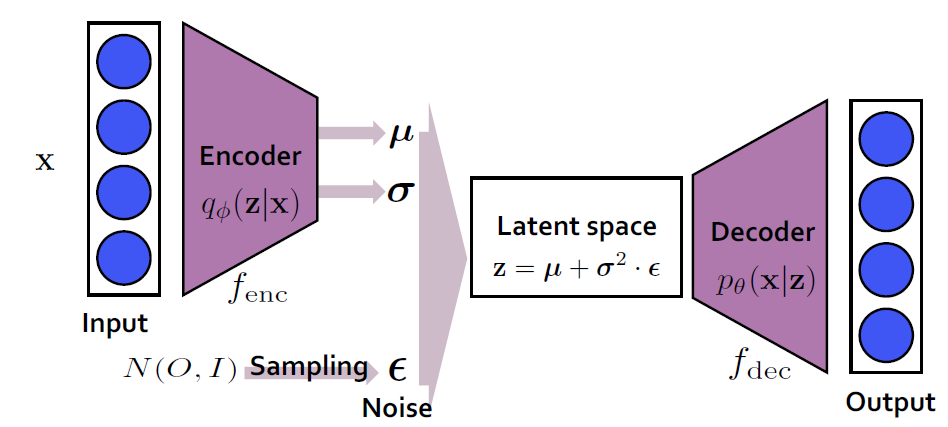
q ϕ ( z ∣ x ) = q ( z ∣ e ϕ ( x ) ) ≈ p θ ( z ∣ x ) q_{\boldsymbol{\phi}}(\boldsymbol{z} \mid \boldsymbol{x})
=q\left(\boldsymbol{z} \mid e_{\boldsymbol{\phi}}(\boldsymbol{x})\right) \approx p_{\boldsymbol{\theta}}(\boldsymbol{z} \mid \boldsymbol{x}) q ϕ ( z ∣ x ) = q ( z ∣ e ϕ ( x ) ) ≈ p θ ( z ∣ x ) q ϕ ( z ∣ x ) = N ( z ∣ μ , diag ( exp ( ℓ ) ) ) : q_{\boldsymbol{\phi}}(\boldsymbol{z} \mid \boldsymbol{x})=\mathcal{N}(\boldsymbol{z} \mid \boldsymbol{\mu}, \operatorname{diag}(\exp (\boldsymbol{\ell}))) : q ϕ ( z ∣ x ) = N ( z ∣ μ , diag ( exp ( ℓ ))) : z z z ( μ , ℓ ) = e ϕ ( x ) : (\boldsymbol{\mu}, \boldsymbol{\ell})=e_{\boldsymbol{\phi}}(\boldsymbol{x}) : ( μ , ℓ ) = e ϕ ( x ) : ℓ = log σ \boldsymbol \ell = \log \boldsymbol \sigma ℓ = log σ p θ ( z , x ) = p θ ( z ) p θ ( x ∣ z ) : p_{\boldsymbol{\theta}}(\boldsymbol{z}, \boldsymbol{x})=
p_{\boldsymbol{\theta}}(\boldsymbol{z})
p_{\boldsymbol{\theta}}(\boldsymbol{x} \mid \boldsymbol{z}) : p θ ( z , x ) = p θ ( z ) p θ ( x ∣ z ) : q ϕ ( z ∣ x ) : q_{\boldsymbol{\phi}}(\boldsymbol{z} \mid \boldsymbol{x}) : q ϕ ( z ∣ x ) : 이것들을 Negative Log-Likelihood (NLL) 형태로 바꿔서 로스 형태로 표현하면 된다.
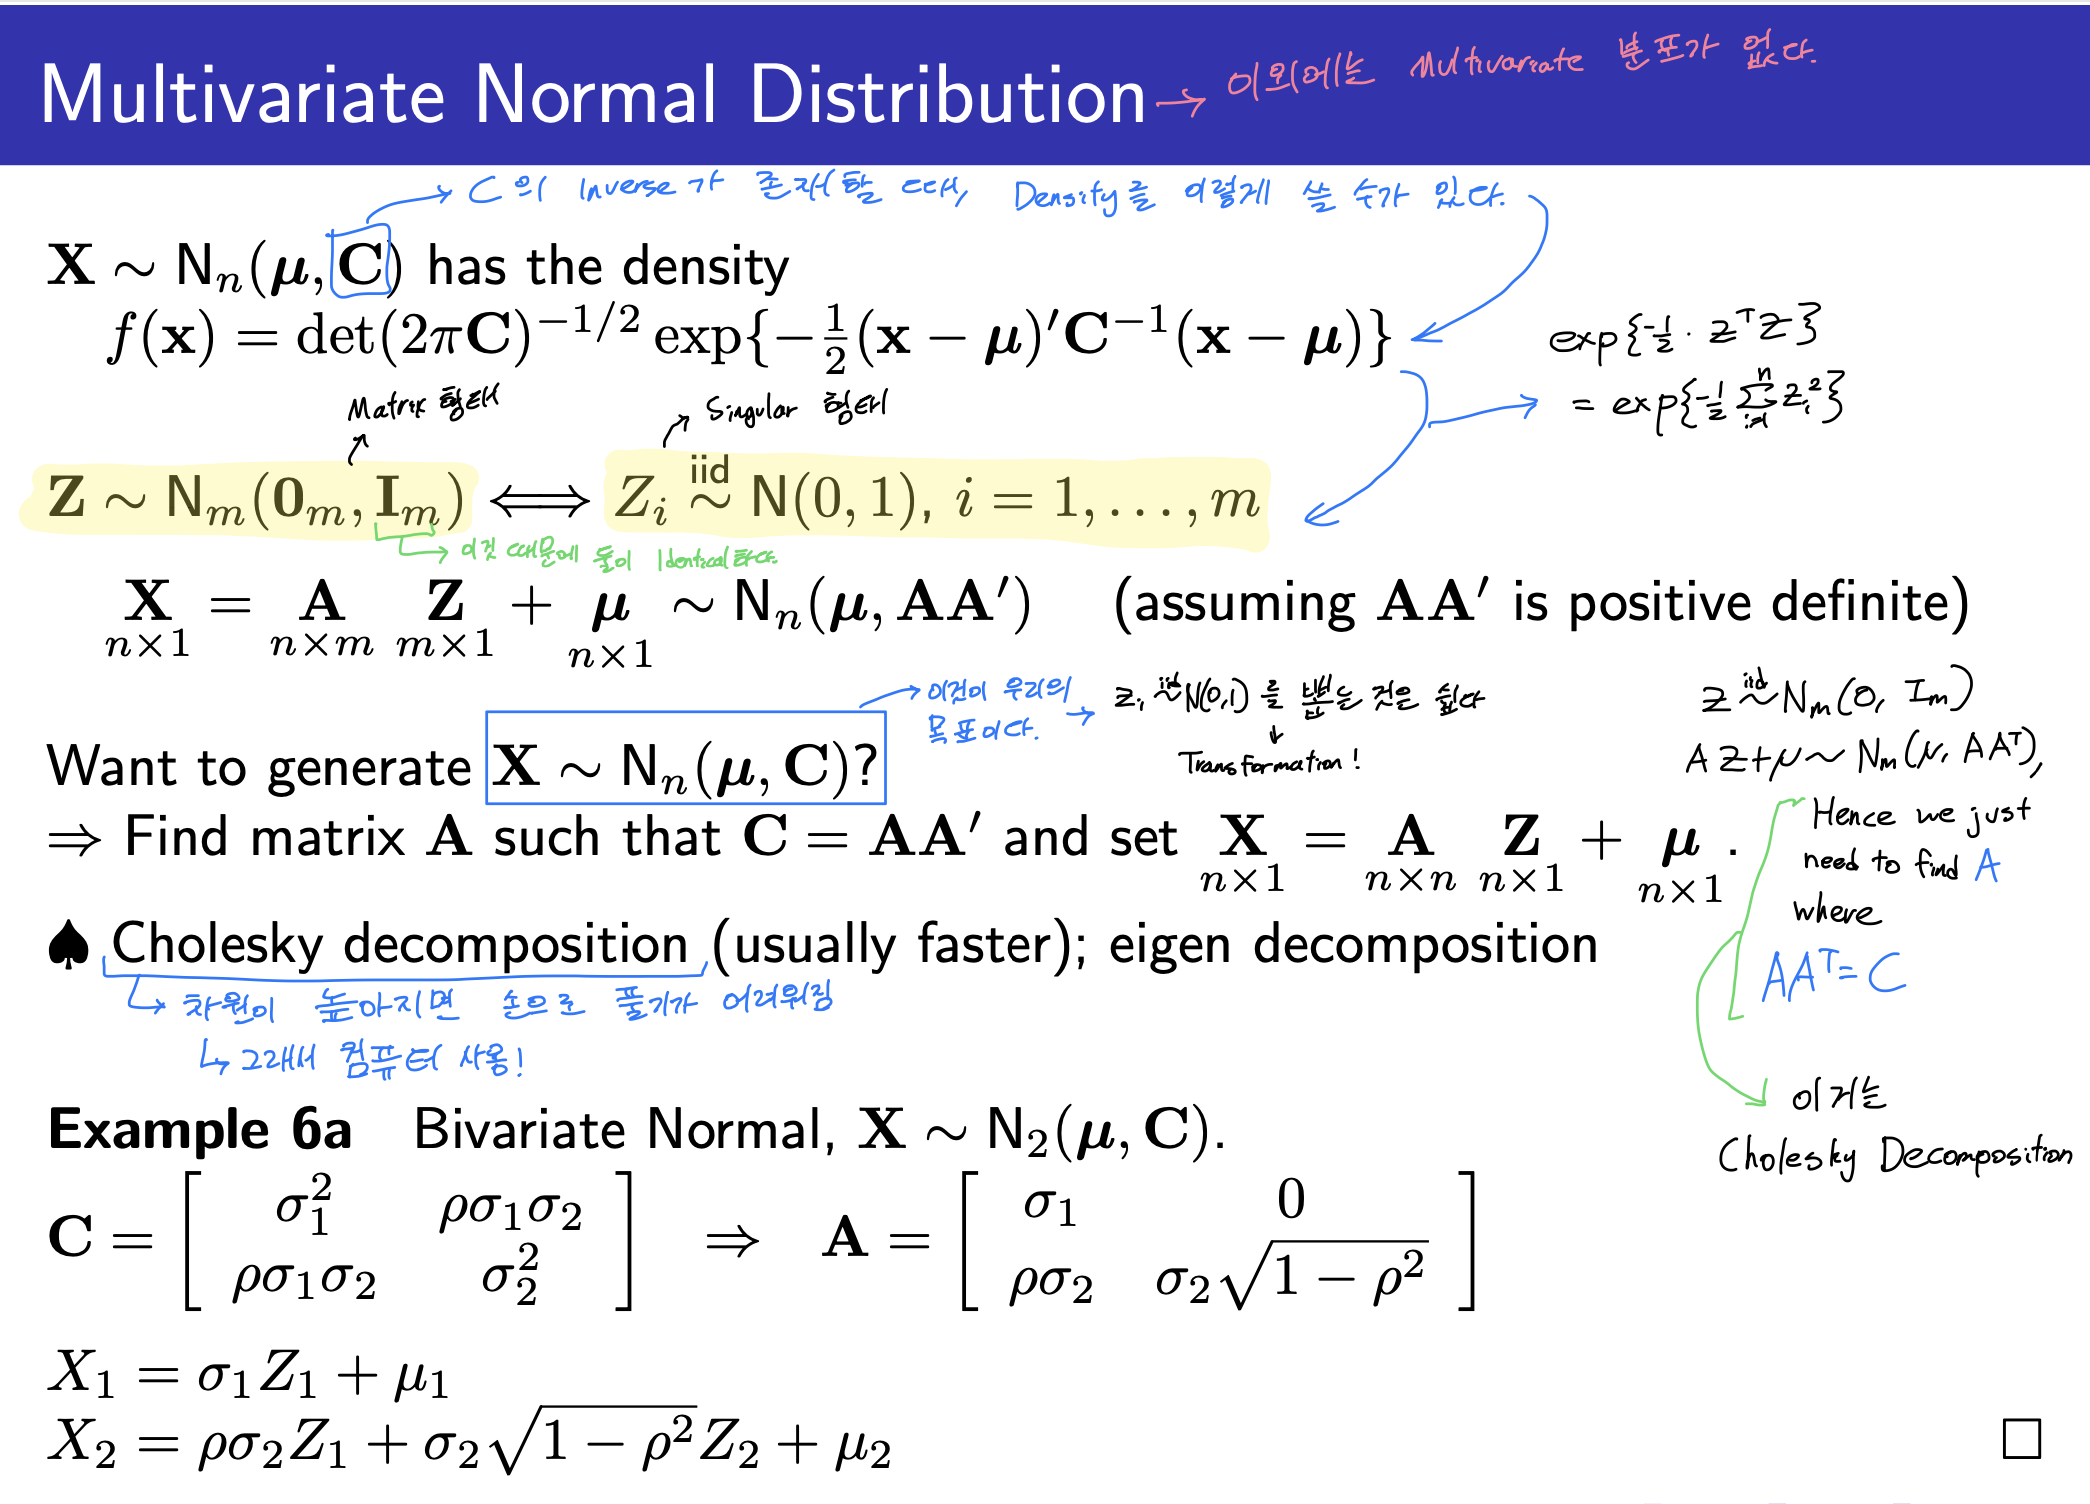
알고리즘은 다음과 같으며, Lines 5-7 부분의 경우에는 Cholesky Decomposition 을 활용해서 다변량 정규분포에서 뽑는 모습. 그러면 여기에서의 Encoder 는 사실은 e ϕ ( x ) e_{\boldsymbol \phi}(\boldsymbol x) e ϕ ( x )
참조 for Multivariate Normal Dist. Sampling using Cholesky Decomposition from 통계전산 강의 (정성현 교수님 강의안)
Covariance Matrix is always PD (아주 특이 케이스 제외하면), hence we can use Cholesky Decomposition.
위의 식에서는 L ′ L^\prime L ′ M M M σ \sigma σ
ε ∼ N \boldsymbol \varepsilon \sim \mathrm{N} ε ∼ N
Z ∼ N ( 0 , 1 ) , a Z + b → D N ( b , a 2 ) Z \sim \mathrm{N}(0, 1), \quad aZ + b \stackrel{D}{\rightarrow}\mathrm{N}(b, a^2) Z ∼ N ( 0 , 1 ) , a Z + b → D N ( b , a 2 ) Line 10 : Computing for the NLL of q ϕ ( z ∣ x ) q_{\boldsymbol{\phi}}(\boldsymbol{z} \mid \boldsymbol{x}) q ϕ ( z ∣ x ) Line 11 : Computing for the NLL of p θ ( z ) p_{\boldsymbol \theta}(\boldsymbol z) p θ ( z ) Line 12 : Computing for the NLL of p θ ( x ∣ z ) p_{\boldsymbol \theta}(\boldsymbol x \mid \boldsymbol z) p θ ( x ∣ z ) 사실 Line 13 에서 정의하는 로스가 그저 -ELBO Term 이 되어버린다. 정확하게는 (w/o considering parameters),
L = − E q [ log p ( x ∣ z ) ] ⏟ L log p x + − E q [ log p ( z ) ] ⏟ L log p z − − E q [ log q ( z ∣ x ) ] ⏟ L log q z = − E L B O = L log p x + L log p z − L log q z = − E q [ log p ( x ∣ z ) ] + E q [ − log p ( z ) + log q ( z ∣ x ) ] = − E q [ log p ( x ∣ z ) ] + K L ( q ( z ∣ x ) ∥ p ( z ) ) \begin{aligned}
L &= \underbrace{-\mathbb{E}_q[\log p(x \mid z)]}_{L_{\log p_x}}
+\underbrace{-\mathbb{E}_q[\log p(z)]}_{L_{\log p_z}}
-\underbrace{-\mathbb{E}_q[\log q(z \mid x)]}_{L_{\log q_z}} = -\mathrm{ELBO} \\
& = L_{\log p_x} + L_{\log p_z} - L_{\log q_z} \\
& = -\mathbb{E}_q\left[\log p(x \mid z) \right] + \mathbb{E}_q\left[- \log p(z) + \log q(z \mid x) \right] \\
& = -\mathbb{E}_q\left[\log p(x \mid z) \right] + \mathrm{KL}\left(q\left(z\mid x\right) \| p\left(z\right) \right)
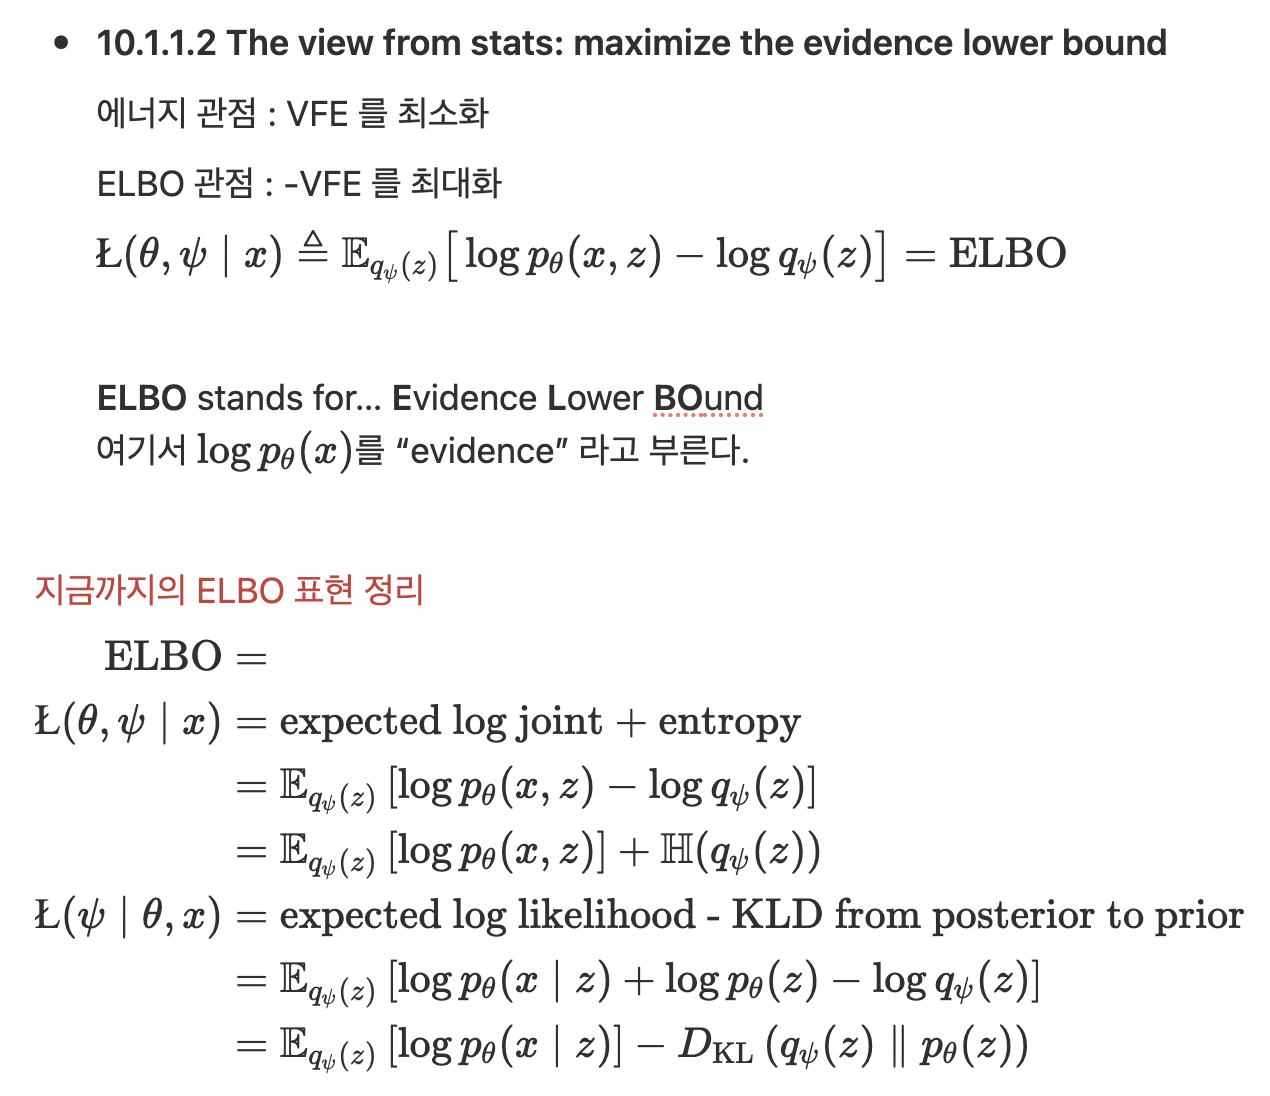
\end{aligned} L = L l o g p x − E q [ log p ( x ∣ z )] + L l o g p z − E q [ log p ( z )] − L l o g q z − E q [ log q ( z ∣ x )] = − ELBO = L l o g p x + L l o g p z − L l o g q z = − E q [ log p ( x ∣ z ) ] + E q [ − log p ( z ) + log q ( z ∣ x ) ] = − E q [ log p ( x ∣ z ) ] + KL ( q ( z ∣ x ) ∥ p ( z ) ) About ELBO L ( θ , ψ ∣ x ) = E q ψ ( z ) [ − log p θ ( x , z ) + log q ψ ( z ) ] \mathcal{L}(\theta, \psi \mid x) = \mathbb{E}_{q_\psi(z)} \big[ -\log p_\theta(x, z) + \log q_\psi(z) \big] L ( θ , ψ ∣ x ) = E q ψ ( z ) [ − log p θ ( x , z ) + log q ψ ( z ) ] How to sample in this VAE?
어느 정도 수렴이 된다면 우리가 디코더 d θ ( z ) d_{\boldsymbol \theta}(\boldsymbol z) d θ ( z ) p ( z ) p(\boldsymbol z) p ( z ) z ∼ p ( z ) \boldsymbol z \sim p(\boldsymbol z) z ∼ p ( z ) d θ ( z ) d_{\boldsymbol \theta}(\boldsymbol z) d θ ( z )
Advantage of VAE over AE?
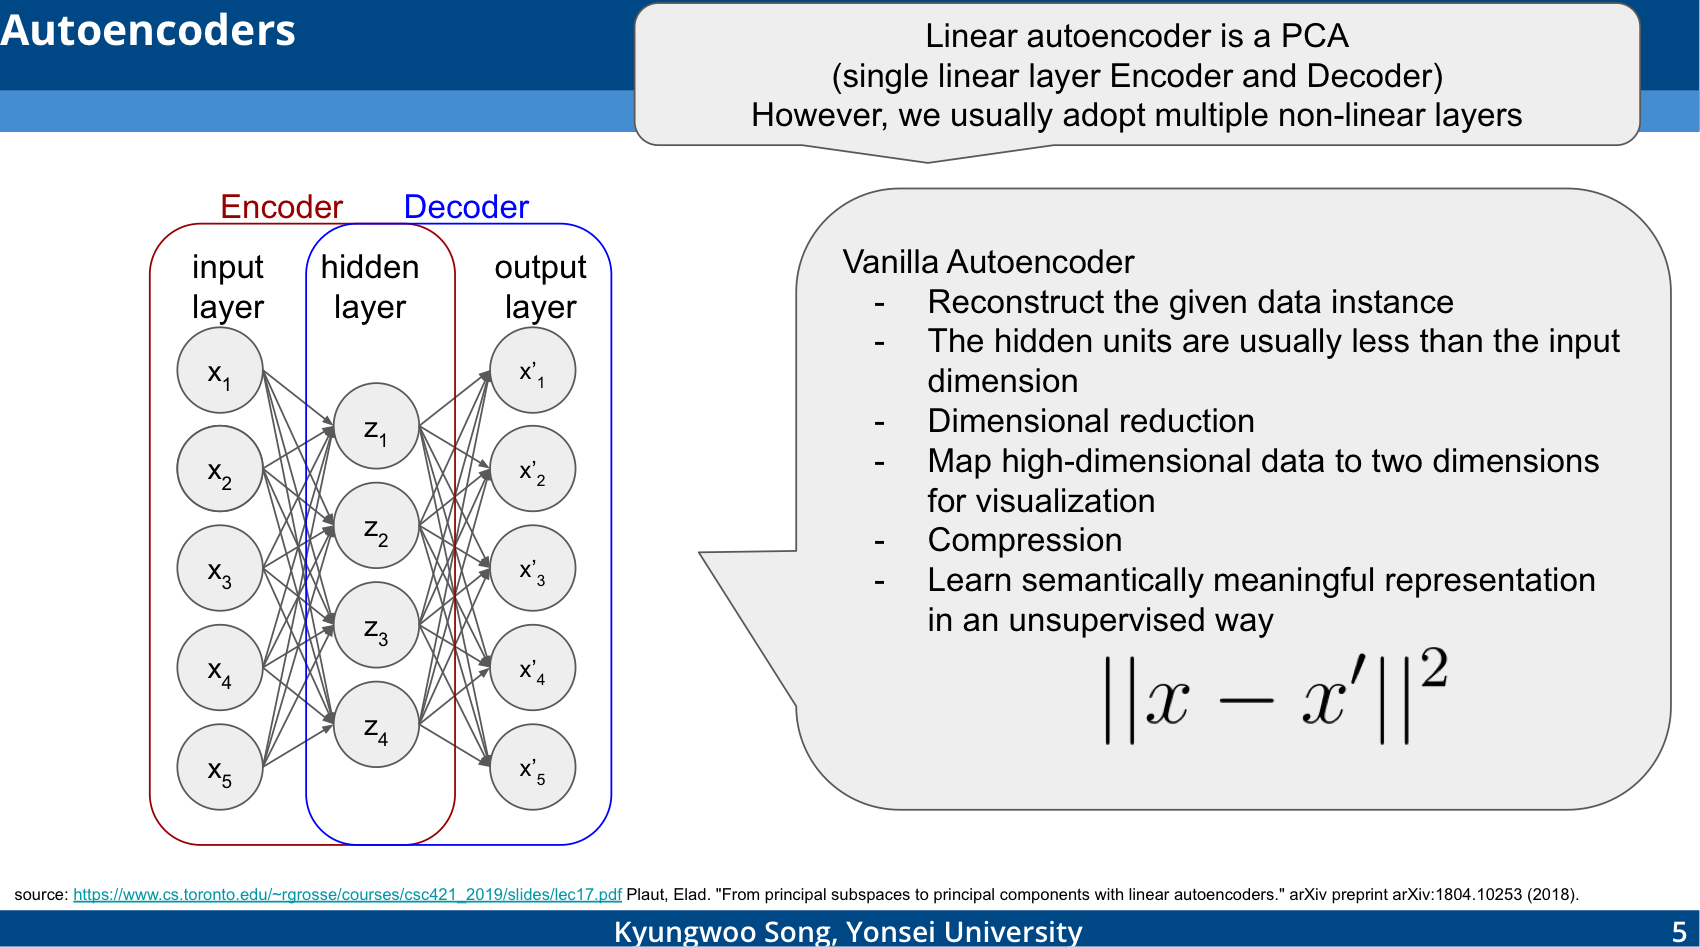
Autoencoder 는 사실은 생성모델이 아니다. 압축하는게 사실은 목표이며 더 잘 압축하기 위해서 Decoder 를 결합한게 Autoencoder 일 뿐이다. 한 마디로 Randomness 요소가 없다. 그러기에 Latent 에 대해서 Randomness 요소가 있는 VAE 가 생성 측면에서는 이점을 가진다.
About Autoencoder from 생성모델 강의 (송경우 교수님 강의안)
Final Loss Term would be :
L ( θ , ϕ ∣ D ) = − E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] + D K L ( q ϕ ( z ∣ x ) ∥ p θ ( z ) ) L(\boldsymbol\theta, \boldsymbol\phi \mid \mathcal D) = -\mathbb{E}_{q_\phi(\boldsymbol z \mid \boldsymbol x)}\left[\log p_{\boldsymbol \theta}(\boldsymbol x \mid \boldsymbol z) \right] + D_{\mathbb{KL}}\left(q_\phi(\boldsymbol z \mid \boldsymbol x) \| p_{\boldsymbol \theta}\left(\boldsymbol z\right) \right) L ( θ , ϕ ∣ D ) = − E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] + D KL ( q ϕ ( z ∣ x ) ∥ p θ ( z ) ) Alternative Expression for ELBO in VAE
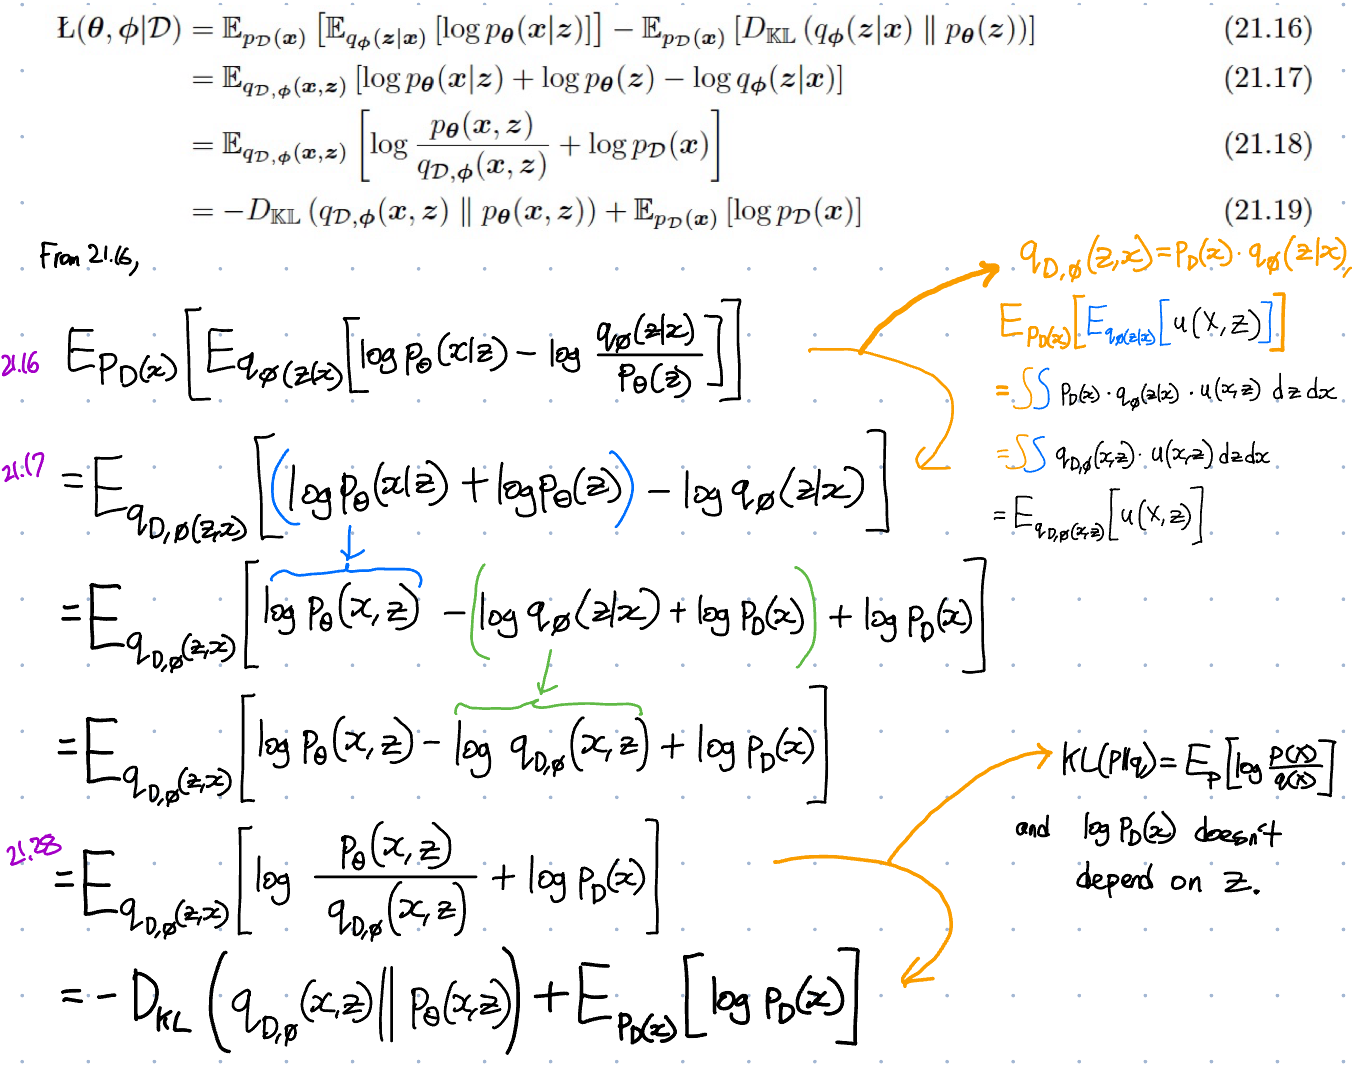
Joint Generative 부분 : p θ ( x , z ) = p θ ( z ) p θ ( x ∣ z ) p_{\boldsymbol{\theta}}(\boldsymbol{x}, \boldsymbol{z})=p_{\boldsymbol{\theta}}(\boldsymbol{z}) p_{\boldsymbol{\theta}}(\boldsymbol{x} \mid \boldsymbol{z}) p θ ( x , z ) = p θ ( z ) p θ ( x ∣ z ) p θ ( x ) = ∫ z p θ ( x , z ) d z p_{\boldsymbol{\theta}}(\boldsymbol{x})= \int_{\boldsymbol z} p_{\boldsymbol \theta}(\boldsymbol x, \boldsymbol z) d\boldsymbol z p θ ( x ) = ∫ z p θ ( x , z ) d z p θ ( z ∣ x ) = p θ ( x , z ) / p θ ( x ) p_{\boldsymbol{\theta}}(\boldsymbol{z} \mid \boldsymbol{x})=p_{\boldsymbol{\theta}}(\boldsymbol{x}, \boldsymbol{z}) / p_{\boldsymbol{\theta}}(\boldsymbol{x}) p θ ( z ∣ x ) = p θ ( x , z ) / p θ ( x ) Joint Inference 부분 :q D , ϕ ( z , x ) = p D ( x ) q ϕ ( z ∣ x ) q_{\mathcal{D}, \phi}(\boldsymbol{z}, \boldsymbol{x})=p_{\mathcal{D}}(\boldsymbol{x}) q_{\boldsymbol{\phi}}(\boldsymbol{z} \mid \boldsymbol{x}) q D , ϕ ( z , x ) = p D ( x ) q ϕ ( z ∣ x ) p D ( x ) = 1 N ∑ n = 1 N δ ( x n − x ) p_{\mathcal{D}}(\boldsymbol{x})=\frac{1}{N} \sum_{n=1}^N \delta\left(\boldsymbol{x}_n-\boldsymbol{x}\right) p D ( x ) = N 1 ∑ n = 1 N δ ( x n − x ) q D , ϕ ( z ) = ∫ x q D , ϕ ( x , z ) d x q_{\mathcal{D}, \boldsymbol{\phi}}(\boldsymbol{z})=\int_{\boldsymbol{x}} q_{\mathcal{D}, \boldsymbol{\phi}}(\boldsymbol{x}, \boldsymbol{z}) d \boldsymbol{x} q D , ϕ ( z ) = ∫ x q D , ϕ ( x , z ) d x q D , ϕ ( x ∣ z ) = q D , ϕ ( x , z ) / q D , ϕ ( z ) q_{\mathcal{D}, \boldsymbol{\phi}}(\boldsymbol{x} \mid \boldsymbol{z})=q_{\mathcal{D}, \boldsymbol{\phi}}(\boldsymbol{x}, \boldsymbol{z}) / q_{\mathcal{D}, \boldsymbol{\phi}}(\boldsymbol{z}) q D , ϕ ( x ∣ z ) = q D , ϕ ( x , z ) / q D , ϕ ( z ) 이것들을 이용해서 ELBO Term 을 다음과 같이 바꿔줄 수가 있습니다.
풀이 Original Loss (Negative ELBO) :
L = − E q [ log p ( x ∣ z ) ] + K L ( q ( z ∣ x ) ∥ p ( z ) ) , w/o params L ( θ , ϕ ∣ D ) = E p D ( x ) [ − E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] + D K L ( q ϕ ( z ∣ x ) ∥ p θ ( z ) ) ] \begin{aligned}
L
& = -\mathbb{E}_q\left[\log p(x \mid z) \right] + \mathrm{KL}\left(q\left(z\mid x\right) \| p\left(z\right) \right), \quad \text{w/o params} \\
L(\theta, \phi \mid \mathcal D) &= \mathbb{E}_{p_{\mathcal D}(\boldsymbol x)}\left[-\mathbb{E}_{q_\phi(\boldsymbol z \mid \boldsymbol x)}\left[\log p_{\boldsymbol \theta}(\boldsymbol x \mid \boldsymbol z) \right] + D_{\mathbb{KL}}\left(q_\phi(\boldsymbol z \mid \boldsymbol x) \| p_{\boldsymbol \theta}\left(\boldsymbol z\right) \right) \right]
\end{aligned} L L ( θ , ϕ ∣ D ) = − E q [ log p ( x ∣ z ) ] + KL ( q ( z ∣ x ) ∥ p ( z ) ) , w/o params = E p D ( x ) [ − E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] + D KL ( q ϕ ( z ∣ x ) ∥ p θ ( z ) ) ] Positive ELBO with parametrization :
ELBO ( θ , ϕ ∣ D ) = E p D ( x ) [ E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] − D K L ( q ϕ ( z ∣ x ) ( z ∣ x ) ∥ p θ ( z ) ) ] \text{ELBO}(\theta, \phi \mid \mathcal D) = \mathbb{E}_{p_{\mathcal D}(\boldsymbol x)}\left[\mathbb{E}_{q_\phi(\boldsymbol z \mid \boldsymbol x)}\left[\log p_{\boldsymbol \theta}(x \mid z) \right] - D_{\mathbb{KL}}\left(q_\phi(\boldsymbol z \mid \boldsymbol x)\left(z\mid x\right) \| p_{\boldsymbol \theta}\left(z\right) \right) \right] ELBO ( θ , ϕ ∣ D ) = E p D ( x ) [ E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] − D KL ( q ϕ ( z ∣ x ) ( z ∣ x ) ∥ p θ ( z ) ) ] 여기에 = c \stackrel{c}{=} = c p D ( x ) p_\mathcal{D}(x) p D ( x )
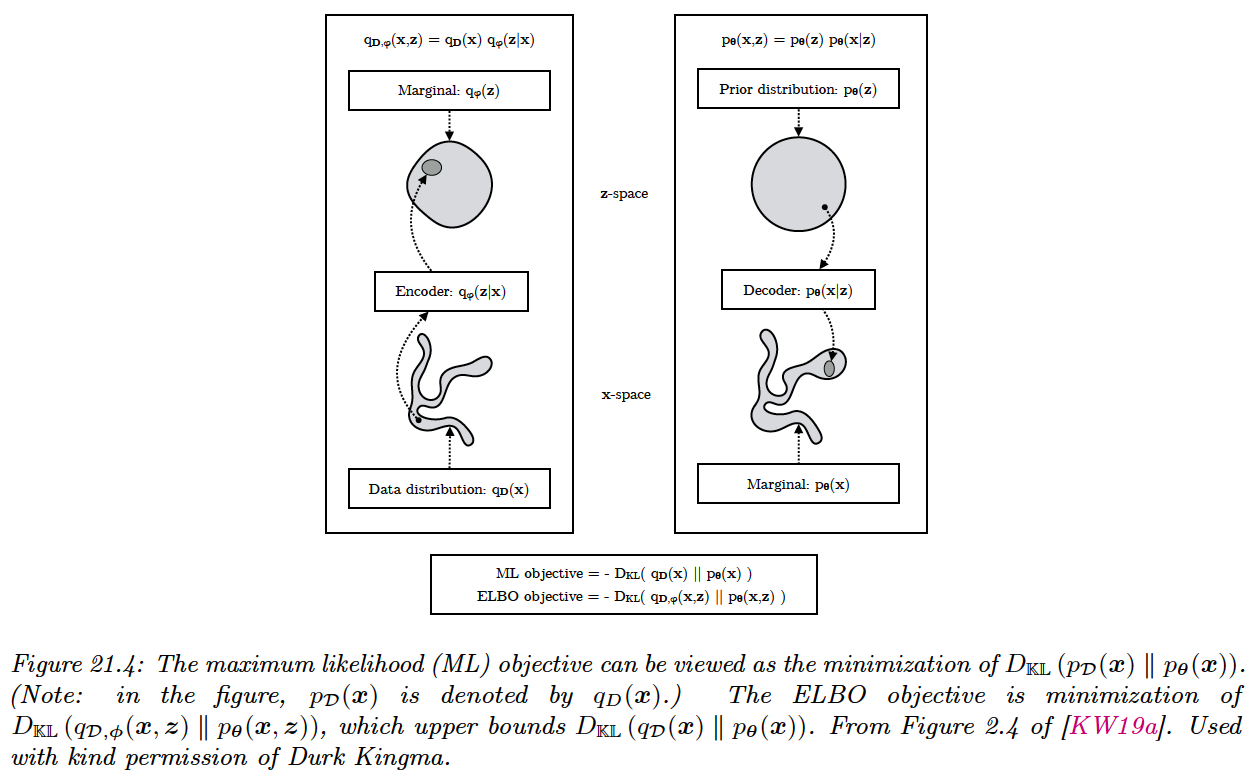
21.21 과 같이 해석을 할 수도 있고 아래 보이는 식과 같이 또 다르게 해석할 수도 있다 (Marginal as z instead of x).
Ł ( θ , ϕ ∣ D ) = c − D K L ( q D , ϕ ( z ) ∥ p θ ( z ) ) − E q D , ϕ ( z ) [ D K L ( q ϕ ( x ∣ z ) ∥ p θ ( x ∣ z ) ) ] \mathrm{Ł}(\boldsymbol{\theta}, \boldsymbol{\phi} \mid \mathcal{D}) \stackrel{c}{=}-D_{\mathbb{K} \mathbb{L}}\left(q_{\mathcal{D}, \boldsymbol{\phi}}(\boldsymbol{z}) \| p_{\boldsymbol{\theta}}(\boldsymbol{z})\right)-\mathbb{E}_{q_{\mathcal{D}, \boldsymbol{\phi}}(\boldsymbol{z})}\left[D_{\mathbb{K} \mathbb{L}}\left(q_{\boldsymbol{\phi}}(\boldsymbol{x} \mid \boldsymbol{z}) \| p_{\boldsymbol{\theta}}(\boldsymbol{x} \mid \boldsymbol{z})\right)\right] Ł ( θ , ϕ ∣ D ) = c − D KL ( q D , ϕ ( z ) ∥ p θ ( z ) ) − E q D , ϕ ( z ) [ D KL ( q ϕ ( x ∣ z ) ∥ p θ ( x ∣ z ) ) ] 둘 다 달라진건 사실 없고 ELBO 에 대한 관점만 바뀌었을 뿐! 그럼 그래서 이렇게 보는 이점이 뭘까?
1번째 Term 에서 보이는 바와 같이 Inference & Generative Prior 의 차이를 최소화 시켜준다는 것을 알 수가 있음. 2번째 Term 에서 보이는 바와 같이 z z z x x x
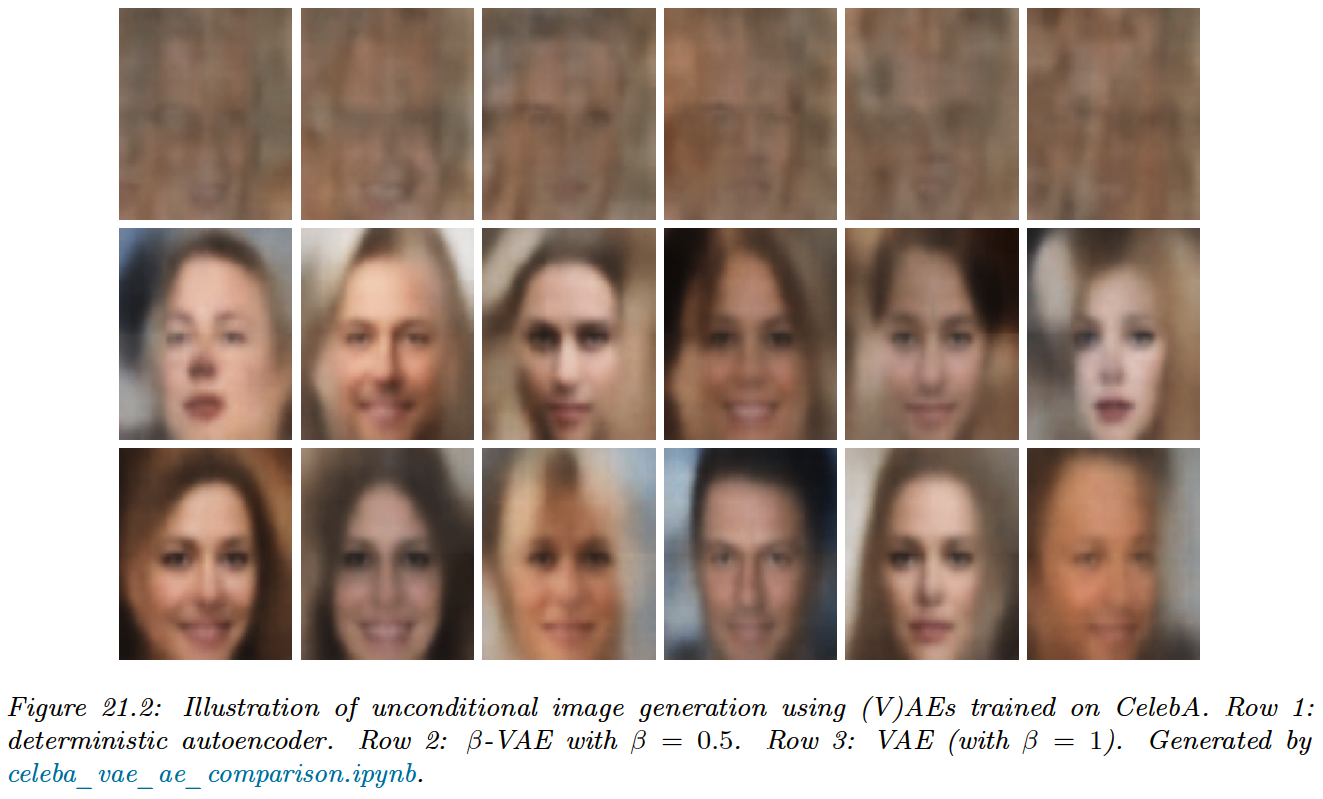
VAE Generalizations L ( θ , ϕ ∣ D ) = − E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] + D K L ( q ϕ ( z ∣ x ) ∥ p θ ( z ) ) L(\boldsymbol\theta, \boldsymbol\phi \mid \mathcal D) = -\mathbb{E}_{q_\phi(\boldsymbol z \mid \boldsymbol x)}\left[\log p_{\boldsymbol \theta}(\boldsymbol x \mid \boldsymbol z) \right] + D_{\mathbb{KL}}\left(q_\phi(\boldsymbol z \mid \boldsymbol x) \| p_{\boldsymbol \theta}\left(\boldsymbol z\right) \right) L ( θ , ϕ ∣ D ) = − E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] + D KL ( q ϕ ( z ∣ x ) ∥ p θ ( z ) ) 근데 결과를 조금 살피면 Blurry 하다는 모습을 보인다는 것을 알 수가 있다 (맨 아랫 줄에 해당함). 이에 대한 이유로는 Gaussian Decoder 를 사용한다는 것이 문제이다.
Decoder 에 대해서 얘기했을 때 우리는 Decoder 가 그저 Neural Network 이라고 말만 했었지만, 사실은 그것보다 조금 더 구체적으로 들어가야된다.
이미지 x x x 28 × 28 28\times 28 28 × 28 z z z d d d x ^ \hat{x} x ^
x ^ i , j ∼ N ( [ μ θ ( z ) ] i , j , [ σ θ ( z ) ] i , j ) \hat{x}_{i,j} \sim \mathrm{N}\left(\left[\mu_\theta\left(\boldsymbol{z} \right)\right]_{i,j}, \left[\sigma_{\theta}(\boldsymbol z) \right]_{i,j}\right) x ^ i , j ∼ N ( [ μ θ ( z ) ] i , j , [ σ θ ( z ) ] i , j ) 실제 이미지 x x x x ^ \hat{x} x ^
p θ ( x ∣ z ) = ∏ i N ( x i ; μ i ( z ) , σ 2 ) ⟹ − log p θ ( x ∣ z ) ∝ ∑ i ( x i − μ i ( z ) ) 2 p_\theta(x \mid z)=\prod_i \mathcal{N}\left(x_i ; \mu_i(z), \sigma^2\right) \quad \Longrightarrow \quad-\log p_\theta(x \mid z) \propto \sum_i\left(x_i-\mu_i(z)\right)^2 p θ ( x ∣ z ) = i ∏ N ( x i ; μ i ( z ) , σ 2 ) ⟹ − log p θ ( x ∣ z ) ∝ i ∑ ( x i − μ i ( z ) ) 2 평균을 내어버리기에 Blurry 한 이미지들이 나오게 된다고 한다.
그러면 이걸 어떻게 고칠 수가 있을까? → \rightarrow → z K = f K ∘ ⋯ ∘ f 1 ( z 0 ) , z 0 ∼ N ( 0 , I ) z_K=f_K \circ \cdots \circ f_1\left(z_0\right), \quad z_0 \sim \mathcal{N}(0, I) z K = f K ∘ ⋯ ∘ f 1 ( z 0 ) , z 0 ∼ N ( 0 , I )
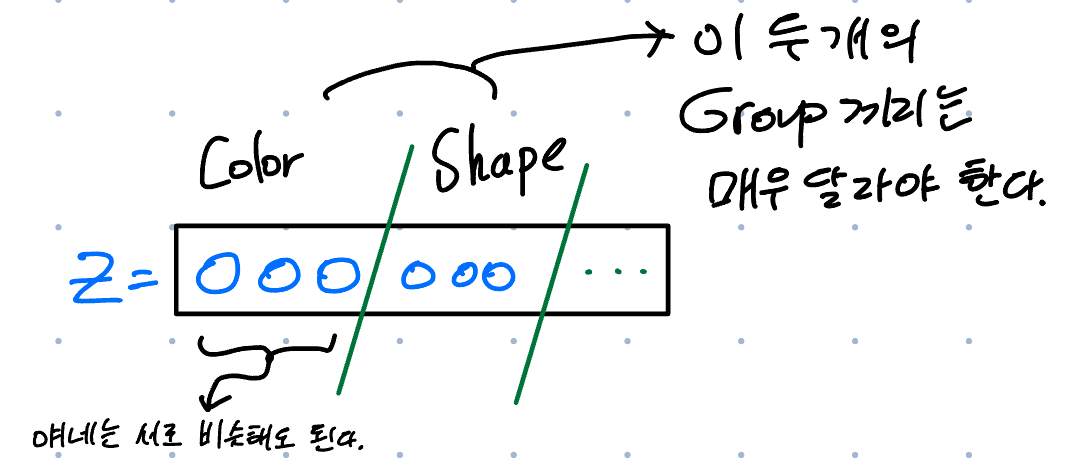
더 간단한 방법으로는 β \beta β
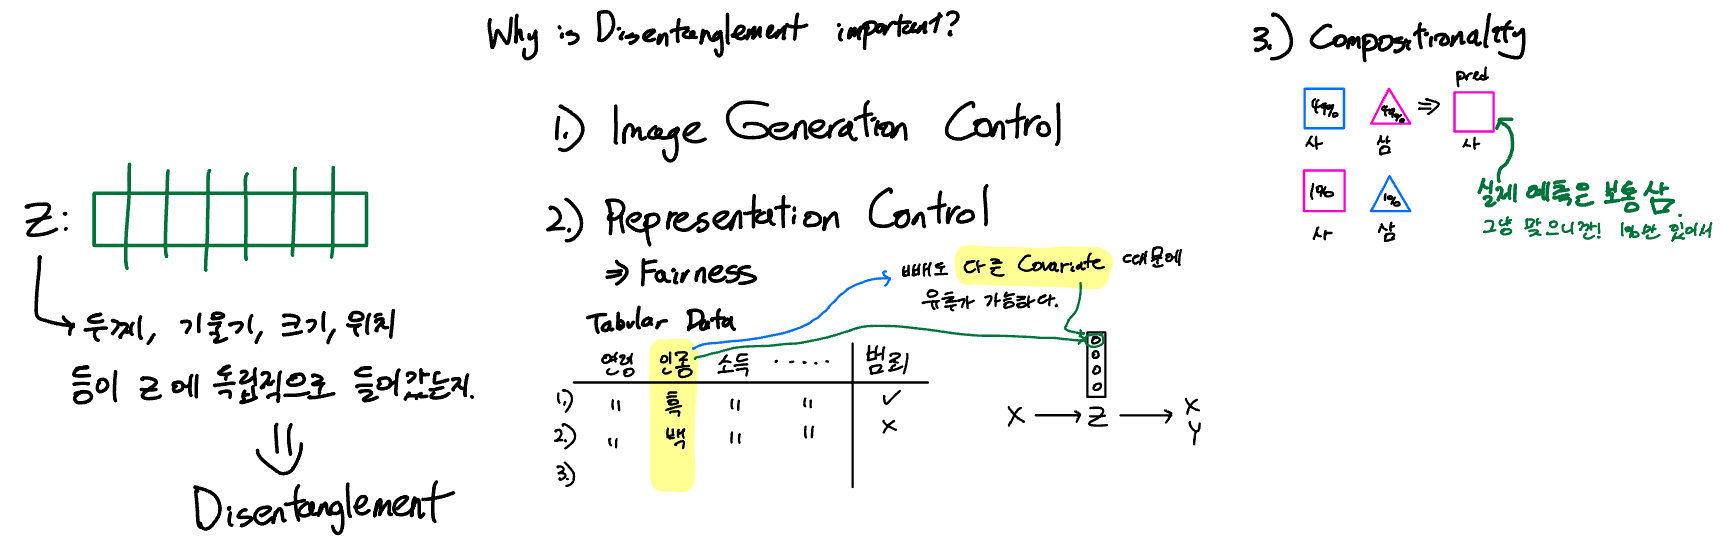
원래 비전에서는 이것을 Total-Correlation Loss 으로 사용하기는 하지만,
T C ( z ) = ∑ k H ( z k ) − H ( z ) = D K L ( p ( z ) ∥ ∏ k p k ( z k ) ) \mathrm{TC}(\boldsymbol{z})=\sum_k \mathbb{H}\left(z_k\right)-\mathbb{H}(\boldsymbol{z})=D_{\mathbb{K} \mathbb{L}}\left(p(\boldsymbol{z}) \| \prod_k p_k\left(z_k\right)\right) TC ( z ) = k ∑ H ( z k ) − H ( z ) = D KL ( p ( z ) ∥ k ∏ p k ( z k ) ) 다른 논문에서는 다음의 Modified 된 VAE 의 로스함수에서 β > 1 \beta > 1 β > 1
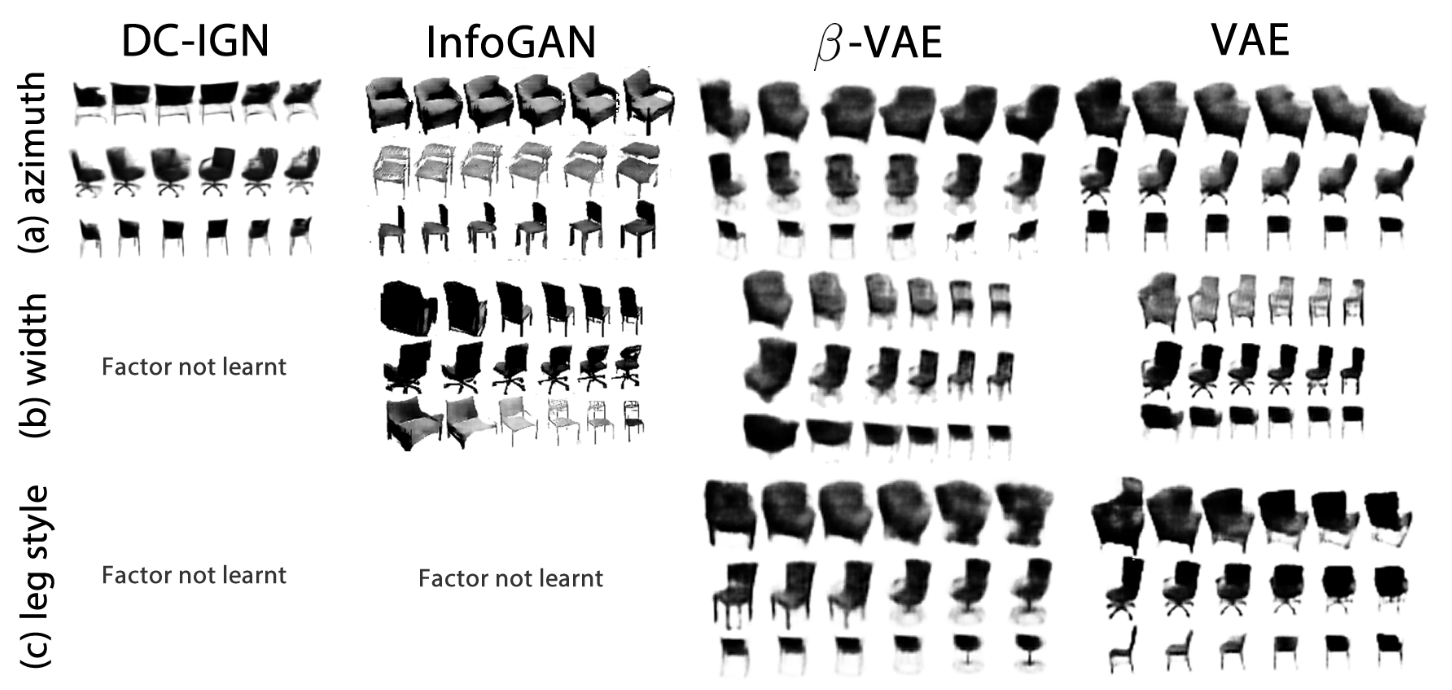
L β ( θ , ϕ ∣ x ) = − E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] ⏟ L E + β D K L ( q ϕ ( z ∣ x ) ∥ p θ ( z ) ) ⏟ L R \mathcal{L}_\beta(\boldsymbol{\theta}, \boldsymbol{\phi} \mid \boldsymbol{x})=\underbrace{-\mathbb{E}_{q_{\boldsymbol{\phi}}(\boldsymbol{z} \mid \boldsymbol{x})}\left[\log p_{\boldsymbol{\theta}}(\boldsymbol{x} \mid \boldsymbol{z})\right]}_{\mathcal{L}_E}+\beta \underbrace{D_{\mathbb{K} \mathbb{L}}\left(q_{\boldsymbol{\phi}}(\boldsymbol{z} \mid \boldsymbol{x}) \| p_{\boldsymbol{\theta}}(\boldsymbol{z})\right)}_{\mathcal{L}_R} L β ( θ , ϕ ∣ x ) = L E − E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] + β L R D KL ( q ϕ ( z ∣ x ) ∥ p θ ( z ) ) β = 0 : \beta = 0 : β = 0 : β < 1 : \beta < 1 : β < 1 : z z z N ( 0 , I ) N(0, I) N ( 0 , I ) 일종의 z z z z z z x x x β > 1 : \beta > 1 : β > 1 : N ( 0 , I ) N(0, I) N ( 0 , I ) 원래 β \beta β z z z
Azimuth : 방위각 / 각도
InfoVAE 그럼 VAE 에서 생길 수 있는 또 다른 문제점은 뭐가 있을까?
Encoder 의 목표에서는 z ∣ x z\mid x z ∣ x N ( 0 , I ) N(0, I) N ( 0 , I ) x x x z ∣ x z\mid x z ∣ x N ( 0 , I ) N(0, I) N ( 0 , I )
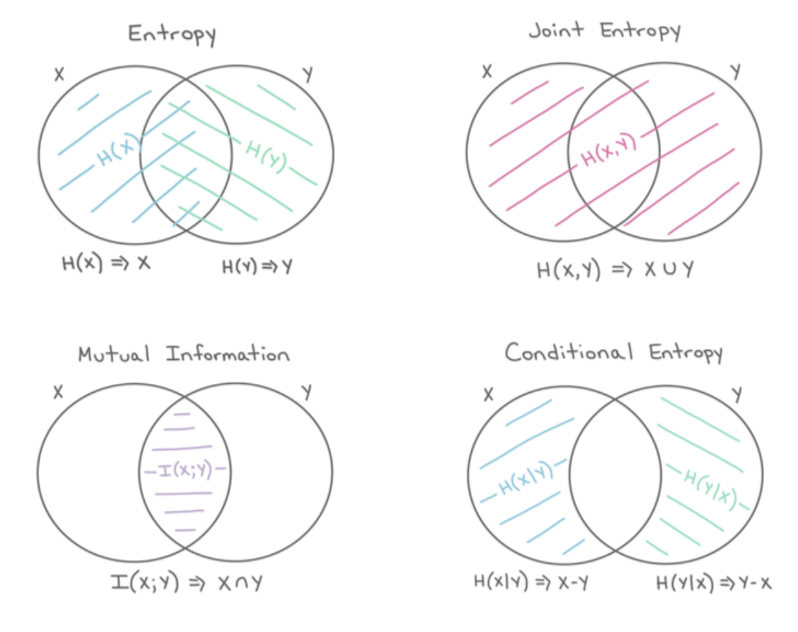
그러면 이때 Mutual Information 을 고려해보자. I ( X ; Z ) I(X;Z) I ( X ; Z ) X X X Z Z Z
이 값을 올리게 된다면 X X X Z Z Z
α \alpha α M I MI M I x x x z z z x x x λ \lambda λ β \beta β α : = 1 − λ \alpha := 1- \lambda α := 1 − λ λ \lambda λ β \beta β 새로운 변수 c c c
p θ ( x , z ∣ c ) = p ( z ) p θ ( x ∣ z , c ) p_\theta(x, z \mid c)=p(z) p_\theta(x \mid z, c) p θ ( x , z ∣ c ) = p ( z ) p θ ( x ∣ z , c ) q ϕ ( z ∣ x , c ) q_\phi(z \mid x, c) q ϕ ( z ∣ x , c )
Avoiding Posterior Collapse Posterior Collapse 이란 우리가 Encoder 를 통해서 압축한 z z z q ϕ ( z ∣ x ) ≈ p ( z ) q_\phi (z\mid x) \approx p(z) q ϕ ( z ∣ x ) ≈ p ( z ) x x x
KL-Annealing - β \beta β β \beta β 0.0 0.0 0.0 1.0 1.0 1.0 Free bits - 원래는 L R = ∑ i D K L ( q ϕ ( z i ∣ x ) ∥ p θ ( z i ) ) \mathcal{L}_R=\sum_i D_{\mathbb{K} \mathbb{L}}\left(q_{\boldsymbol{\phi}}\left(z_i \mid \boldsymbol{x}\right) \| p_{\boldsymbol{\theta}}\left(z_i\right)\right) L R = ∑ i D KL ( q ϕ ( z i ∣ x ) ∥ p θ ( z i ) ) L R ′ = ∑ i max ( λ , D K L ( q ϕ ( z i ∣ x ) ∥ p θ ( z i ) ) ) \mathcal{L}_R^{\prime}=\sum_i \max \left(\lambda, D_{\mathbb{K} \mathbb{L}}\left(q_{\boldsymbol{\phi}}\left(z_i \mid \boldsymbol{x}\right) \| p_{\boldsymbol{\theta}}\left(z_i\right)\right)\right) L R ′ = ∑ i max ( λ , D KL ( q ϕ ( z i ∣ x ) ∥ p θ ( z i ) ) )
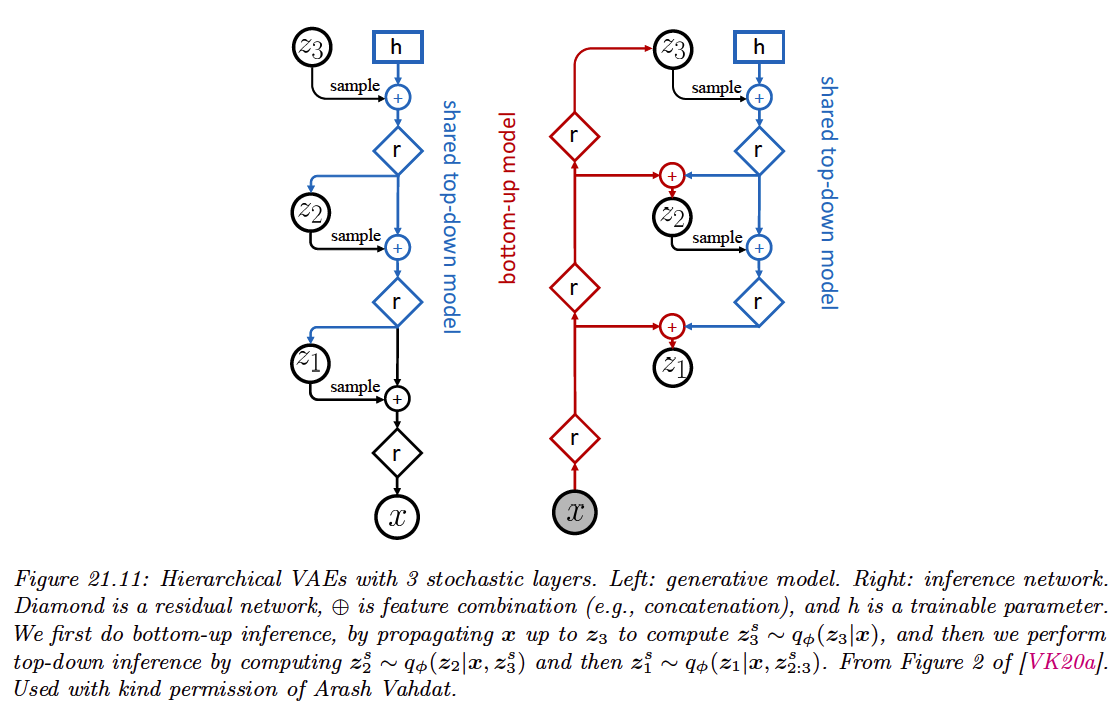
VAEs with Hierarchical Structure 이 문제를 정의를 좀 해보자면, 다음과 같다.
그러면 모델의 Expressive Power 가 늘어나게 된다.
Markovian 가정을 깨버릴 수가 있다. Layer 들로 나눠줄 수가 있기에.
p θ ( x , z ) = p θ ( z L ) [ ∏ l = L − 1 1 p θ ( z l ∣ z l + 1 : L ) ] p θ ( x ∣ z 1 : L ) p_{\boldsymbol{\theta}}(\boldsymbol{x}, \boldsymbol{z})=p_{\boldsymbol{\theta}}\left(\boldsymbol{z}_L\right)\left[\prod_{l=L-1}^1 p_{\boldsymbol{\theta}}\left(\boldsymbol{z}_l \mid \boldsymbol{z}_{l+1: L}\right)\right] p_{\boldsymbol{\theta}}\left(\boldsymbol{x} \mid \boldsymbol{z}_{1: L}\right) p θ ( x , z ) = p θ ( z L ) [ l = L − 1 ∏ 1 p θ ( z l ∣ z l + 1 : L ) ] p θ ( x ∣ z 1 : L ) l = 2 → L l=2 \rightarrow L l = 2 → L
q ϕ ( z ∣ x ) = q ϕ ( z L ∣ x ) ∏ l = L − 1 1 q ϕ ( z l ∣ x , z l + 1 : L ) q_{\boldsymbol{\phi}}(\boldsymbol{z} \mid \boldsymbol{x})=q_{\boldsymbol{\phi}}\left(\boldsymbol{z}_L \mid \boldsymbol{x}\right) \prod_{l=L-1}^1 q_{\boldsymbol{\phi}}\left(\boldsymbol{z}_l \mid \boldsymbol{x}, \boldsymbol{z}_{l+1: L}\right) q ϕ ( z ∣ x ) = q ϕ ( z L ∣ x ) l = L − 1 ∏ 1 q ϕ ( z l ∣ x , z l + 1 : L ) E ( θ , ϕ ∣ x ) = E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] − D K L ( q ϕ ( z L ∣ x ) ∥ p θ ( z L ) ) − ∑ l = L − 1 1 E q ϕ ( z > l ∣ x ) [ D K L ( q ϕ ( z l ∣ x , z > l ) ∥ p θ ( z l ∣ z > l ) ) ] \begin{aligned}\mathrm{E}(\boldsymbol{\theta}, \boldsymbol{\phi} \mid \boldsymbol{x}) & =\mathbb{E}_{q_{\boldsymbol{\phi}}(\boldsymbol{z} \mid \boldsymbol{x})}\left[\log p_{\boldsymbol{\theta}}(\boldsymbol{x} \mid \boldsymbol{z})\right]-D_{\mathbb{K L}}\left(q_{\boldsymbol{\phi}}\left(\boldsymbol{z}_L \mid \boldsymbol{x}\right) \| p_{\boldsymbol{\theta}}\left(\boldsymbol{z}_L\right)\right) \\& -\sum_{l=L-1}^1 \mathbb{E}_{q_{\boldsymbol{\phi}}\left(\boldsymbol{z}_{>l} \mid \boldsymbol{x}\right)}\left[D_{\mathbb{K L}}\left(q_{\boldsymbol{\phi}}\left(\boldsymbol{z}_l \mid \boldsymbol{x}, \boldsymbol{z}_{>l}\right) \| p_{\boldsymbol{\theta}}\left(\boldsymbol{z}_l \mid \boldsymbol{z}_{>l}\right)\right)\right]\end{aligned} E ( θ , ϕ ∣ x ) = E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] − D KL ( q ϕ ( z L ∣ x ) ∥ p θ ( z L ) ) − l = L − 1 ∑ 1 E q ϕ ( z > l ∣ x ) [ D KL ( q ϕ ( z l ∣ x , z > l ) ∥ p θ ( z l ∣ z > l ) ) ]
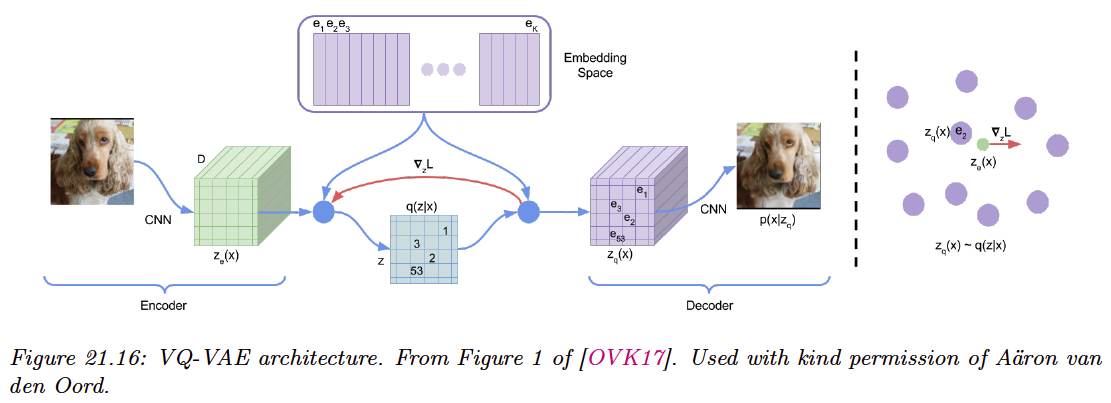
VQ-VAEs (Vector Quantized VAEs) Posterior Collapse 문제를 해결하기 위한 또 다른 방법. x x x z z z
VAE 와는 다르게 Encoder 가 Continuous 가 아닌 Discrete Latent 변수
Encoder 의 뒷 부분은 z e ( x ) z_e(x) z e ( x ) ( i , j ) (i,j) ( i , j )
q ( z i j = k ∣ x ) = { 1 if k = argmin k ′ ∥ z e ( x ) i , j , : − e k ′ ∥ 2 0 otherwise q\left(\boldsymbol{z}_{i j}=k \mid \boldsymbol{x}\right)= \begin{cases}1 & \text { if } k=\operatorname{argmin}_{k^{\prime}}\left\|\boldsymbol{z}_e(\boldsymbol{x})_{i, j,:}-e_{k^{\prime}}\right\|_2 \\ 0 & \text { otherwise }\end{cases} q ( z ij = k ∣ x ) = { 1 0 if k = argmin k ′ ∥ z e ( x ) i , j , : − e k ′ ∥ 2 otherwise 이것에 그러면 ( i , j ) (i,j) ( i , j ) k k k e k e_k e k
( z q ) i j = e k where z i j = k \left(\boldsymbol{z}_q\right)_{i j}=\boldsymbol{e}_k \text { where } \boldsymbol{z}_{i j}=k ( z q ) ij = e k where z ij = k 그럼 다음에 이 값을 모아서 z q ( x ) z_q(x) z q ( x )
L = − log p ( x ∣ z q ( x ) ) + ∥ sg ( z e ( x ) ) − e ∥ 2 2 + β ∥ z e ( x ) − sg ( e ) ∥ 2 2 \mathcal{L}=-\log p\left(\boldsymbol{x} \mid \boldsymbol{z}_q(\boldsymbol{x})\right)+\left\|\operatorname{sg}\left(\boldsymbol{z}_e(\boldsymbol{x})\right)-\boldsymbol{e}\right\|_2^2+\beta\left\|\boldsymbol{z}_e(\boldsymbol{x})-\operatorname{sg}(\boldsymbol{e})\right\|_2^2 L = − log p ( x ∣ z q ( x ) ) + ∥ sg ( z e ( x ) ) − e ∥ 2 2 + β ∥ z e ( x ) − sg ( e ) ∥ 2 2 1번째 Term 은 그저 Reconstruction loss, Decoder 에 줄 입력값인 z q ( x ) \boldsymbol z_q(\boldsymbol x) z q ( x ) 2번째 Term 은 Encoder output z e \boldsymbol z_e z e e \boldsymbol e e 3번째 Term 은 2번째 Term 의 반대. KL Term 대신에 Codebook 개념으로 바라보기에 이렇게 다르게 바라봐야 된다.
Why the stop gradient to divide the loss into two?
둘다 업데이트를 동시에 하게 된다면 Encoder 와 Codebook 둘다 똑같은 방향으로 업데이트 하게 되며 둘에 대한 거리는 계속해서 유지될 것이다 (Moving Target).
Encoder 의 Output 이 Codebook 과 정확하게 일치하게끔 만들기 싫기에 β \beta β
Conclusion What is VAE? Autoencoder 의 Latent 를 Prior 분포으로 모델링 시키면서 확률적 요소를 더해준 것이다. Variational Inference 를 활용한다. VAE 의 문제점으로는? Disentanglement: z z z Posterior Collapse : 압축된 z z z x x x z z z