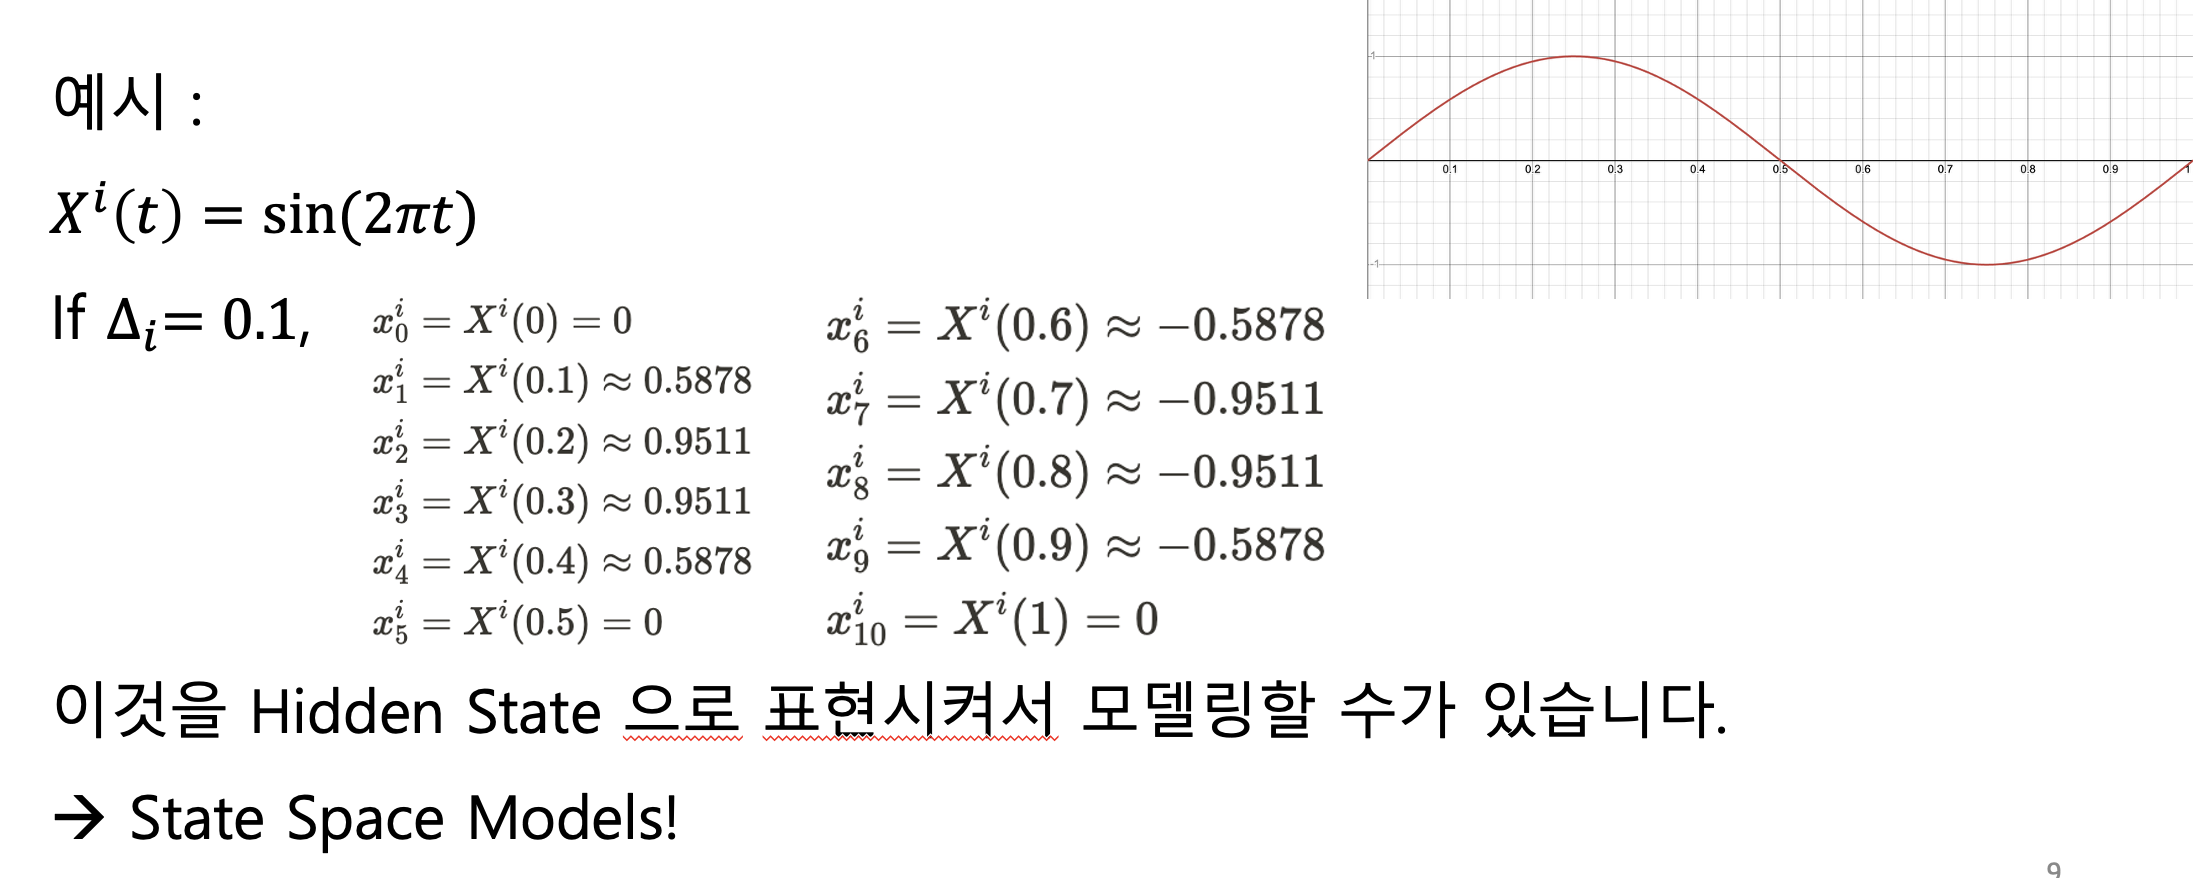
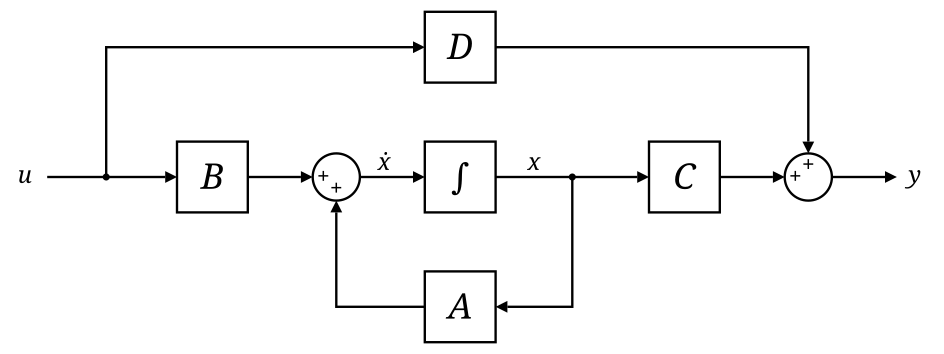
State Space Model (SSM) 한 마디 요약 : 전체 시스템을 관측하는 것이 불가능하기에 시간에 따라서 Markov Process 를 가지며 변하는 Hidden State 을 모델링 해주며 각각의 Hidden State 에 해당되는 Output 까지 고려해줍니다.
29.1 Introduction z t ∈ R N z : \boldsymbol{z}_t \in \mathbb{R}^{N_z} : z t ∈ R N z : u t ∈ R N u : \boldsymbol{u}_t \in \mathbb{R}^{N_u} : u t ∈ R N u : y t ∈ R N y : \boldsymbol{y}_t \in \mathbb{R}^{N_y} : y t ∈ R N y : f : \boldsymbol f : f : q t : \boldsymbol q_t : q t : h : \boldsymbol h : h : r t : \boldsymbol r_t : r t : SSM : Probabilistic Model for Sequences with a Latent Markov State.
z t = f ( z t − 1 , u t , q t ) y t = h ( z t , u t , y 1 : t − 1 , r t ) \begin{aligned}
\boldsymbol{z}_t & =\boldsymbol{f}\left(\boldsymbol{z}_{t-1}, \boldsymbol{u}_t, \boldsymbol{q}_t\right) \\
\boldsymbol{y}_t & =\boldsymbol{h}\left(\boldsymbol{z}_t, \boldsymbol{u}_t, \boldsymbol{y}_{1: t-1}, \boldsymbol{r}_t\right)
\end{aligned} z t y t = f ( z t − 1 , u t , q t ) = h ( z t , u t , y 1 : t − 1 , r t ) 위를 만족한다면 SSM 이라고 부를 수가 있습니다.
그러면 우리가 관심있는 두 변수는 사실 z t , y t \boldsymbol z_t, \boldsymbol y_t z t , y t
p ( z t ∣ z t − 1 , u t ) = p ( z t ∣ f ( z t − 1 , u t ) ) : p\left(\boldsymbol{z}_t \mid \boldsymbol{z}_{t-1}, \boldsymbol{u}_t\right) =p\left(\boldsymbol{z}_t \mid \boldsymbol{f}\left(\boldsymbol{z}_{t-1}, \boldsymbol{u}_t\right)\right) : p ( z t ∣ z t − 1 , u t ) = p ( z t ∣ f ( z t − 1 , u t ) ) : p ( y t ∣ z t , u t , y 1 : t − 1 ) = p ( y t ∣ h ( z t , u t , y 1 : t − 1 ) ) : p\left(\boldsymbol{y}_t \mid \boldsymbol{z}_t, \boldsymbol{u}_t, \boldsymbol{y}_{1: t-1}\right) =p\left(\boldsymbol{y}_t \mid \boldsymbol{h}\left(\boldsymbol{z}_t, \boldsymbol{u}_t, \boldsymbol{y}_{1: t-1}\right)\right) : p ( y t ∣ z t , u t , y 1 : t − 1 ) = p ( y t ∣ h ( z t , u t , y 1 : t − 1 ) ) : 가장 General 한 케이스로 Joint Probability 를 그려준다면 다음과 같습니다.
p ( y 1 : T , z 1 : T ∣ u 1 : T ) = [ p ( z 1 ∣ u 1 ) ∏ t = 2 T p ( z t ∣ z t − 1 , u t ) ] [ ∏ t = 1 T p ( y t ∣ z t , u t , y 1 : t − 1 ) ] p\left(\boldsymbol{y}_{1: T}, \boldsymbol{z}_{1: T} \mid \boldsymbol{u}_{1: T}\right)=\left[p\left(\boldsymbol{z}_1 \mid \boldsymbol{u}_1\right) \prod_{t=2}^T p\left(\boldsymbol{z}_t \mid \boldsymbol{z}_{t-1}, \boldsymbol{u}_t\right)\right]\left[\prod_{t=1}^T p\left(\boldsymbol{y}_t \mid \boldsymbol{z}_t, \boldsymbol{u}_t, \boldsymbol{y}_{1: t-1}\right)\right] p ( y 1 : T , z 1 : T ∣ u 1 : T ) = [ p ( z 1 ∣ u 1 ) t = 2 ∏ T p ( z t ∣ z t − 1 , u t ) ] [ t = 1 ∏ T p ( y t ∣ z t , u t , y 1 : t − 1 ) ] 이것을 활용시켜서 저희가 더 흔히 알고 있는 모델들로 적용시키는 것이 가능합니다.
예시로 y t y_t y t y t − 1 , z t y_{t-1}, z_t y t − 1 , z t
p ( y 1 : T , z 1 : T ∣ u 1 : T ) = [ p ( z 1 ∣ u 1 ) ∏ t = 2 T p ( z t ∣ z t − 1 , u t ) ] [ ∏ t = 1 T p ( y t ∣ y t − 1 , z t , u t ) ] p\left(\boldsymbol{y}_{1: T}, \boldsymbol{z}_{1: T} \mid \boldsymbol{u}_{1: T}\right)=\left[p\left(\boldsymbol{z}_1 \mid \boldsymbol{u}_1\right) \prod_{t=2}^T p\left(\boldsymbol{z}_t \mid \boldsymbol{z}_{t-1}, \boldsymbol{u}_t\right)\right]\left[\prod_{t=1}^T p\left(\boldsymbol{y}_t \mid \boldsymbol{y}_{t-1}, \boldsymbol{z}_t, \boldsymbol{u}_t\right)\right] p ( y 1 : T , z 1 : T ∣ u 1 : T ) = [ p ( z 1 ∣ u 1 ) t = 2 ∏ T p ( z t ∣ z t − 1 , u t ) ] [ t = 1 ∏ T p ( y t ∣ y t − 1 , z t , u t ) ] 반면에 Input u t u_t u t
p ( y 1 : T , z 1 : T ) = [ p ( z 1 ) ∏ t = 2 T p ( z t ∣ z t − 1 ) ] [ ∏ t = 1 T p ( y t ∣ z t ) ] p\left(\boldsymbol{y}_{1: T}, \boldsymbol{z}_{1: T}\right)=\left[p\left(\boldsymbol{z}_1\right) \prod_{t=2}^T p\left(\boldsymbol{z}_t \mid \boldsymbol{z}_{t-1}\right)\right]\left[\prod_{t=1}^T p\left(\boldsymbol{y}_t \mid \boldsymbol{z}_t\right)\right] p ( y 1 : T , z 1 : T ) = [ p ( z 1 ) t = 2 ∏ T p ( z t ∣ z t − 1 ) ] [ t = 1 ∏ T p ( y t ∣ z t ) ]
29.2 Hidden Markov Models (HMMs) HMM 도 SSM 으로 바라볼 수 있으며, 이것은 Hidden State 들이 Discrete 한 경우를 의미합니다.
z t ∈ { 1 , ⋯ , K } : z_t \in \{1,\cdots, K\} : z t ∈ { 1 , ⋯ , K } : p ( z 1 = j ) = π j : p(z_1 = j) =\pi_j : p ( z 1 = j ) = π j : p ( z t = j ∣ z t − 1 = i ) = A i j : p\left(z_t=j \mid z_{t-1}=i\right)=A_{i j} : p ( z t = j ∣ z t − 1 = i ) = A ij : p ( y t = k ∣ z t = j ) = y j k : p\left(y_t=k \mid z_t=j\right)=y_{j k} : p ( y t = k ∣ z t = j ) = y jk : 예시로 D D D p ( y t ∣ z t = j ) = ∏ d = 1 D Cat ( y t d ∣ y d , j , : ) p\left(\boldsymbol{y}_t \mid z_t=j\right)=\prod_{d=1}^D \operatorname{Cat}\left(y_{t d} \mid \boldsymbol{y}_{d, j,:}\right) p ( y t ∣ z t = j ) = ∏ d = 1 D Cat ( y t d ∣ y d , j , : )
GMM-HMM 반면에 Observation 은 사실 Continuous 가 될 수도 있기에 Continuous 이면 정규분포로 세팅하는 경우도 있습니다.
p ( y t ∣ z t = j ) = ∑ k = 1 M w j k N ( y t ∣ μ j k , Σ j k ) p\left(\boldsymbol{y}_t \mid z_t=j\right)=\sum_{k=1}^M w_{j k} \mathcal{N}\left(\boldsymbol{y}_t \mid \boldsymbol{\mu}_{j k}, \boldsymbol{\Sigma}_{j k}\right) p ( y t ∣ z t = j ) = k = 1 ∑ M w jk N ( y t ∣ μ jk , Σ jk ) The Parameters of Gaussian are time-invariant, and are trained.
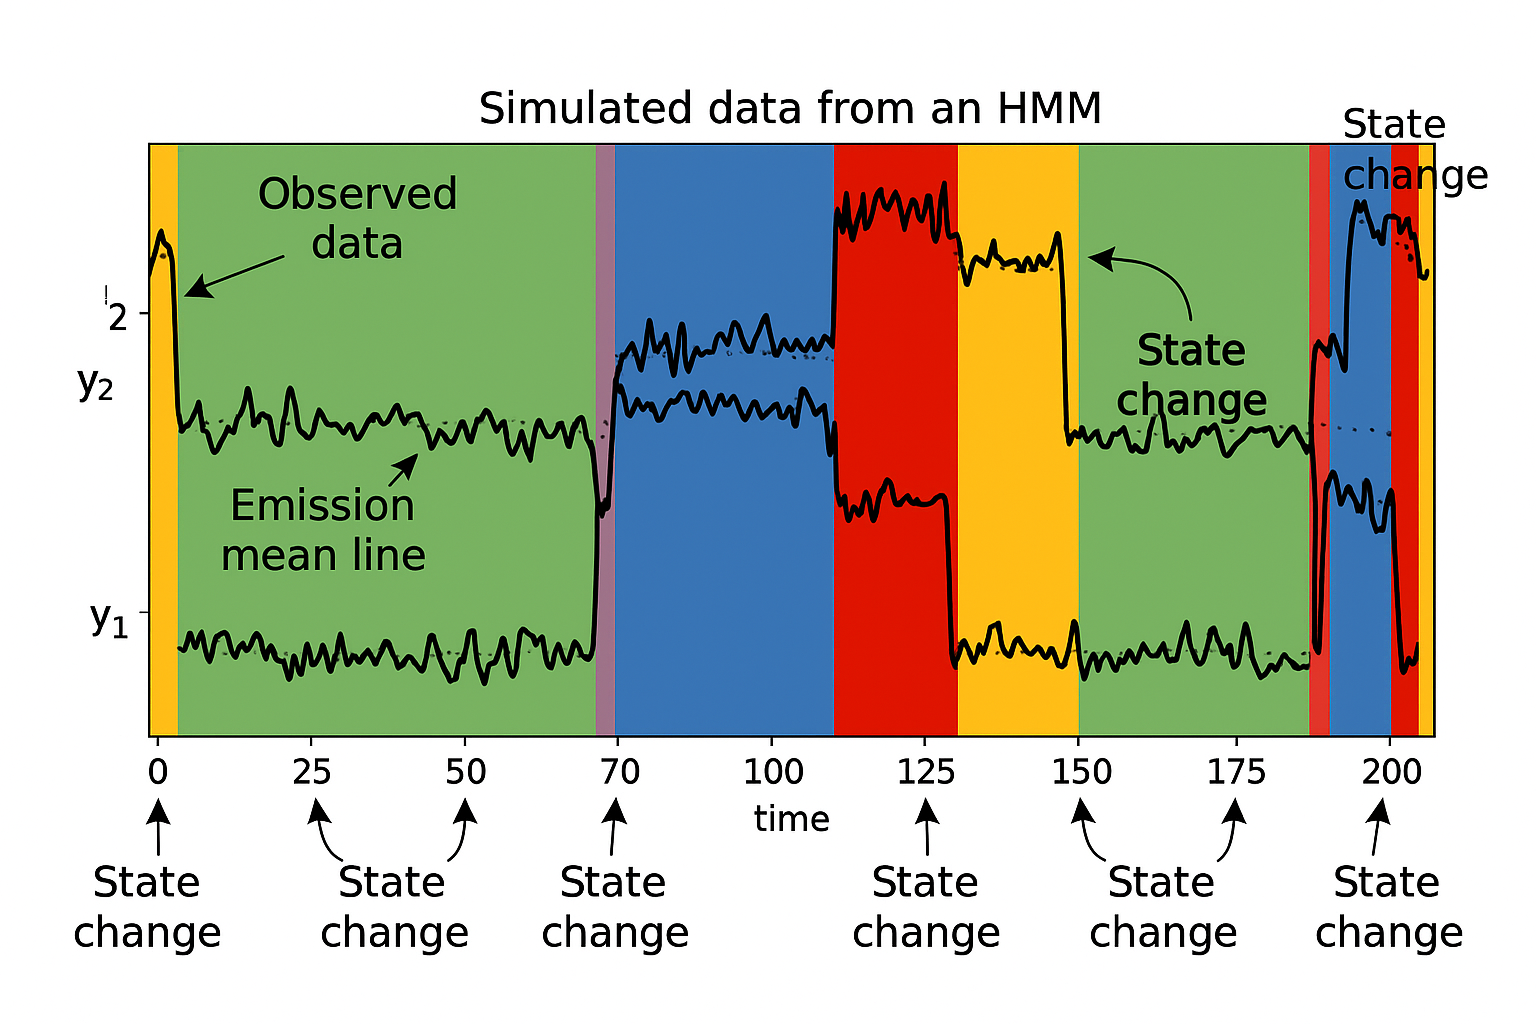
HMM with 5 Hidden States, and 2D-Gaussian Observation Model.
Left : HMM with 5 Hidden States, Right : 똑같은 HMM, 근데 Hidden State 이 이제는 색깔로 표현. y 축의 경우 y_1 과 y_2 값들을 의미하는 듯하며 두 개의 변수를 하나의 축으로 둔 것 같음. GPT 5’s Annotation (많이 틀리긴 함)
Autoregressive HMM Autoregressive-HMM 의 경우에는 기본적인 HMM 의 경우 z t z_t z t y t , y t − 1 , ⋯ y_t, y_{t-1}, \cdots y t , y t − 1 , ⋯ y t y_t y t y t − 1 , z t y_{t-1}, z_t y t − 1 , z t
예시로 Continuous 한 데이터에 대해서는 Observation Model 을 정규분포로 가정할 수 있습니다.
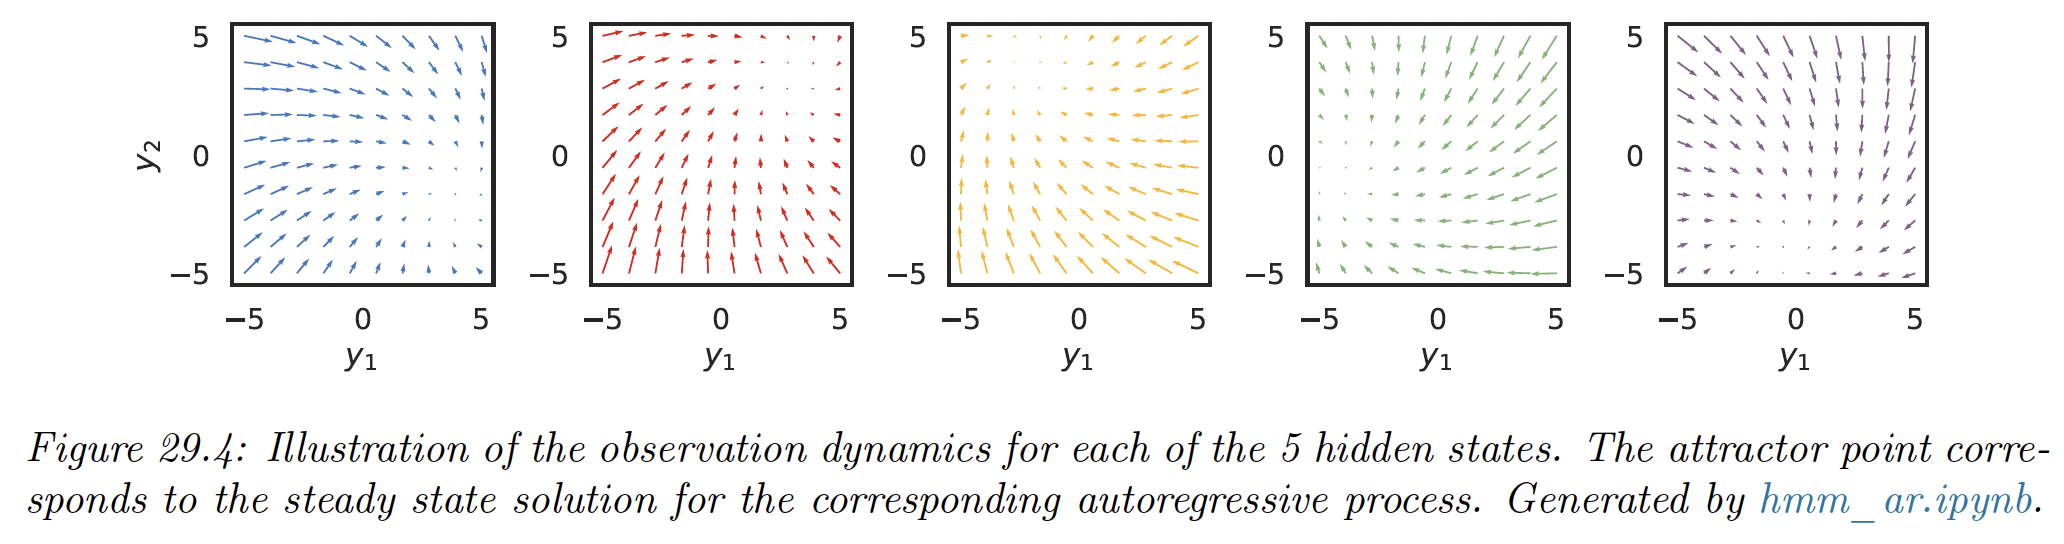
p ( y t ∣ y t − 1 , z t = j , θ ) = N ( y t ∣ E j y t − 1 + μ j , Σ j ) p\left(\boldsymbol{y}_t \mid \boldsymbol{y}_{t-1}, z_t=j, \boldsymbol{\theta}\right)=\mathcal{N}\left(\boldsymbol{y}_t \mid \mathbf{E}_j \boldsymbol{y}_{t-1}+\boldsymbol{\mu}_j, \boldsymbol{\Sigma}_j\right) p ( y t ∣ y t − 1 , z t = j , θ ) = N ( y t ∣ E j y t − 1 + μ j , Σ j ) E j \mathbf E_j E j y t − 1 \boldsymbol y_{t-1} y t − 1 t t t
각 Point ( y 1 , y 2 ) (y_1, y_2) ( y 1 , y 2 ) ( E j y + μ j ) − y \left(E_j y+\mu_j\right)-y ( E j y + μ j ) − y
결론적으로는 Standard HMM 에서는 y t y_t y t
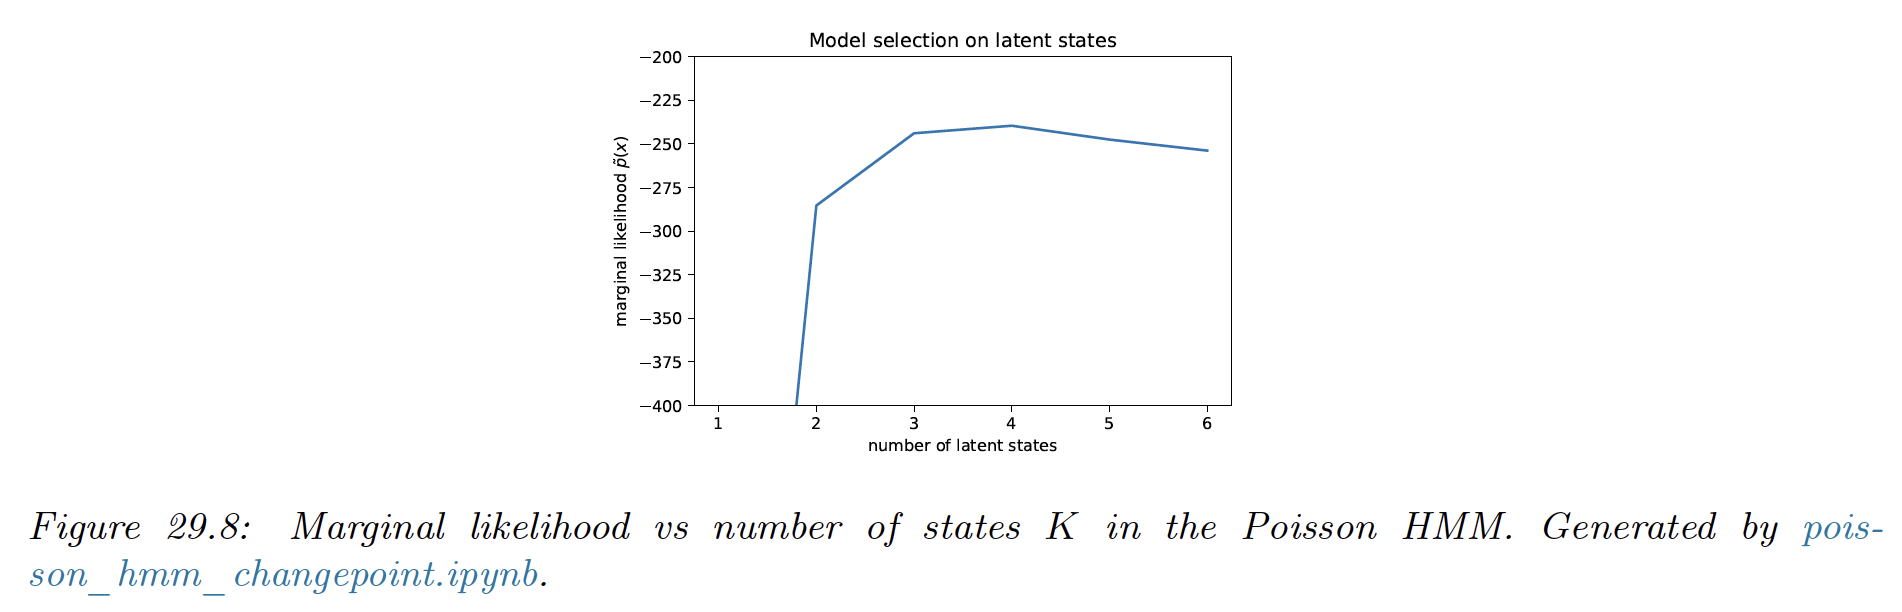
29.3 HMM Applications 데이터가 Fig 29.6(a) 에 보이시는 바와 같이 구성이 되어 있으며, 이것을 Fig 29.7 에 보이시는 바와 같이 State 들을 여러개로 쪼개서 SSM Model 을 Fit 시킬 수 있습니다. 특이하게도 4 4 4
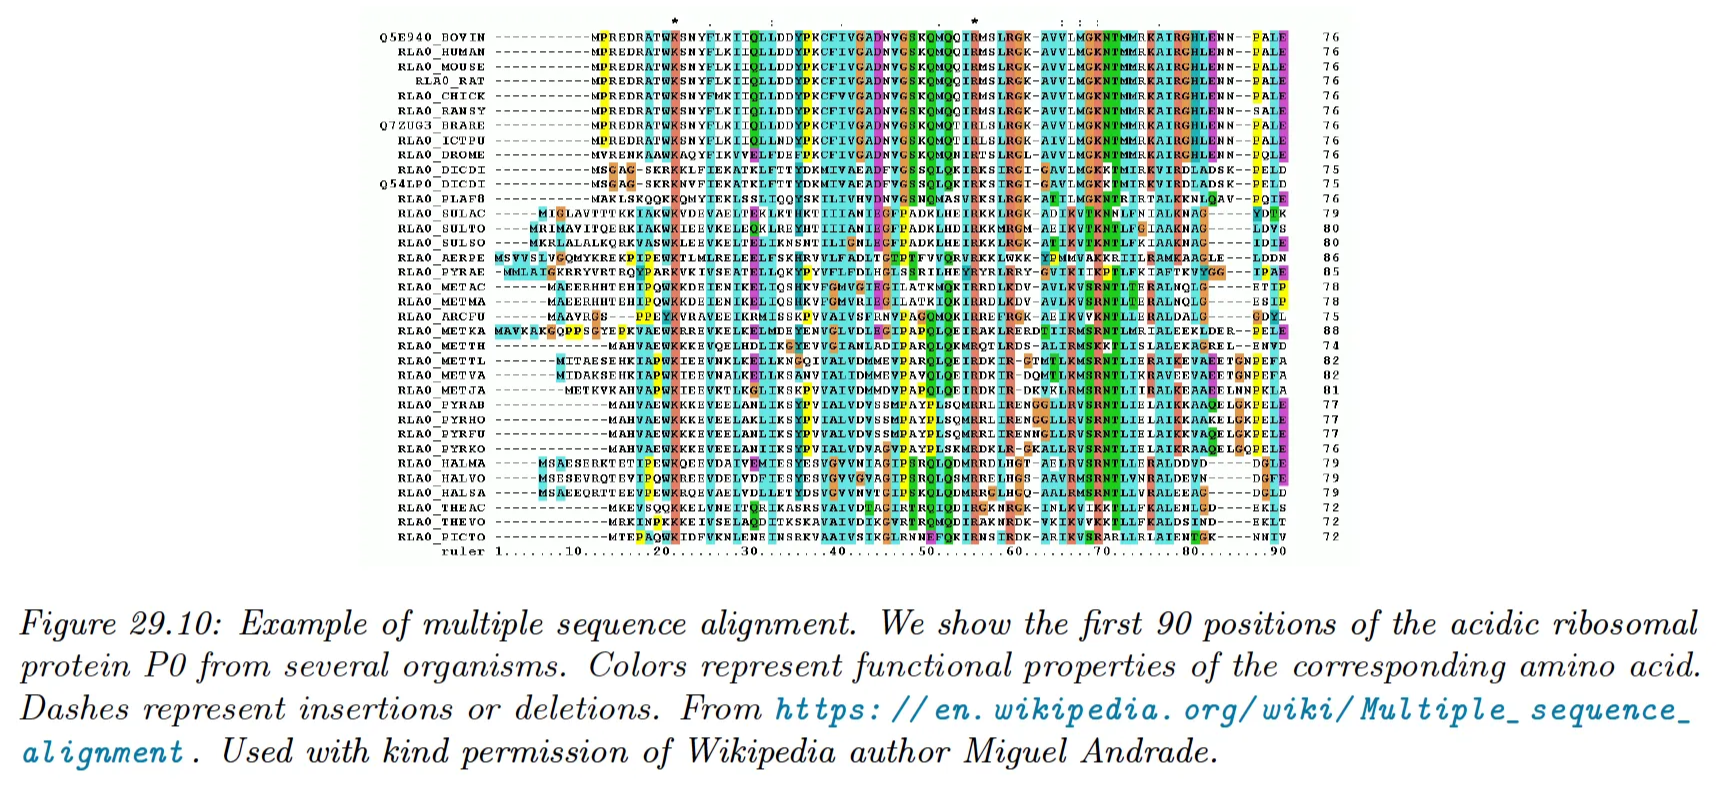
Specific Details : z 1 ∼ Categorical ( { 1 4 , 1 4 , 1 4 , 1 4 } ) z t ∣ z t − 1 ∼ Categorical ( { p if z t = z t − 1 1 − p 4 − 1 otherwise } ) \begin{aligned}z_1 & \sim \text { Categorical }\left(\left\{\frac{1}{4}, \frac{1}{4}, \frac{1}{4}, \frac{1}{4}\right\}\right) \\z_t \mid z_{t-1} & \sim \operatorname{Categorical}\left(\left\{\begin{array}{cc}p & \text { if } z_t=z_{t-1} \\\frac{1-p}{4-1} & \text { otherwise }\end{array}\right\}\right)\end{aligned} z 1 z t ∣ z t − 1 ∼ Categorical ( { 4 1 , 4 1 , 4 1 , 4 1 } ) ∼ Categorical ( { p 4 − 1 1 − p if z t = z t − 1 otherwise } ) Protein Alignment 에도 사용이 가능합니다.
29.4 Parameter Learning
29.4.1 EM-Algorithm p ( y 1 : T , z 1 : T ∣ θ ) = [ p ( z 1 ∣ π ) ] [ ∏ t = 2 T p ( z t ∣ z t − 1 , A ) ] [ ∏ t = 1 T p ( y t ∣ z t , B ) ] = [ ∏ k = 1 K π k I ( z 1 = k ) ] [ ∏ t = 2 T ∏ j = 1 K ∏ k = 1 K A j k I ( z t − 1 = j , z t = k ) ] [ ∏ t = 1 T ∏ k = 1 K p ( y t ∣ B k ) I ( z t = k ) ] = π z 1 ( ∏ t = 2 T A z t − 1 z t ) ( ∏ t = 1 T p ( y t ∣ z t ; B ) ) \begin{aligned}p\left(\boldsymbol{y}_{1: T}, \boldsymbol{z}_{1: T} \mid \boldsymbol{\theta}\right) & =\left[p\left(z_1 \mid \boldsymbol{\pi}\right)\right]\left[\prod_{t=2}^T p\left(z_t \mid z_{t-1}, \mathbf{A}\right)\right]\left[\prod_{t=1}^T p\left(\boldsymbol{y}_t \mid z_t, \mathbf{B}\right)\right] \\& =\left[\prod_{k=1}^K \pi_k^{\mathbb{I}\left(z_1=k\right)}\right]\left[\prod_{t=2}^T \prod_{j=1}^K \prod_{k=1}^K A_{j k}^{\mathbb{I}\left(z_{t-1}=j, z_t=k\right)}\right]\left[\prod_{t=1}^T \prod_{k=1}^K p\left(\boldsymbol{y}_t \mid \mathbf{B}_k\right)^{\mathbb{I}\left(z_t=k\right)}\right]
\\
&=
\pi_{z_1}\left(\prod_{t=2}^T A_{z_{t-1} z_t}\right)\left(\prod_{t=1}^T p\left(y_t \mid z_t ; B\right)\right)
\end{aligned} p ( y 1 : T , z 1 : T ∣ θ ) = [ p ( z 1 ∣ π ) ] [ t = 2 ∏ T p ( z t ∣ z t − 1 , A ) ] [ t = 1 ∏ T p ( y t ∣ z t , B ) ] = [ k = 1 ∏ K π k I ( z 1 = k ) ] [ t = 2 ∏ T j = 1 ∏ K k = 1 ∏ K A jk I ( z t − 1 = j , z t = k ) ] [ t = 1 ∏ T k = 1 ∏ K p ( y t ∣ B k ) I ( z t = k ) ] = π z 1 ( t = 2 ∏ T A z t − 1 z t ) ( t = 1 ∏ T p ( y t ∣ z t ; B ) ) EM 의 목적 : Maximize log p θ ( y 1 : T ) \log p_\theta(y_{1:T}) log p θ ( y 1 : T ) θ = ( π , A , B ) \theta = (\pi, A, B) θ = ( π , A , B ) z 1 : T z_{1:T} z 1 : T
Compute Expected Statistics Under θ old \boldsymbol \theta^{\text{old}} θ old
State Marginal : γ n , t ( j ) ≜ p ( z t = j ∣ y n , 1 : T n , θ old ) \gamma_{n, t}(j) \triangleq p\left(z_t=j \mid \boldsymbol{y}_{n, 1: T_n}, \boldsymbol{\theta}^{\text {old }}\right) γ n , t ( j ) ≜ p ( z t = j ∣ y n , 1 : T n , θ old ) Transition Marginal : ξ n , t ( j , k ) ≜ p ( z t − 1 = j , z t = k ∣ y n , 1 : T n , θ old ) \xi_{n, t}(j, k) \triangleq p\left(z_{t-1}=j, z_t=k \mid \boldsymbol{y}_{n, 1: T_n}, \boldsymbol{\theta}^{\text {old }}\right) ξ n , t ( j , k ) ≜ p ( z t − 1 = j , z t = k ∣ y n , 1 : T n , θ old ) 그런 다음에 이것을 활용해서 Complete-Data Log Likelihood 를 구축하면 됩니다.
Q ( θ ∣ θ old ) = E p ( z 1 : T ∣ y 1 : T , θ old ) [ log p ( y 1 : T , z 1 : T ∣ θ ) ] Q\left(\theta \mid \theta^{\text {old }}\right)=\mathbb{E}_{p\left(z_{1: T} \mid y_{1: T}, \theta^{\text {old }}\right)}\left[\log p\left(y_{1: T}, z_{1: T} \mid \theta\right)\right] Q ( θ ∣ θ old ) = E p ( z 1 : T ∣ y 1 : T , θ old ) [ log p ( y 1 : T , z 1 : T ∣ θ ) ] 여기에서 γ \gamma γ ξ \xi ξ
Q ( θ ∣ θ old ) = ∑ j γ 1 ( j ) log π j + ∑ t = 2 T ∑ i , j ξ t ( i , j ) log A i j + ∑ t = 1 T ∑ j γ t ( j ) log p ( y t ∣ z t = j ; B ) . \begin{aligned}Q\left(\theta \mid \theta^{\text {old }}\right)= & \sum_j \gamma_1(j) \log \pi_j \\& +\sum_{t=2}^T \sum_{i, j} \xi_t(i, j) \log A_{i j} \\& +\sum_{t=1}^T \sum_j \gamma_t(j) \log p\left(y_t \mid z_t=j ; B\right) .\end{aligned} Q ( θ ∣ θ old ) = j ∑ γ 1 ( j ) log π j + t = 2 ∑ T i , j ∑ ξ t ( i , j ) log A ij + t = 1 ∑ T j ∑ γ t ( j ) log p ( y t ∣ z t = j ; B ) . Maximize Each parameter ( π , A , B ) (\pi, A, B) ( π , A , B ) ∑ j π j = 1 , ∑ j A i j = 1 \sum_j \pi_j = 1, \sum_j A_{ij} = 1 ∑ j π j = 1 , ∑ j A ij = 1
π j new = ∑ n γ n , 1 ( j ) ∑ n 1 \pi_j^{\text {new }}=\frac{\sum_n \gamma_{n, 1}(j)}{\sum_n 1} π j new = ∑ n 1 ∑ n γ n , 1 ( j ) N i j = ∑ n ∑ t = 2 T n ξ n , t ( i , j ) , N i = ∑ j N i j = ∑ n ∑ t = 2 T n γ n , t − 1 ( i ) . N_{i j}=\sum_n \sum_{t=2}^{T_n} \xi_{n, t}(i, j), \quad N_i=\sum_j N_{i j}=\sum_n \sum_{t=2}^{T_n} \gamma_{n, t-1}(i) . N ij = n ∑ t = 2 ∑ T n ξ n , t ( i , j ) , N i = j ∑ N ij = n ∑ t = 2 ∑ T n γ n , t − 1 ( i ) . A i j n e w = N i j N i . A_{i j}^{n e w}=\frac{N_{i j}}{N_i .} A ij n e w = N i . N ij C j v = ∑ n ∑ t γ n , t ( j ) 1 [ y n , t = v ] , N j = ∑ n ∑ t γ n , t ( j ) C_{j v}=\sum_n \sum_t \gamma_{n, t}(j) \mathbf{1}\left[y_{n, t}=v\right], \quad N_j=\sum_n \sum_t \gamma_{n, t}(j) C j v = n ∑ t ∑ γ n , t ( j ) 1 [ y n , t = v ] , N j = n ∑ t ∑ γ n , t ( j ) B j v new = C j v N j B_{j v}^{\text {new }}=\frac{C_{j v}}{N_j} B j v new = N j C j v E-Step 과 M-Step 을 반복시키면 EM-Algorithm 이 됩니다.
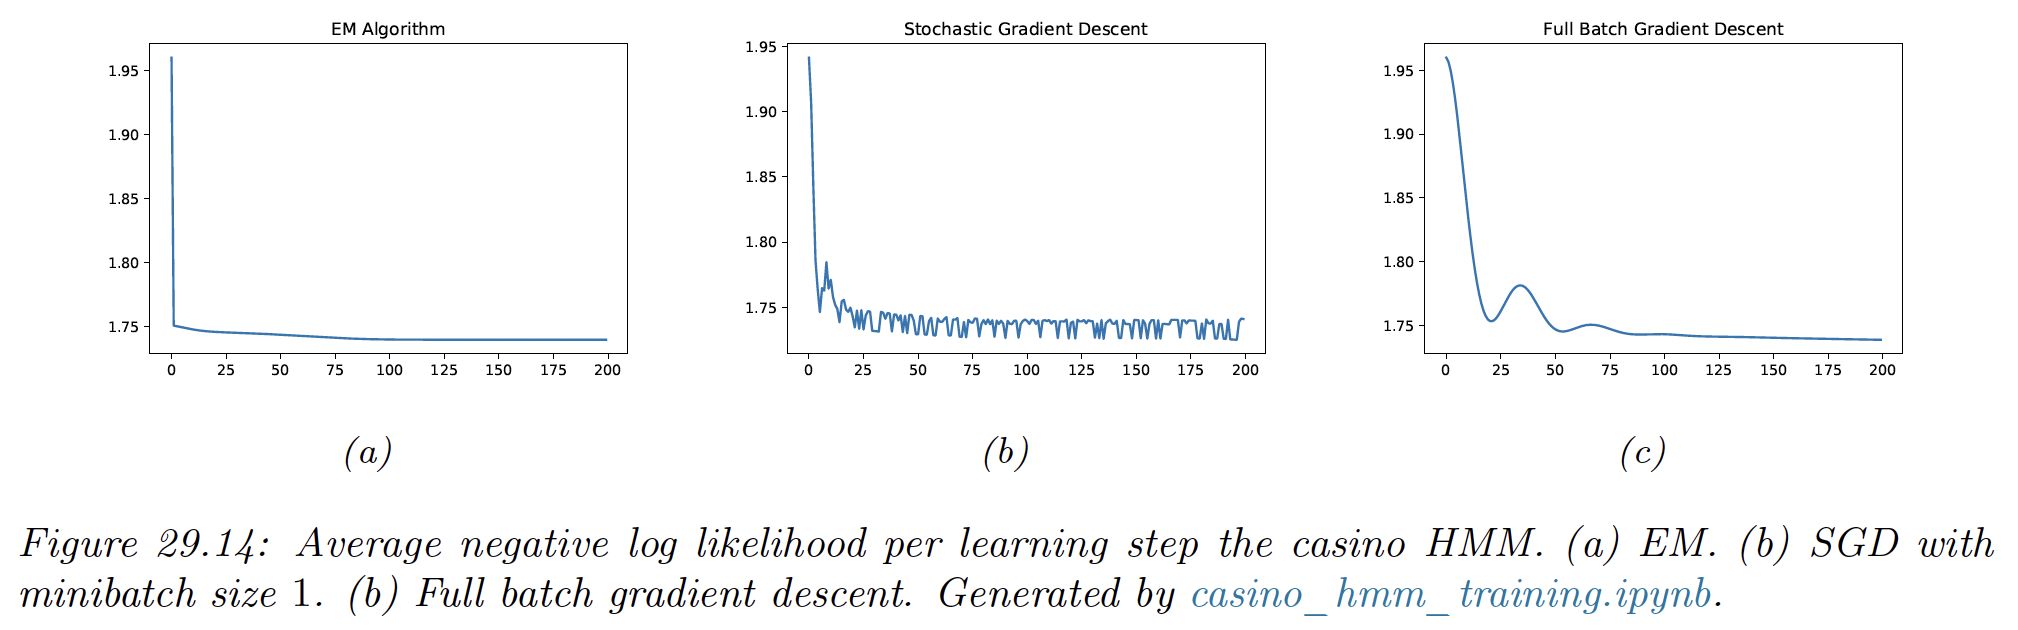
요즘 안 사용하는 이유? Scaling Issue…
SGD 으로도 똑같은 것을 할 수가 있다 → \rightarrow →
29.4.4 Bayesian HMM’s 정말로 별거가 아니라 이제는 θ = ( π , A , B ) \theta = (\pi, A, B) θ = ( π , A , B )
log p ( θ , D ) = log p ( θ ) + ∑ n = 1 N log p ( y 1 : T , n ∣ θ ) \log p(\boldsymbol{\theta}, \mathcal{D})=\log p(\boldsymbol{\theta})+\sum_{n=1}^N \log p\left(\boldsymbol{y}_{1: T, n} \mid \boldsymbol{\theta}\right) log p ( θ , D ) = log p ( θ ) + n = 1 ∑ N log p ( y 1 : T , n ∣ θ ) 보통은 다음과 같은 Prior 들을 사용한다고 합니다 (Conjugate Priors, when Posterior and Prior follow the same Distribution).
Dirichlet 분포를 Prior 으로 자주 사용하는 이유?
확률벡터 π = ( π 1 , ⋯ , π K ) \pi = (\pi_1, \cdots, \pi_K) π = ( π 1 , ⋯ , π K ) α \alpha α
f ( x 1 , … , x K ; α 1 , … , α K ) = 1 B ( α ) ∏ i = 1 K x i α i − 1 f\left(x_1, \ldots, x_K ; \alpha_1, \ldots, \alpha_K\right)=\frac{1}{\mathrm{~B}(\boldsymbol{\alpha})} \prod_{i=1}^K x_i^{\alpha_i-1} f ( x 1 , … , x K ; α 1 , … , α K ) = B ( α ) 1 i = 1 ∏ K x i α i − 1 결론적으로는 Bayesian HMM 에서는 Dirichlet Prior 를 많이 사용하며, 이것을 사용하는 이유로는 데이터를 보고 난 다음에 Category 들에 대한 Histogram 으로 그려줄 수 있기 때문이다.
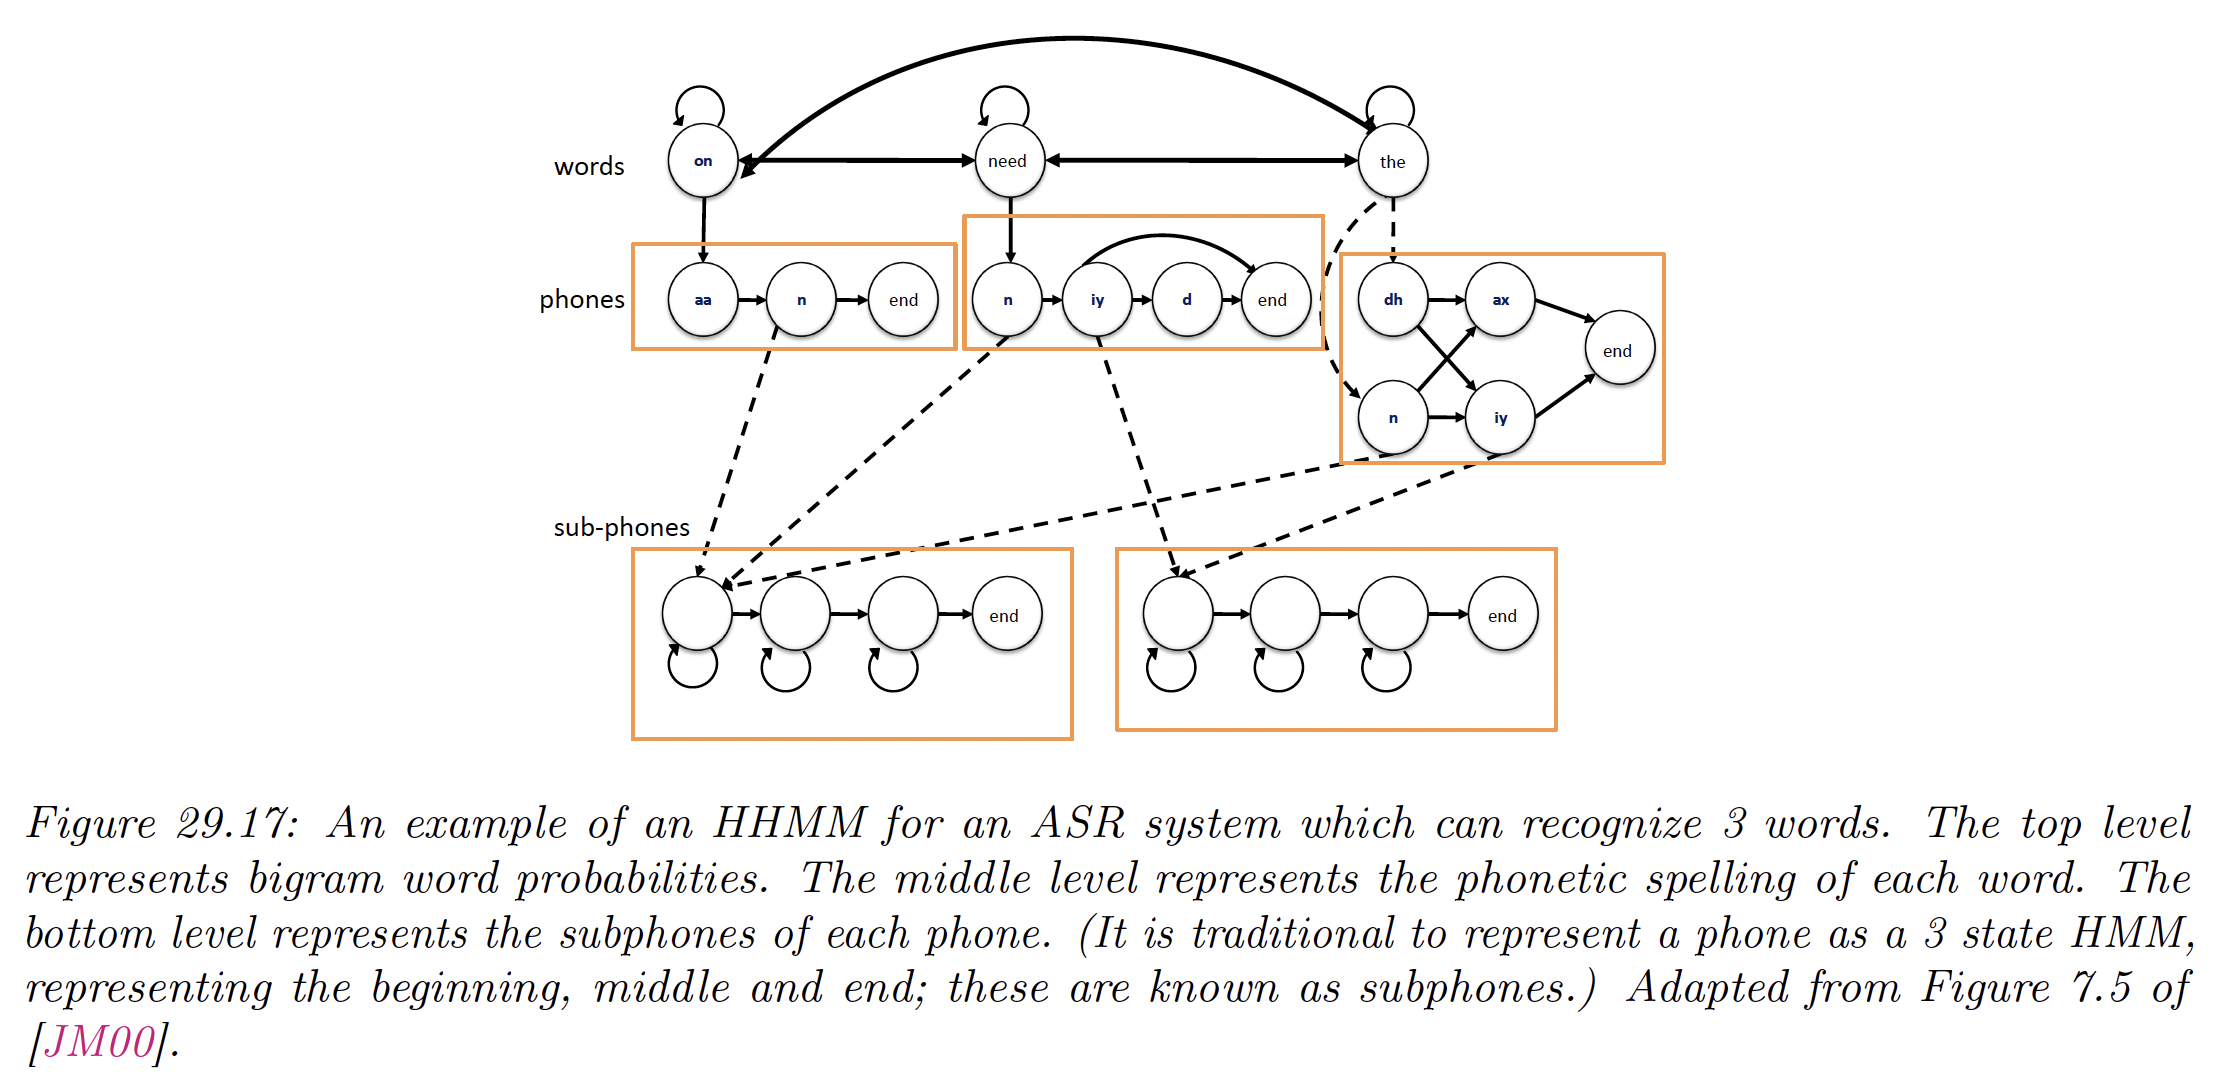
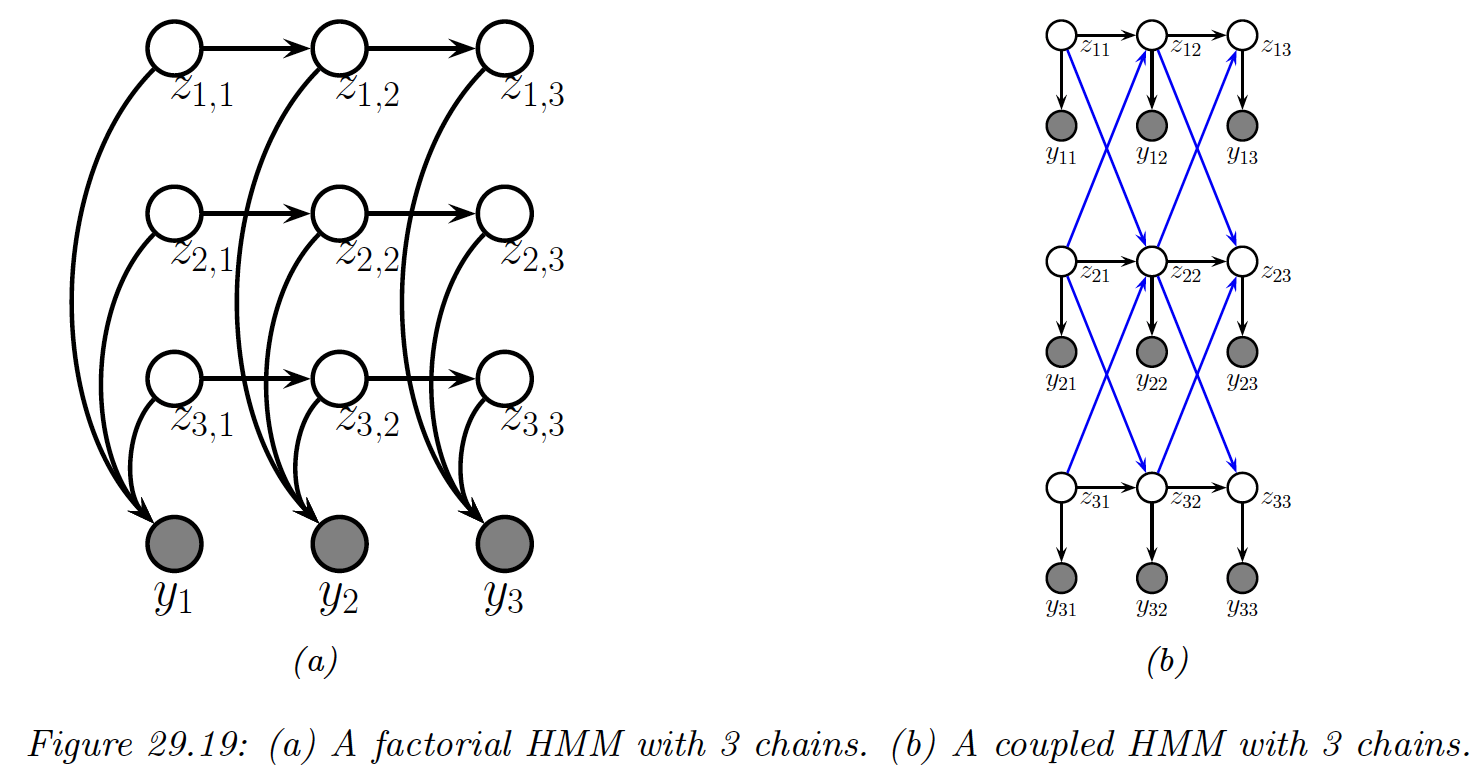
29.5 HMMs : Generalizations Hidden Semi-Markov Model (HSMM)Standard HMM 에서는 State i i i d d d p ( d i = d ) p(d_i = d) p ( d i = d ) 이러한 Duration d t d_t d t Why Semi-Markov? 이제는 Hidden 이 State 자체에서만 Markov 한게 아니기에. Hierarchical HMMs (HHMM)State 자체를 Sub-HMM 으로 바라보는 개념. Phone : Basic unit of sound in a spoken languageWords → \rightarrow → Each Phone → \rightarrow → Factorial HMMs (FHMM)p ( z 1 : T 1 : M , y 1 : T ) = ∏ m = 1 M p ( z 1 ( m ) ) ∏ t > 2 p ( z t ( m ) ∣ z t − 1 ( m ) ) ∏ t = 1 T p ( y t ∣ z t ( 1 ) , … , z t ( M ) ) p\left(\mathbf{z}_{1: T}^{1: M}, y_{1: T}\right)=\prod_{m=1}^M p\left(z_1^{(m)}\right) \prod_{t>2} p\left(z_t^{(m)} \mid z_{t-1}^{(m)}\right) \prod_{t=1}^T p\left(y_t \mid z_t^{(1)}, \ldots, z_t^{(M)}\right) p ( z 1 : T 1 : M , y 1 : T ) = ∏ m = 1 M p ( z 1 ( m ) ) ∏ t > 2 p ( z t ( m ) ∣ z t − 1 ( m ) ) ∏ t = 1 T p ( y t ∣ z t ( 1 ) , … , z t ( M ) ) State 1 개를 Chain (Factor) 으로 바라보는 것. Coupled HMMsFHMM 에서의 Chain 들이 서로에게 이제는 영향을 끼친다.
29.6 Linear Dynamical Systems (LDS) 이 장에서는 구체적으로 Linear-Gaussian State-Space Model (LG-SSM), a.k.a LDS 에 대해서 다룹니다.
Transition Function f \boldsymbol f f h \boldsymbol h h Process Noise q t \boldsymbol q_t q t r t \boldsymbol r_t r t 정의 자체는 그래서 다음과 같이 해줄 수가 있습니다.
p ( z t ∣ z t − 1 , u t ) = N ( z t ∣ F t z t − 1 + B t u t + b t , Q t ) p ( y t ∣ z t , u t ) = N ( y t ∣ H t z t + D t u t + d t , R t ) \begin{aligned}p\left(\boldsymbol{z}_t \mid \boldsymbol{z}_{t-1}, \boldsymbol{u}_t\right) & =\mathcal{N}\left(\boldsymbol{z}_t \mid \mathbf{F}_t \boldsymbol{z}_{t-1}+\mathbf{B}_t \boldsymbol{u}_t+\boldsymbol{b}_t, \mathbf{Q}_t\right) \\p\left(\boldsymbol{y}_t \mid \boldsymbol{z}_t, \boldsymbol{u}_t\right) & =\mathcal{N}\left(\boldsymbol{y}_t \mid \mathbf{H}_t \boldsymbol{z}_t+\mathbf{D}_t \boldsymbol{u}_t+\boldsymbol{d}_t, \mathbf{R}_t\right)\end{aligned} p ( z t ∣ z t − 1 , u t ) p ( y t ∣ z t , u t ) = N ( z t ∣ F t z t − 1 + B t u t + b t , Q t ) = N ( y t ∣ H t z t + D t u t + d t , R t ) Bias 가 없고 Input 이 없다면 모델은 다음과 같이 Simplify 됩니다.
p ( z t ∣ z t − 1 ) = N ( z t ∣ F t z t − 1 , Q t ) p ( y t ∣ z t ) = N ( y t ∣ H t z t , R t ) \begin{aligned}p\left(\boldsymbol{z}_t \mid \boldsymbol{z}_{t-1}\right) & =\mathcal{N}\left(\boldsymbol{z}_t \mid \mathbf{F}_t \boldsymbol{z}_{t-1}, \mathbf{Q}_t\right) \\p\left(\boldsymbol{y}_t \mid \boldsymbol{z}_t\right) & =\mathcal{N}\left(\boldsymbol{y}_t \mid \mathbf{H}_t \boldsymbol{z}_t, \mathbf{R}_t\right)\end{aligned} p ( z t ∣ z t − 1 ) p ( y t ∣ z t ) = N ( z t ∣ F t z t − 1 , Q t ) = N ( y t ∣ H t z t , R t ) 그러면 이것을 방정식으로 다음과 같이 적어줄 수 있게 됩니다.
z t = F t z t − 1 + q t y t = H t z t + r t \begin{aligned}\boldsymbol{z}_t & =\mathbf{F}_t \boldsymbol{z}_{t-1}+\boldsymbol{q}_t \\\boldsymbol{y}_t & =\mathbf{H}_t \boldsymbol{z}_t+\boldsymbol{r}_t\end{aligned} z t y t = F t z t − 1 + q t = H t z t + r t q t ∼ N ( 0 , Q t ) : \boldsymbol{q}_t \sim \mathcal{N}\left(\mathbf{0}, \mathbf{Q}_t\right) : q t ∼ N ( 0 , Q t ) : r t ∼ N ( 0 , R t ) : \boldsymbol{r}_t \sim \mathcal{N}\left(\mathbf{0}, \mathbf{R}_t\right) : r t ∼ N ( 0 , R t ) : 여기에서 저희의 파라미터들은 그러면 다음과 같습니다 (보통은 t t t
θ t = ( F t , H t , B t , D t , Q t , R t ) \boldsymbol{\theta}_t=\left(\mathbf{F}_t, \mathbf{H}_t, \mathbf{B}_t, \mathbf{D}_t, \mathbf{Q}_t, \mathbf{R}_t\right) θ t = ( F t , H t , B t , D t , Q t , R t )
29.7 LDS: Applications
29.7.1 Object Tracking 2차원에서 놀고 있는 Object 을 생각해보겠습니다. 이때 Position 이 ( u t , v t ) (u_t, v_t) ( u t , v t ) ( u ˙ t , v ˙ t ) \left(\dot{u}_t,\dot{v}_t\right) ( u ˙ t , v ˙ t ) t t t z t = ( u t v t u ˙ t v ˙ t ) \boldsymbol{z}_t=\left(\begin{array}{llll}u_t & v_t & \dot{u}_t & \dot{v}_t\end{array}\right) z t = ( u t v t u ˙ t v ˙ t )
Discrete Time 만 고려하면 Discrete Time SSM 은 다음과 같습니다.
( u t v t u ˙ t v ˙ t ) ⏟ z t = ( 1 0 Δ 0 0 1 0 Δ 0 0 1 0 0 0 0 1 ) ⏟ F ( u t − 1 v t − 1 u ˙ t − 1 v ˙ t − 1 ) ⏟ z t − 1 + q t \underbrace{\left(\begin{array}{c}u_t \\v_t \\\dot{u}_t \\\dot{v}_t\end{array}\right)}_{\boldsymbol{z}_t}=\underbrace{\left(\begin{array}{cccc}1 & 0 & \Delta & 0 \\0 & 1 & 0 & \Delta \\0 & 0 & 1 & 0 \\0 & 0 & 0 & 1\end{array}\right)}_{\mathbf{F}} \underbrace{\left(\begin{array}{c}u_{t-1} \\v_{t-1} \\\dot{u}_{t-1} \\\dot{v}_{t-1}\end{array}\right)}_{\boldsymbol{z}_{t-1}}+\boldsymbol{q}_t z t u t v t u ˙ t v ˙ t = F 1 0 0 0 0 1 0 0 Δ 0 1 0 0 Δ 0 1 z t − 1 u t − 1 v t − 1 u ˙ t − 1 v ˙ t − 1 + q t Δ : \Delta : Δ : q t ∼ N ( 0 , Q ) : \boldsymbol{q}_t \sim \mathcal{N}(\mathbf{0}, \mathbf{Q}) : q t ∼ N ( 0 , Q ) : Noise Covariance Matrix Q : \mathbf Q : Q : Q = ( q 1 Δ 3 3 0 q 1 Δ 2 2 0 0 q 2 Δ 3 3 0 q 2 Δ 2 2 q 1 Δ 2 2 0 q 1 Δ 0 0 q 2 Δ 2 2 0 q 2 Δ ) \mathbf{Q}=\left(\begin{array}{cccc}\frac{q_1 \Delta^3}{3} & 0 & \frac{q_1 \Delta^2}{2} & 0 \\0 & \frac{q_2 \Delta^3}{3} & 0 & \frac{q_2 \Delta^2}{2} \\\frac{q_1 \Delta^2}{2} & 0 & q_1 \Delta & 0 \\0 & \frac{q_2 \Delta^2}{2} & 0 & q_2 \Delta\end{array}\right) Q = 3 q 1 Δ 3 0 2 q 1 Δ 2 0 0 3 q 2 Δ 3 0 2 q 2 Δ 2 2 q 1 Δ 2 0 q 1 Δ 0 0 2 q 2 Δ 2 0 q 2 Δ Position 부분에만 Δ \Delta Δ q t \boldsymbol q_t q t Δ \Delta Δ 우하단 : Velocity 는 Acceleration 한 번 적분한 것이기에 Velocity Variance 는 시간에 따라서 Linear 하다. 좌상단 : Position 은 Acceleration 두 번 적분한 것이기에 Position Variance 는 시간에 따라서 Cubic 하다. Off-Diagonals : Position 과 Velocity 의 Covariance 부분, 시간에 따라서 Quadratic 하다. 이러한 세팅에서 Location 을 관측한다고 해보자. 이때 Location 에 대한 Gaussian Noise 까지 있다고 하면, 다음과 같이 Observation Model 을 구축할 수가 있다.
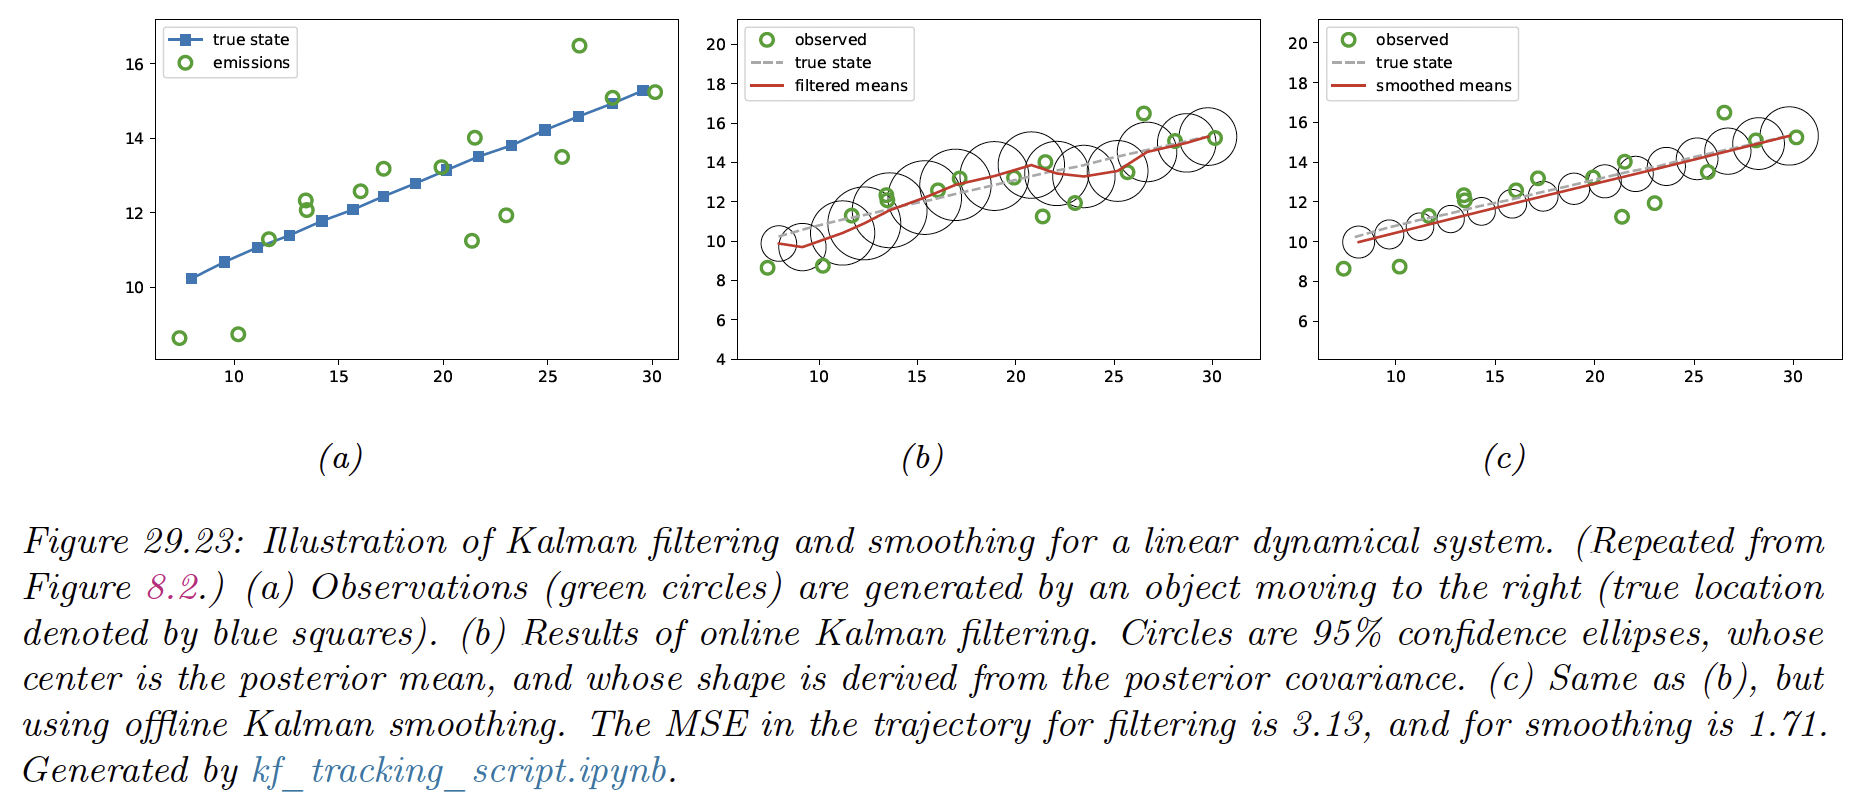
( y 1 , t y 2 , t ) ⏟ y t = ( 1 0 0 0 0 0 1 0 ) ⏟ H ( u t u ˙ t v t v ˙ t ) ⏟ z t + r t \underbrace{\binom{y_{1, t}}{y_{2, t}}}_{\boldsymbol{y}_t}=\underbrace{\left(\begin{array}{llll}1 & 0 & 0 & 0 \\0 & 0 & 1 & 0\end{array}\right)}_{\mathbf{H}} \underbrace{\left(\begin{array}{l}u_t \\\dot{u}_t \\v_t \\\dot{v}_t\end{array}\right)}_{\boldsymbol{z}_t}+\boldsymbol{r}_t y t ( y 2 , t y 1 , t ) = H ( 1 0 0 0 0 1 0 0 ) z t u t u ˙ t v t v ˙ t + r t r t ∼ N ( 0 , R ) : \boldsymbol{r}_t \sim \mathcal{N}(\mathbf{0}, \mathbf{R}) : r t ∼ N ( 0 , R ) : 이것의 움직임을 (a), Kalman Filter 을 통해서 p ( z t ∣ y 1 : t , θ ) p(\boldsymbol z_t \mid \boldsymbol y_{1:t}, \boldsymbol \theta) p ( z t ∣ y 1 : t , θ )
29.8 LDS: Parameter Learning
29.9 Switching Linear Dynamical Systems (SLDS) Discrete Mode 가 있으며 이에 해당되는 Continuous R.V 들이 존재.
비유를 하자면 자동차가 상하좌우로 갈지에 대한 Mode m t m_t m t z t z_t z t
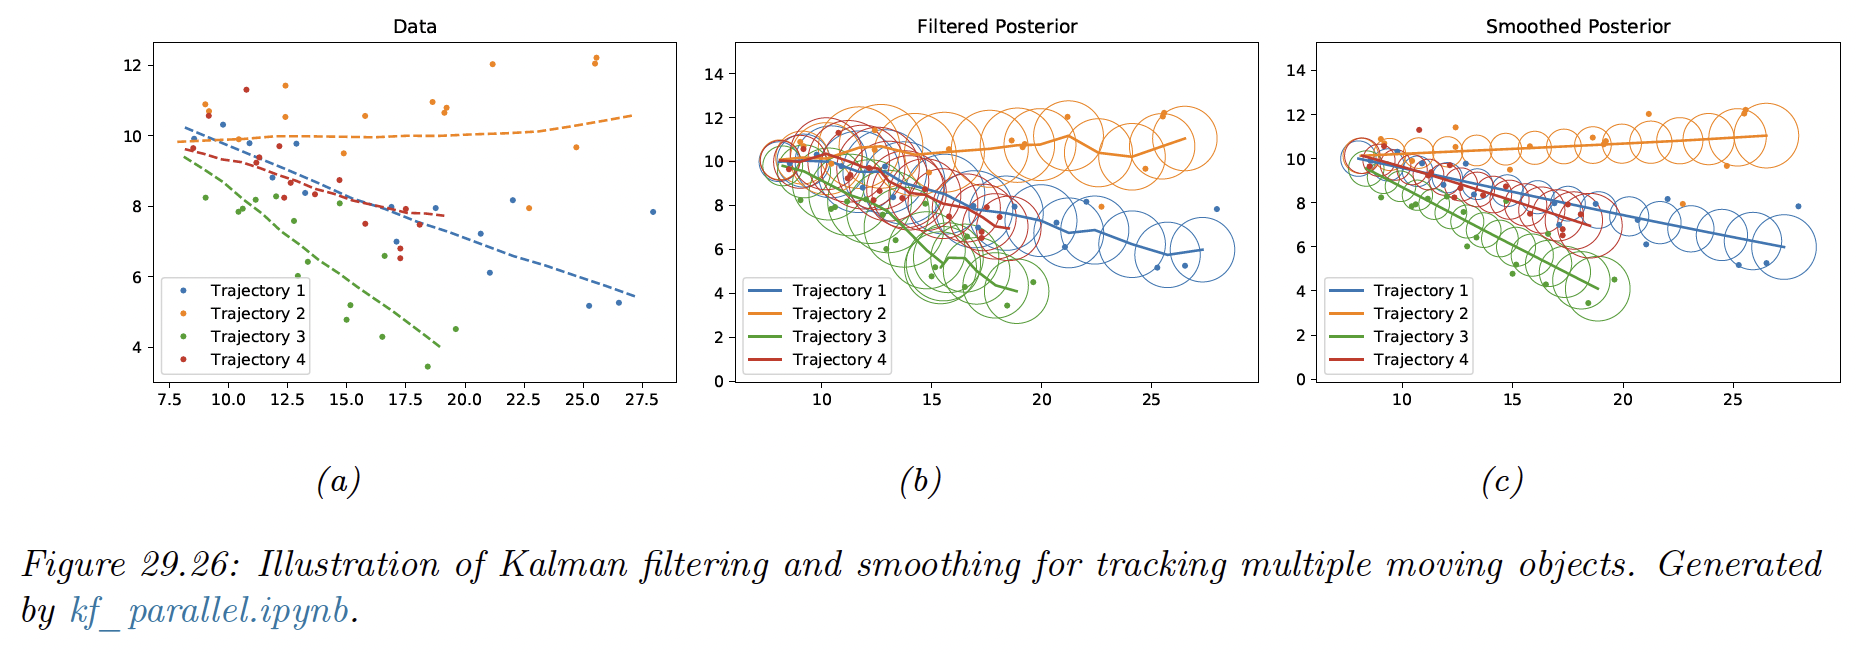
p ( m t = k ∣ m t − 1 = j ) = A j k p ( z t ∣ z t − 1 , m t = k , u t ) = N ( z t ∣ F k z t − 1 + B k u t + b k , Q k ) p ( y t ∣ z t , m t = k , u t ) = N ( y t ∣ H k z t + D k u t + d k , R k ) \begin{aligned}p\left(m_t=k \mid m_{t-1}=j\right) & =A_{j k} \\p\left(\boldsymbol{z}_t \mid \boldsymbol{z}_{t-1}, m_t=k, \boldsymbol{u}_t\right) & =\mathcal{N}\left(\boldsymbol{z}_t \mid \mathbf{F}_k \boldsymbol{z}_{t-1}+\mathbf{B}_k \boldsymbol{u}_t+\boldsymbol{b}_k, \mathbf{Q}_k\right) \\p\left(\boldsymbol{y}_t \mid \boldsymbol{z}_t, m_t=k, \boldsymbol{u}_t\right) & =\mathcal{N}\left(\boldsymbol{y}_t \mid \mathbf{H}_k \boldsymbol{z}_t+\mathbf{D}_k \boldsymbol{u}_t+\boldsymbol{d}_k, \mathbf{R}_k\right)\end{aligned} p ( m t = k ∣ m t − 1 = j ) p ( z t ∣ z t − 1 , m t = k , u t ) p ( y t ∣ z t , m t = k , u t ) = A jk = N ( z t ∣ F k z t − 1 + B k u t + b k , Q k ) = N ( y t ∣ H k z t + D k u t + d k , R k ) 실제 Moving Object 에 이것을 적용시키면 다음과 같이 나온다.
29.10 Nonlinear SSMs 이제는 SSM 들의 Transition / Observation Function 들이 비선형이라는 가정이 들어갑니다. 보통은 그래서 가우시안으로 둘 수가 있으며, General 하게는 다음과 같습니다.
z t = f ( z t − 1 , u t ) + q t q t ∼ N ( 0 , Q t ) y t = h ( z t , u t ) + r t r t ∼ N ( 0 , R t ) \begin{aligned}\boldsymbol{z}_t & =\boldsymbol{f}\left(\boldsymbol{z}_{t-1}, \boldsymbol{u}_t\right)+\boldsymbol{q}_t \\\boldsymbol{q}_t & \sim \mathcal{N}\left(\mathbf{0}, \mathbf{Q}_t\right) \\\boldsymbol{y}_t & =\boldsymbol{h}\left(\boldsymbol{z}_t, \boldsymbol{u}_t\right)+\boldsymbol{r}_t \\\boldsymbol{r}_t & \sim \mathcal{N}\left(\mathbf{0}, \mathbf{R}_t\right)\end{aligned} z t q t y t r t = f ( z t − 1 , u t ) + q t ∼ N ( 0 , Q t ) = h ( z t , u t ) + r t ∼ N ( 0 , R t ) 위의 가우시안 세팅이 아닌 Non-Gaussian 으로 두게 된다면 Non-Gaussian SSM (NSSM) 이 됩니다.
Neuroscience 에t서 Neural Spike Train 모델링하는데 사용. 금융에서 Log-Return 을 모델링하는데에 사용.
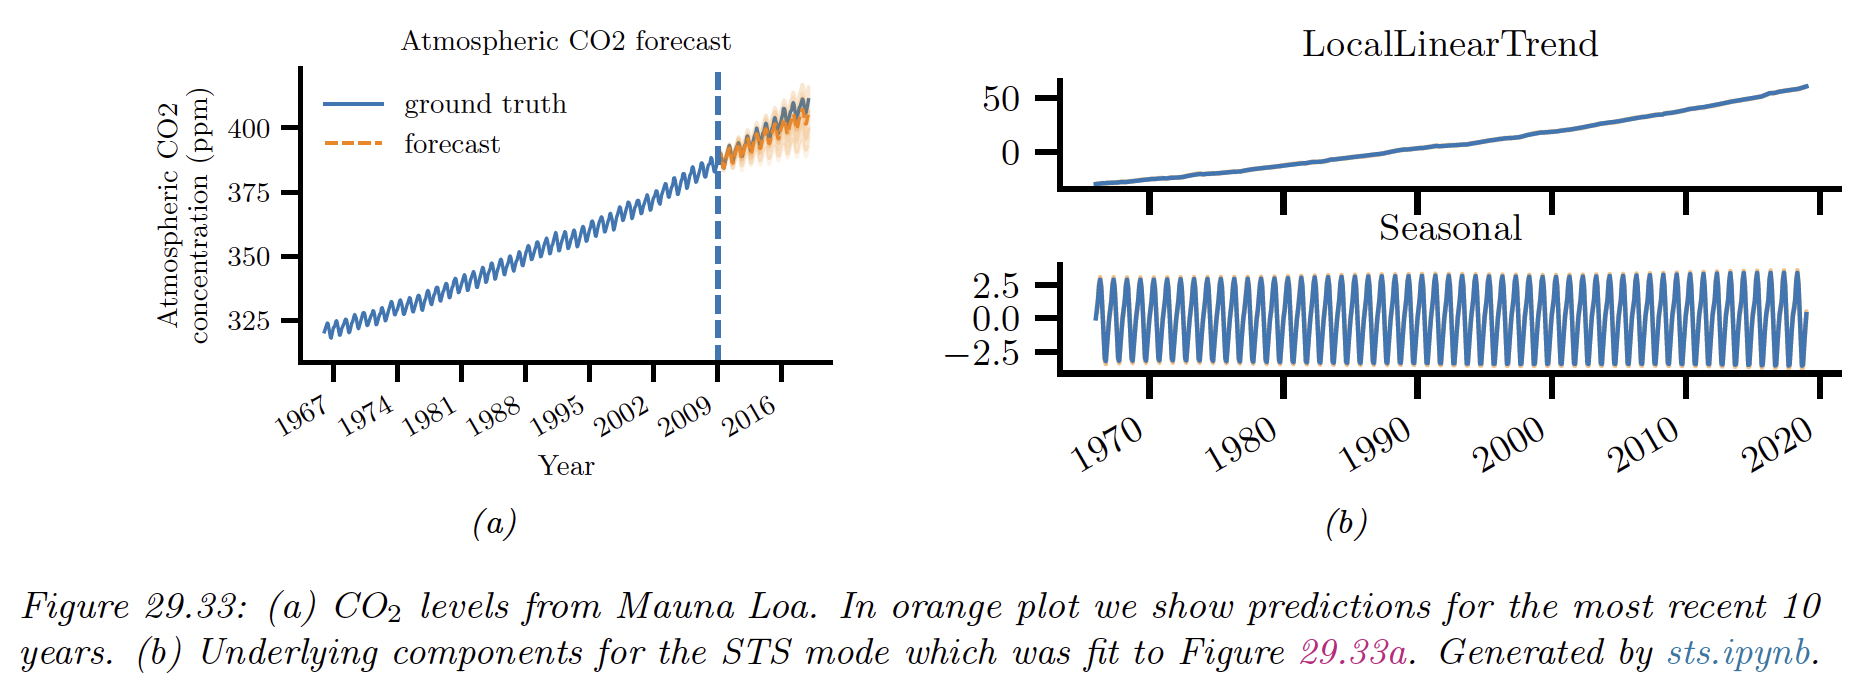
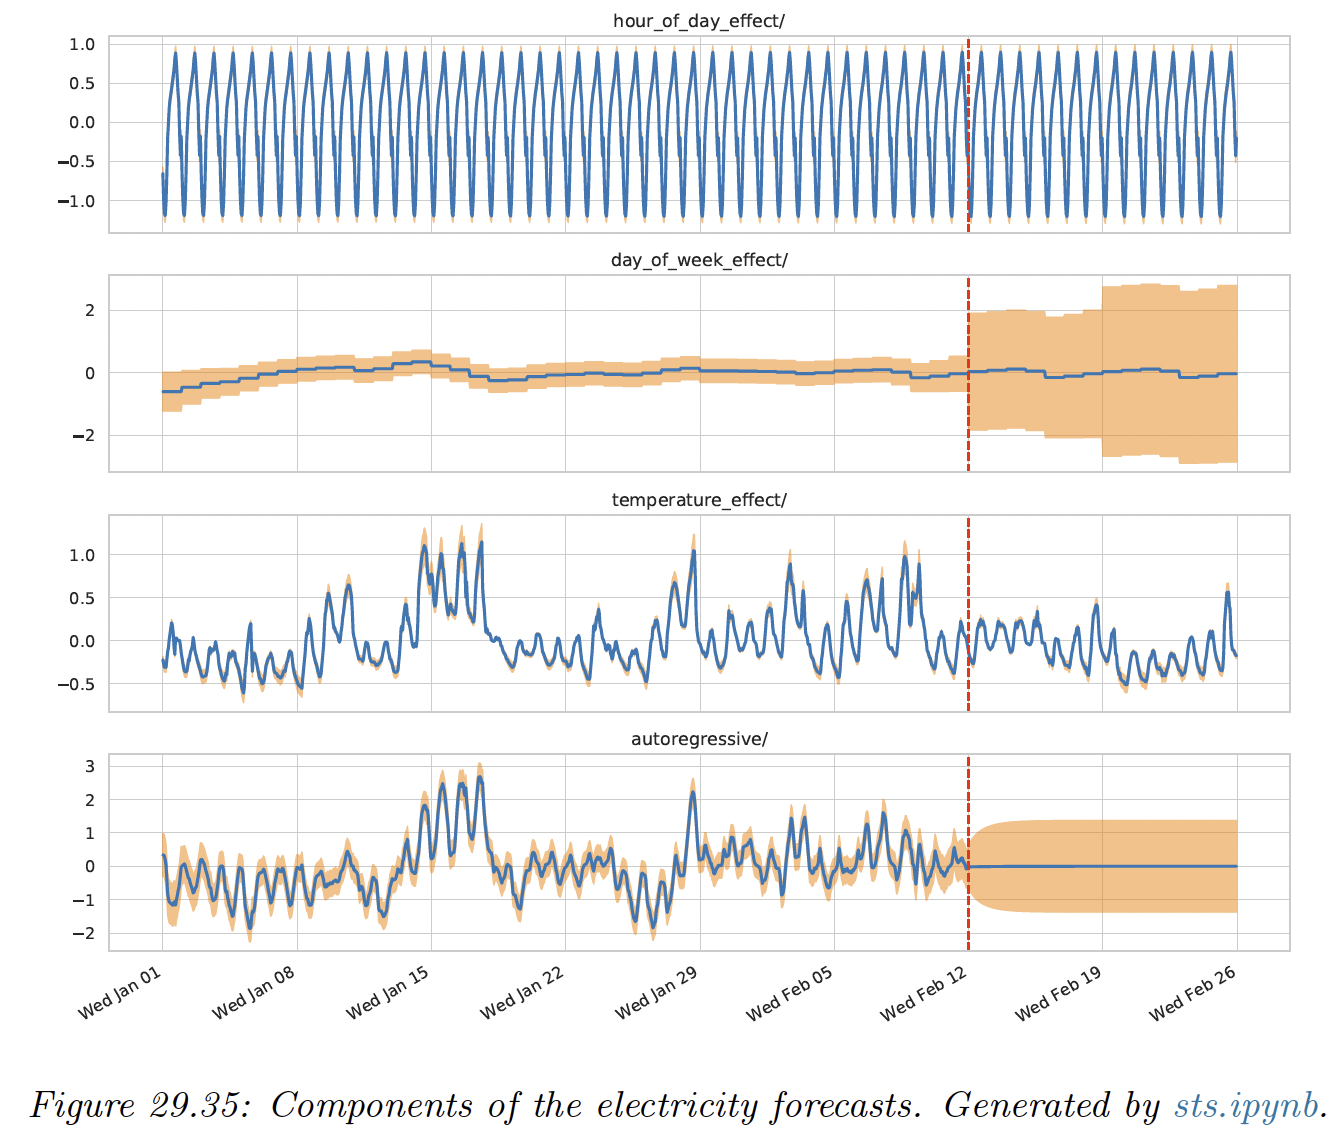
29.12 Structural Time Series Models 그냥 말 그대로 SSM 을 시계열에 대해서 적용시킨 것이 끝!
Specify Components for SSM Fit ParametersKalman Filtering 을 통해서 파라미터 구함. Kalman Smoothing 도 사용 가능!
29.13 Deep SSMs Dynamics & Observation Model 을 Non-linear 한 DNN 으로 가정하게 되는 SSM 을 Deep SSM 이라고 부른다.
애초에 Deep SSM 의 아이디어는 Posterior over Latent 를 구하는게 사실상 불가능하다고 말한다.
p ( z 1 : T ∣ x 1 : T ) = ∏ t = 1 T p ( z t ∣ z t − 1 , x 1 : T ) = ∏ t = 1 T p ( z t ∣ z t − 1 , ̸ x 1 : t − 1 , x t : T ) p\left(\boldsymbol{z}_{1: T} \mid \boldsymbol{x}_{1: T}\right)=\prod_{t=1}^T p\left(\boldsymbol{z}_t \mid \boldsymbol{z}_{t-1}, \boldsymbol{x}_{1: T}\right)=\prod_{t=1}^T p\left(\boldsymbol{z}_t \mid \boldsymbol{z}_{t-1}, \not{\boldsymbol{x}_{1: t-1}}, \boldsymbol{x}_{t: T}\right) p ( z 1 : T ∣ x 1 : T ) = t = 1 ∏ T p ( z t ∣ z t − 1 , x 1 : T ) = t = 1 ∏ T p ( z t ∣ z t − 1 , x 1 : t − 1 , x t : T ) 그렇기에 우리는 다른 분포 q q q
그럼 보통 어떻게 사용이 될까? q q q μ , Σ \mu, \Sigma μ , Σ
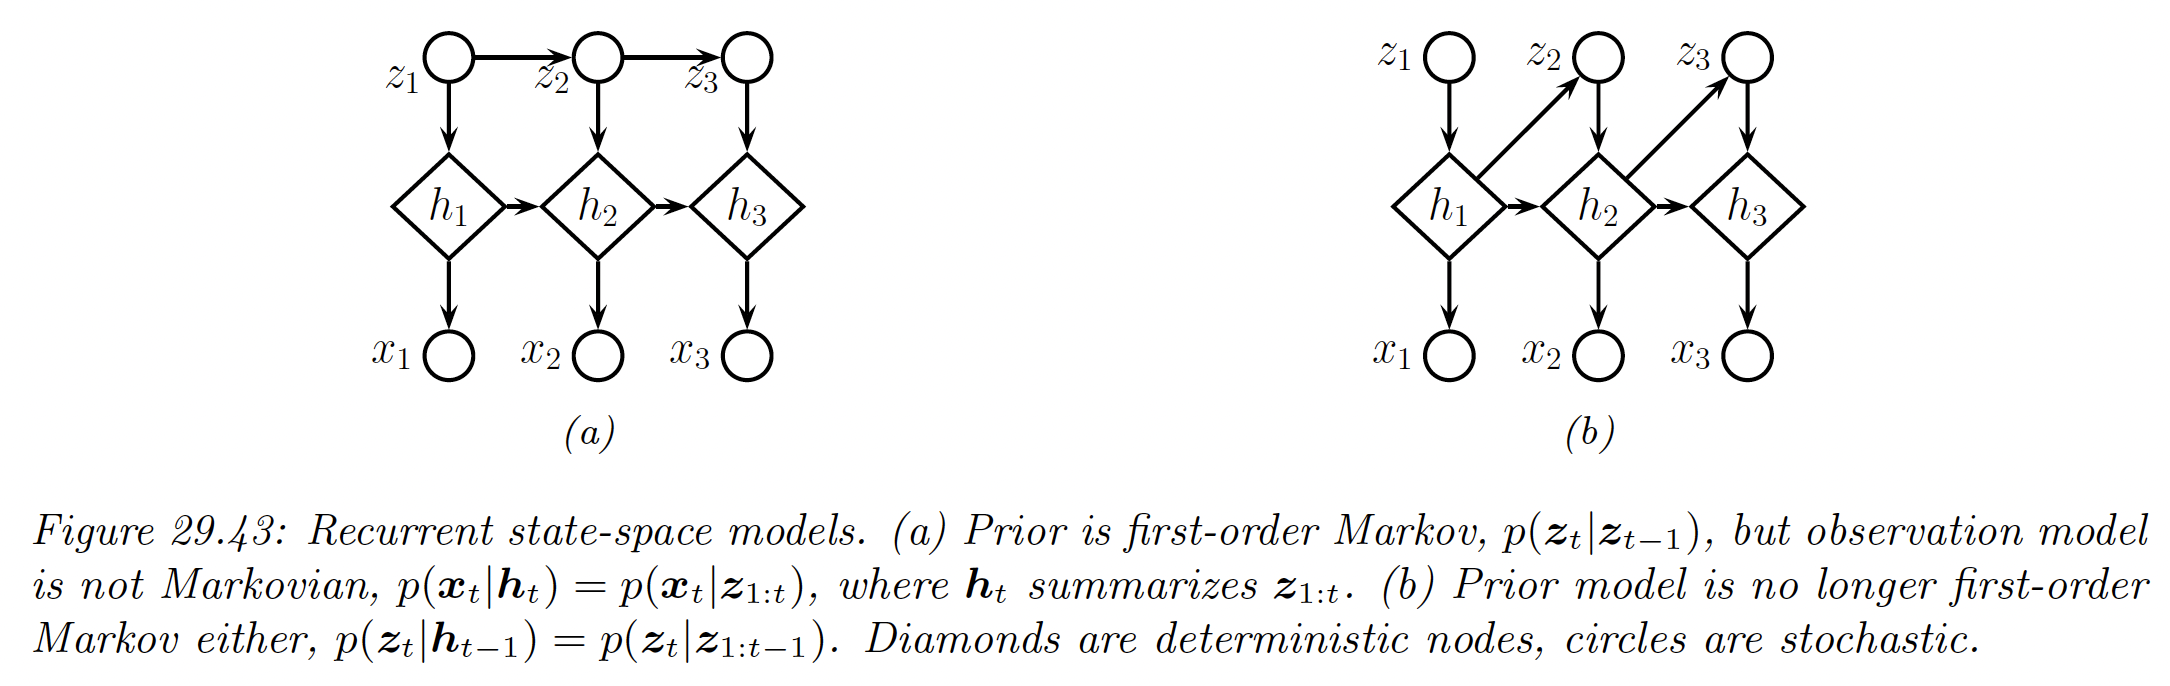
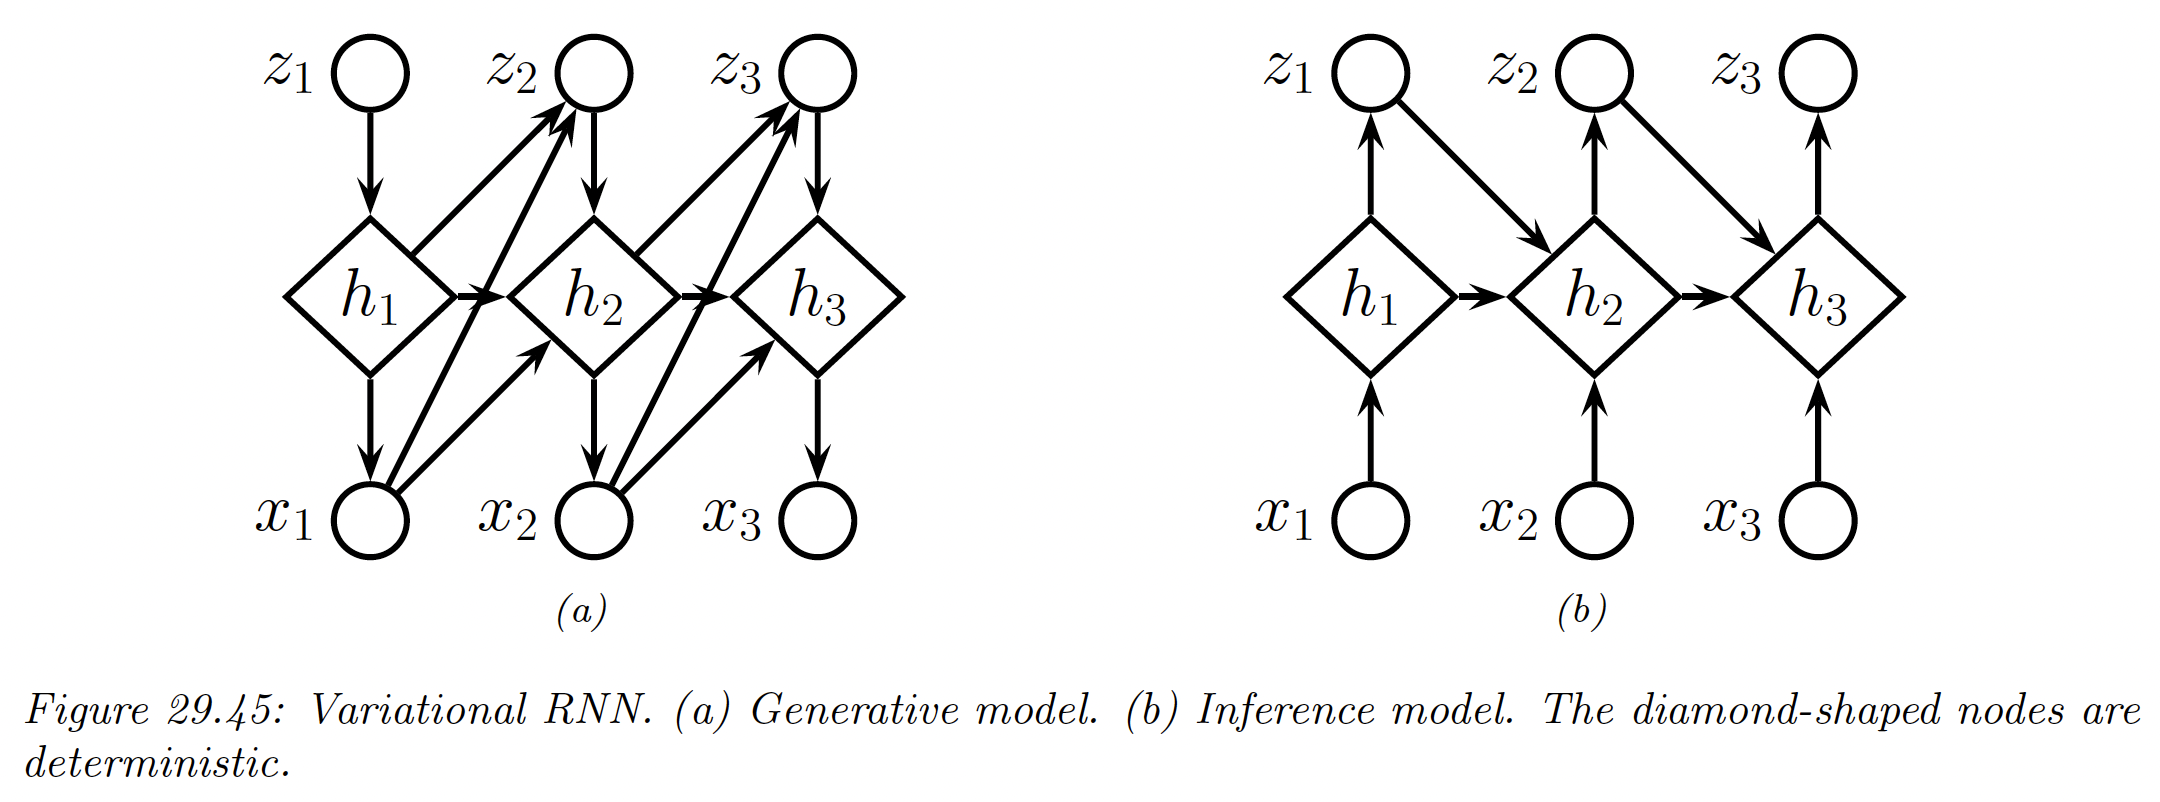
이것 이외에도 Recurrent SSM, Variational RNN 도 있지만 굳이 다루지는 않겠습니다.