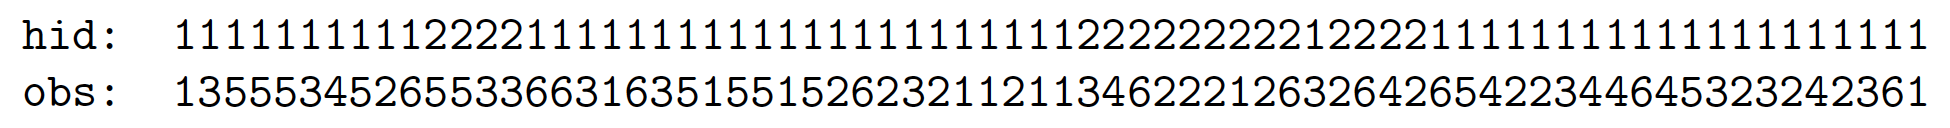9.5.4 - Computational Complexity of Exact Inference
9.5.5 - Drawbacks of VE
9.6 - The Junction Tree Algorithm (JTA)
9.7 - Inference as Optimization
9.7.1 - Inference as Backpropagation
9.7.2 - Perturb and MAP
9.1 Introduction
나아가기 전에, 이전 장들에서 다룬 중요한 Preliminaries 에 대해서 얘기해보겠습니다.
Probabilistic Graphical Model
이것은 확률 분포를 그래프 구조로 표현하는 모델입니다. 간단히 말하자면 Graphical Model 에서 Nodes & Edges 가 다음과 같으면 PGM 이라고 불립니다.
Nodes : 확률변수
Edges : 확률변수 (Nodes) 간의 의존관계 (Probabilistic Dependencies). 책에서의 4장에서는 Lack of Edges 를 Random Variables 간의 Conditional Independence Assumption 을 나타난다 함.
4장 Graphical Model 의 첫번째 부분. p.g 143
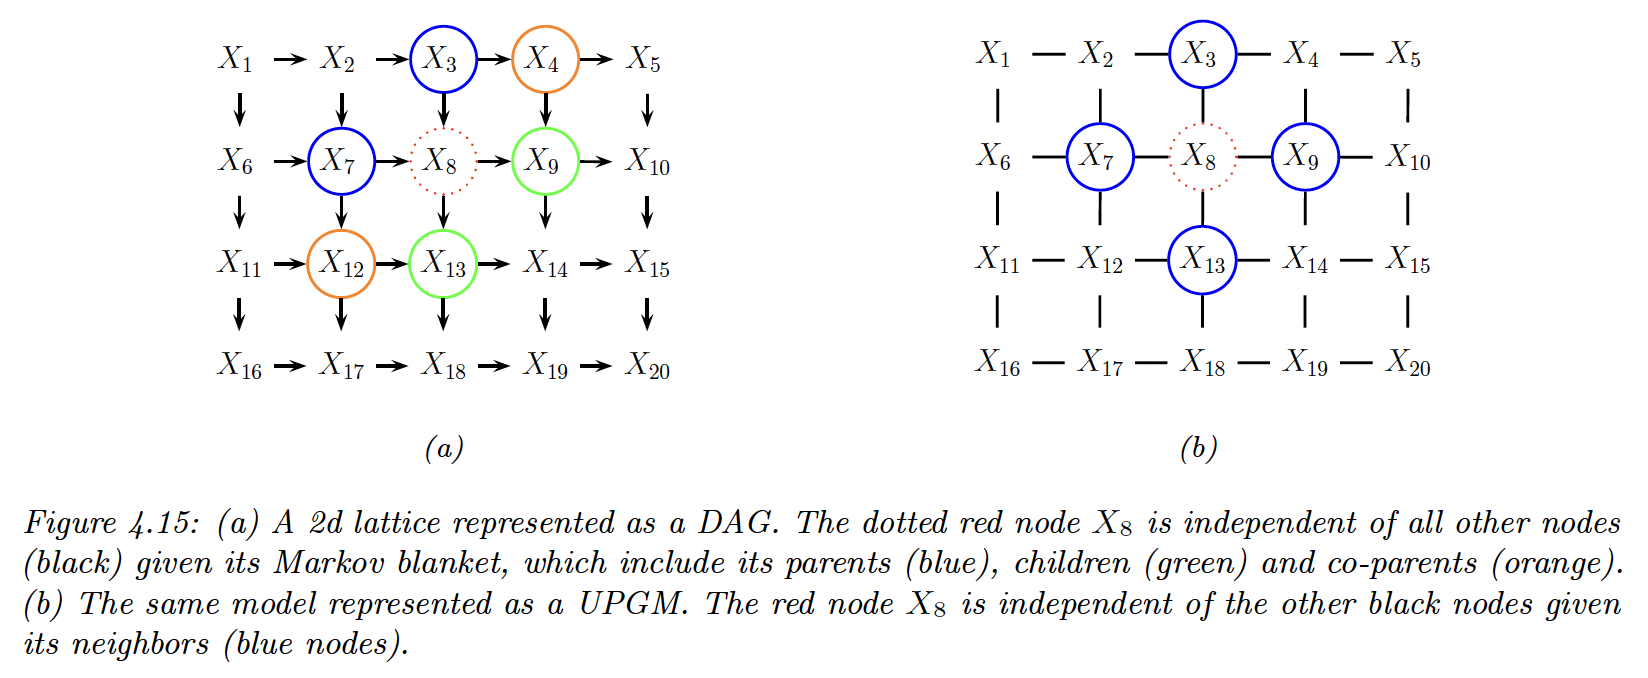
그러면 대략적으로 이해를 하자면 PGM 을 통해서 확률변수들을 그래프 구조로 시각화 해준다고 보시면 됩니다. 이때 그래프 구조에 따라서 다음과 같이 바뀝니다.
Directed PGM : Bayesian Network
Undirected PGM : Markov Random Field
Example PGMp.g. 146
왼쪽 : Bayesian Network 오른쪽 : Undirected PGM = Markov Random Field
9.2 Belief Propagation on Chains
9.2 에서는 다음을 만족하는 PGM 의 Inference 만 고려합니다.
Graph Structure 이 1D-Chain 이다.
그래프가 Directed 만 고려한다.
모든 Hidden Variable 이 Discrete 이라고 가정한다 (Continuous 는 8장 & 13장 에 다룬다고 합니다).
9.2.1 Hidden Markov Models (HMM)
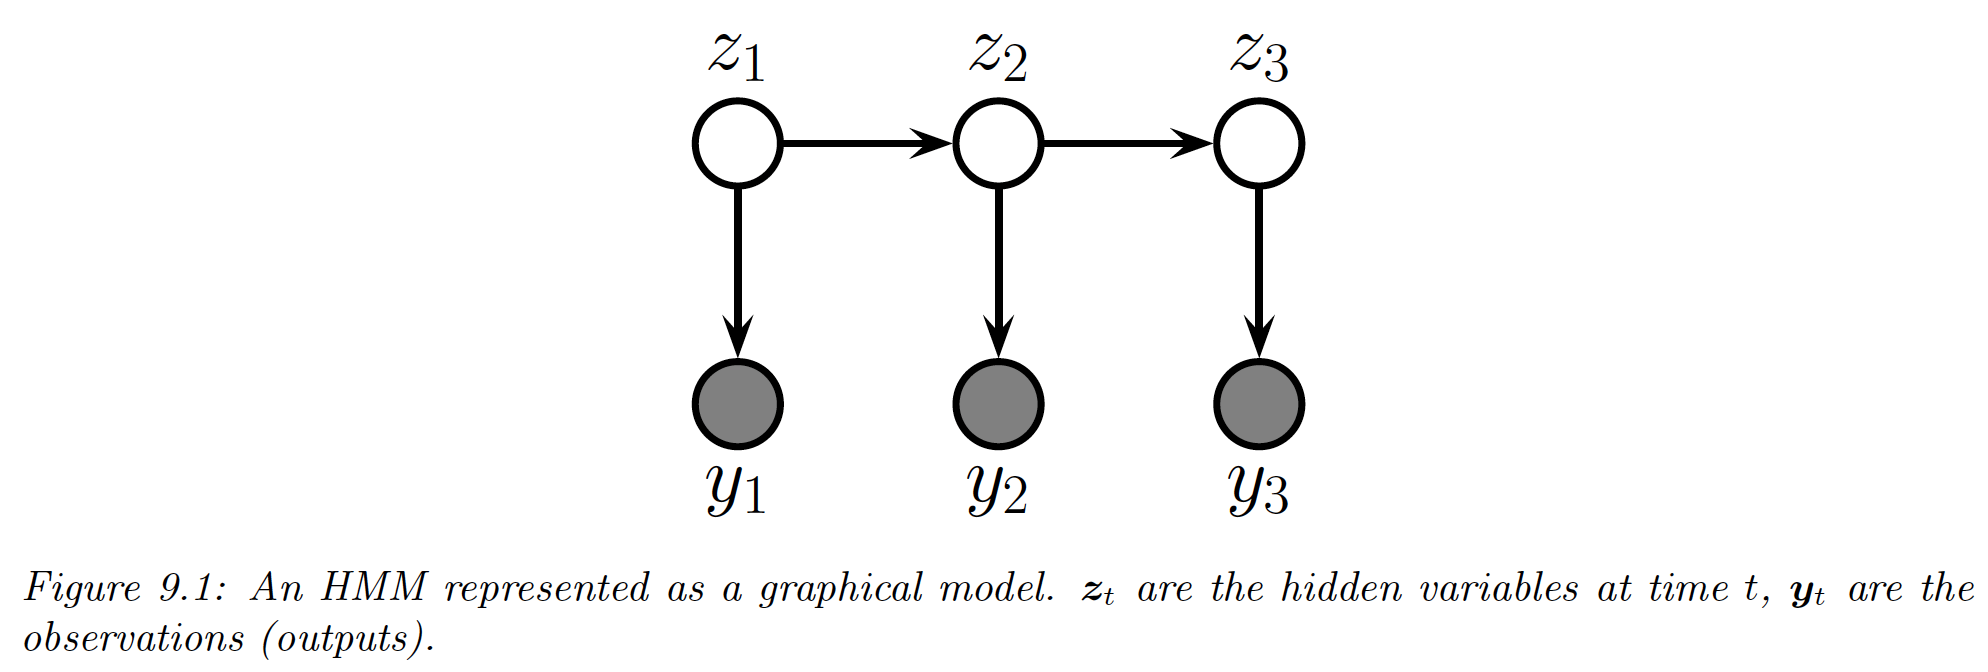
통계에서도 생각보다 많이 사용되는데요 (특히 스포츠 통계에서) 그냥 얼핏 봤을 때는 RNN 과 매우 유사한 형태입니다. 하지만 RNN 과는 다르게 Gate 개념이 전혀 없습니다.
위의 Figure 에 보이시는 바와 같이 Hidden Variable zt 들을 통해서 Output (Observation) yt 를 뱉는게 목표입니다. 이때 만약에 모든 Latent Variable 들이 Discrete 하다면, 위의 모델을 저희는 Hidden Markov Model (HMM) 이라고 부릅니다. 이것의 Joint Distribution p(y1:T,z1:T) 은 다음과 같습니다.
Hidden State 가 Continuous 인 상황을 고려하는 것이 SSM 이며 8장에서 다룬다고 합니다.
9.2.1.1 Example: Casino HMM
9.2.1 내내 이 예시를 가지고 놀기 때문에 확실히 짚고 넘어가도록 하겠습니다.
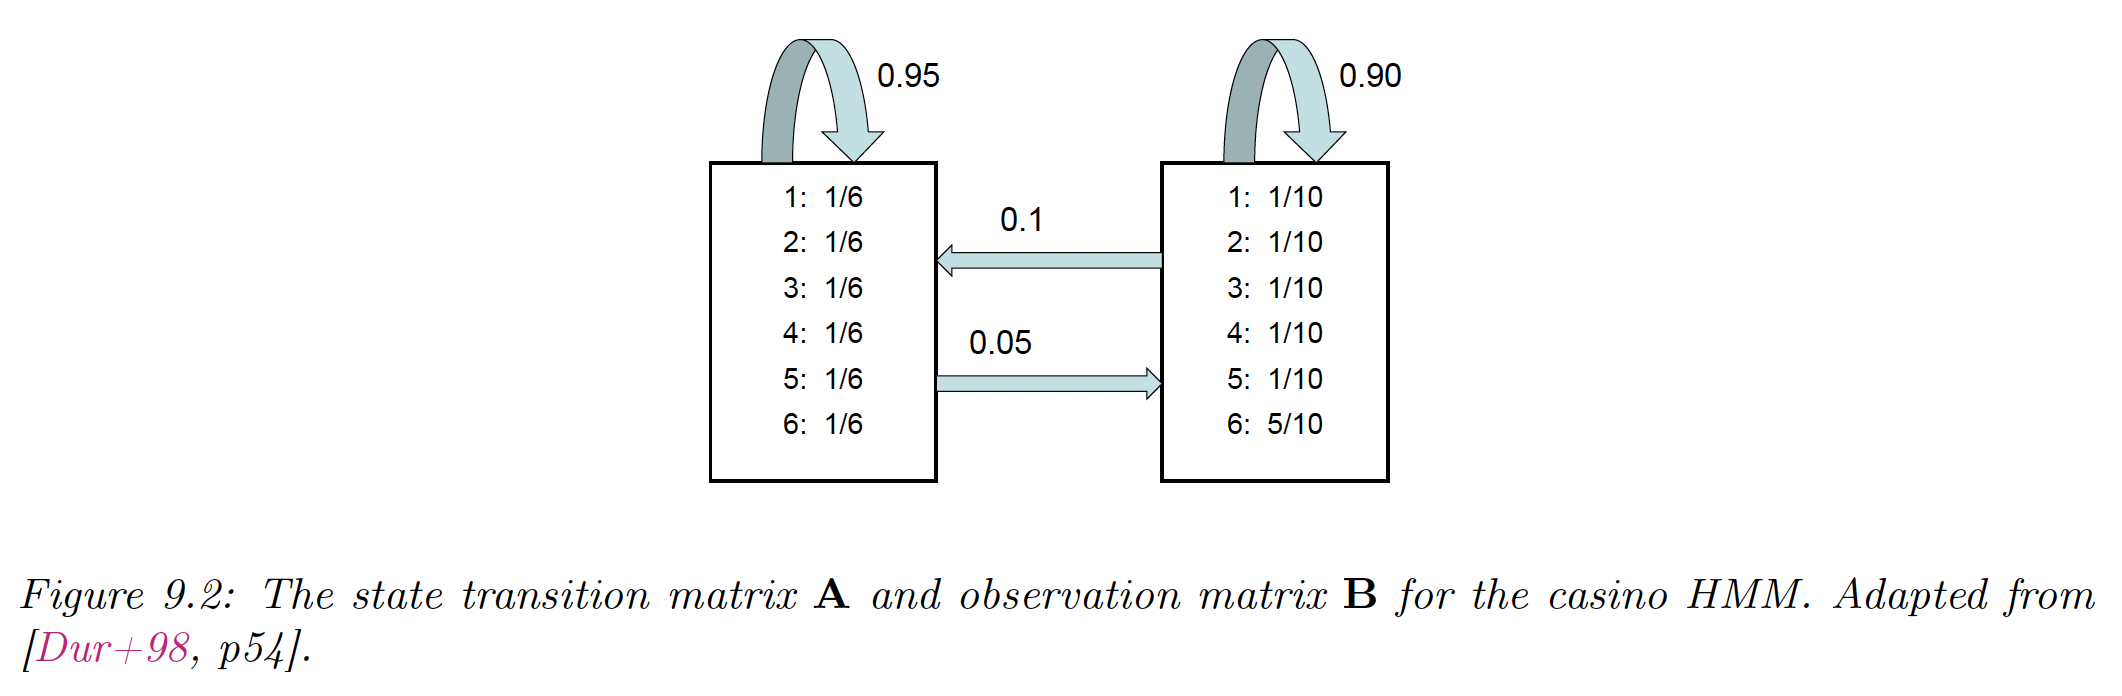
Occasionally Dishonest Casino 상황을 고려해보겠습니다. 카지노에서 주사위를 돌리고 있는데, 주사위 중 하나는 Fair Die 이지만 다른 하나는 Loaded (Unfair) Die 라고 가정하겠습니다. 이때 저희가 하고 싶은 것은 이 주사위가 Fair / Loaded 인지를 알고 이 점을 이용해서 미래에 대한 예측을 하는 것입니다.
그러면 정확한 상황을 다음과 같이 보여드리겠습니다.
보이시는 바와 같이, Fair Die 는 좌측과 같이 모든 숫자가 1/6 일 확률, Loaded Die 는 숫자 6 에만 5/10 인 주사위입니다. 우리가 돌리는 주사위가 어떤 시점에서는 Fair, 다른 시점에서는 Loaded 이며 주사위 자체를 Categorical Distribution 을 따르는 확률변수이라고 표현할 수 있습니다.
이때 시점 t 에 Fair 인지 Loaded 인지에 대한 확률은 이전 시점에 의해 결정이 되며, 이것이 바로 State Transition Probability 입니다. 이때 Notation 을 다음과 같이 정의하겠습니다.
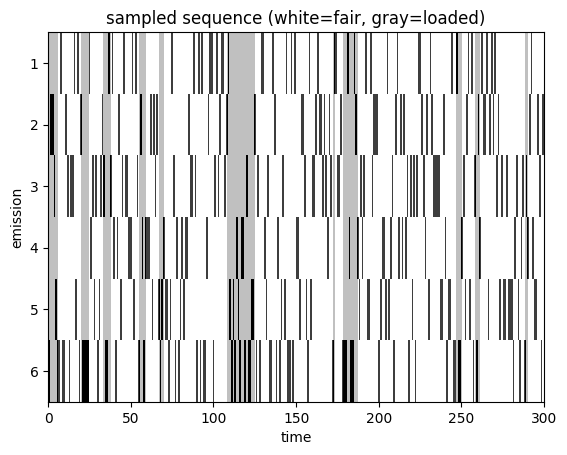
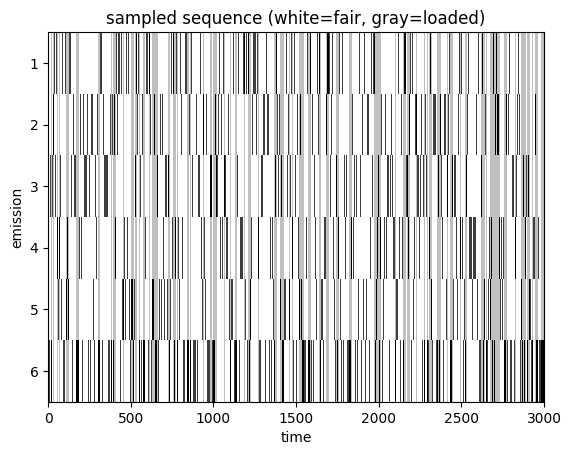
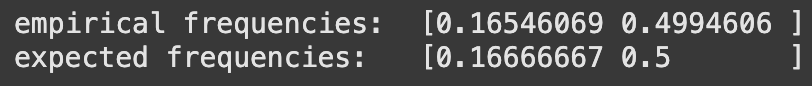
번외로 Ajk,Bkl 을 그림에 보이시는 값들로 채워주게 된다면 300,3000 번 돌렸을 때 결과가 다음과 같습니다.
300 번 돌렸을 때 :
3000 번 돌렸을 때 :
9.2.1.2 Posterior Inference
처음에 말씀드린 바와 같이, 저희의 궁극적인 목표는 Hidden State 들을 Infer 한 다음에 Outcome 을 예측하는 것입니다. 하지만 Outcome 을 Predict 하기 전에는 당연히 Hidden State 을 Infer 해줘야 합니다. 데이터 / Observation 을 이용해서 이를 Infer 해야되지만, Hidden State 에 대한 Posterior p(zt∣y1:T) 도 구해야 합니다.
그럼 왜 하필 Hidden State 에 대한 Posterior 를 구해야할까요?
저희는 사실 이 주사위가 Fair Die 인지 Loaded Die 인지 모르는 상태입니다. 다시 말하자면 현재 Hidden State 이 무엇인지 모른다는 얘기입니다. 아무리 관측 값들이 있다고 하더라도 이것은 모른다는 얘기죠.
그래도 관측 값들을 이용해서 모델링을 해줘서 미래 Outcome 에 대해서 예측을 해야겠죠? 그러기 위해서는 모델링을 해줘야 합니다. 즉 아 주사위는 두 개의 State 가 있고 각각의 주사위는 6가지 중 하나를 뱉는다는 세팅을 만들어준다 이라는 모델을 구축해야하며, 이것을 Posterior 으로 표현했을 뿐인 것입니다.
그렇다면 만약에 우리의 믿음으로는 주사위 종류가 Fair / Loaded 밖에 없다고 생각해서 모델링을 관측 값들에 의해서 그렇게 구성했지만, 실제로 관측 값들은 Fair / Loaded 1 / Loaded 2 으로 만들어진다면 어떻게 될까요? → 당연하게도 추론 (Inference) 가 왜곡이 됩니다. 한 마디로 잘못된 Belief 가 생기며 이럴 때는 다르게 세팅하거나 Non-Parametric 모델도 고려해볼 수가 있습니다.
여기에서 정의를 몇개 해주는데, 그거에 대한 설명입니다.
Smoothing Distributionp(zt∣y1:T) : 모델의 모든 Hidden 노드들에 대한 Posterior.
Filtering Distribution / Belief Statep(zt=j∣y1:t) (근데 정확하게는 =j 가 없어도 되긴 하다) : 현시점 + 현시점의 이전 시점들의 관측값들이 주어진 상태에서 현 시점 t 의 Hidden 노드에 대한 확률. 이것을
그러면 Casino 상황에서의 Smoothing Distribution 은 다음과 같이 나오게 됩니다.
Hidden Node 에 대한 Posterior 인 Smoothing Distribution 을 구축했으니 이제는 다음을 할 것입니다.
Forwards in Time (앞에서 시작하는 것) 으로 가면서 Belief State p(zt=j∣y1:t) 를 구하는 것.
Backwards in Time (뒤에서 시작하는 것) 으로 가면서 p(yt+1:T∣zt=j) 를 구하는 것.
두 개를 합쳐서 Smoothing Distribution 을 구해주기.
1번과 2번 Passes 가 둘다 (TK2) 만큼의 시간이 걸린다고 한다. K : # of Discrete Hidden States (2).
번외
Filtering Distribution 과 Belief State 는 사실상 똑같은데, Robotics 에서 후자 텀을 사용한다고 한다.
9.2.2 The Forwards Algorithm
넘어가기 앞서서 잠시 TMI 를 하자면, Bayes Filter 이란 것은 p(zt∣y1:t) 를 구하기 위해서 Prior Belief p(zt−1∣y1:t−1) 과 새로운 관측인 yt 그리고 모델을 이용하는 알고리즘이라고 하며 8.1.2 에서 배운다고 한다. HMM 관점에서는 이 알고리즘을 그저 Forwards Algorithm 이라고 부른다.
HMM 은 Latent State zt 가 Discrete 합니다. 그렇기에 정의를 다음과 같이 하겠습니다.
Normalization Constant 의 경우 그저 Marginalization for Discrete Case 를 생각해보면 됩니다. 어차피 저희가 지금 궁금한 것은 “zt 가 어떤 State 에 있을까?” 에 대해서이기 때문에 zt 가 없는 확률에 대해서는 신경을 안 써도 됩니다.
Update Step 의 경우 그러면 다음과 같은 Matrix-Vector Notation 으로 표현해줄 수 있습니다.
αt=normalize(λt⊙(A⊤αt−1))
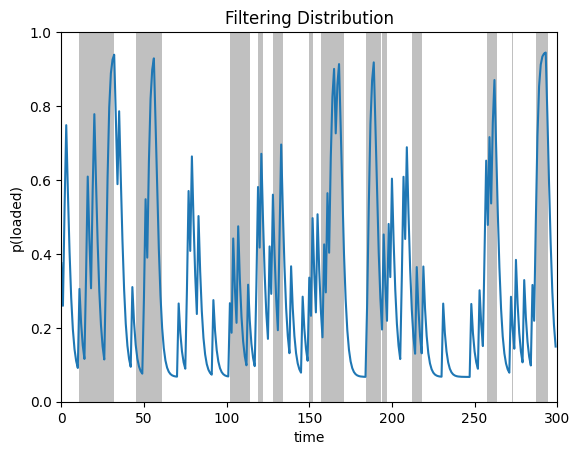
이것에 대해서 실제로 Dishonest Casino 에 적용을 시켜보았을 때 다음과 같이 결과가 나왔다고 합니다.
교재에 포함된 Figure
코드로 돌려본 결과
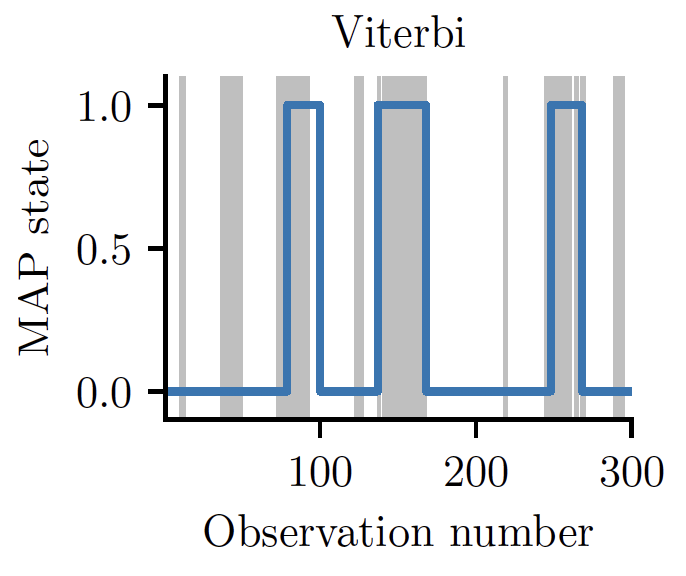
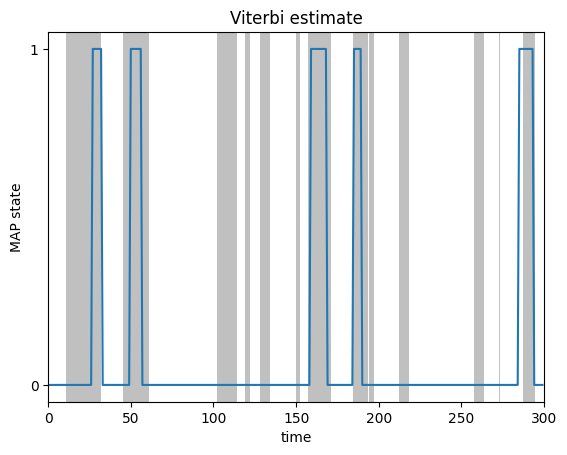
회색 부분들이 Loaded, 흰색 부분들이 Fair 이며 y-축은 p(loaded) 입니다. 정확하지는 않지만 대략적으로 잘 맞추는 모습을 보이고 있지만, Smooth 하지 않다는 것을 알 수가 있습니다.
9.2.3 The Forwards-Backwards Algorithm
여기에서는 HMM 에서 Smoothing 하기 위해서 가장 많이 사용되는 방법인 Forward-Backward / FB Algorithm 에 대해서 설명합니다.
Forward Pass 에서 저희는 αt(j)=p(zt=j∣y1:t) 에 대해서 구했습니다. 하지만 Backward Pass 에서는 9.2.1 에서도 설명했듯이 다음을 구하는게 목적입니다.
이것도 비슷하게 Matrix-Vector Form 으로 다음과 같이 표현해줄 수 있습니다.
βt−1=A(λt⊙βt)
Base Case 인 t=T 일 때의 경우는 다음과 같습니다.
βT(i)=p(yT+1:T∣zT=i)=p(∅∣zT=i)=1
번외
βt 는 사실 엄밀히 따지자면 State 에 대한 확률분포는 아닙니다. 왜냐하면 ∑jβt(j)=1 을 만족할 필요가 없기 때문입니다.
j∑βt(j)=j∑p(yt+1:T∣zt=j)
하지만 그래도 Normalize 을 시킨다고 하며, 이는 Underflow 방지 때문이라고 합니다.
9.2.3.2 Example
Forward-Backwards Algorithm 을 Dishonest Casino 에 구현해본 결과는 다음과 같습니다.
교재에서 나온 결과
코드에서 돌려본 결과
9.2.3.3 Two-slice Smoothed Marginals
다시 또 정리를 하자면, Notation 은 다음과 같습니다.
αt(j)=p(zt=j∣y1:t)
αt∣t−1(j)=p(zt=j∣y1:t−1)
βt+1(j)=p(yt+2:T∣zt+1=j)
γt(j)∝p(zt=j,yt+1:T∣y1:t)=αt(j)βt(j)
λt(j)=p(yt∣zt=j)
Ai,j=p(zt=j∣zt−1=i), (그림에서의 Notation 은 조금 다른 듯 합니다)
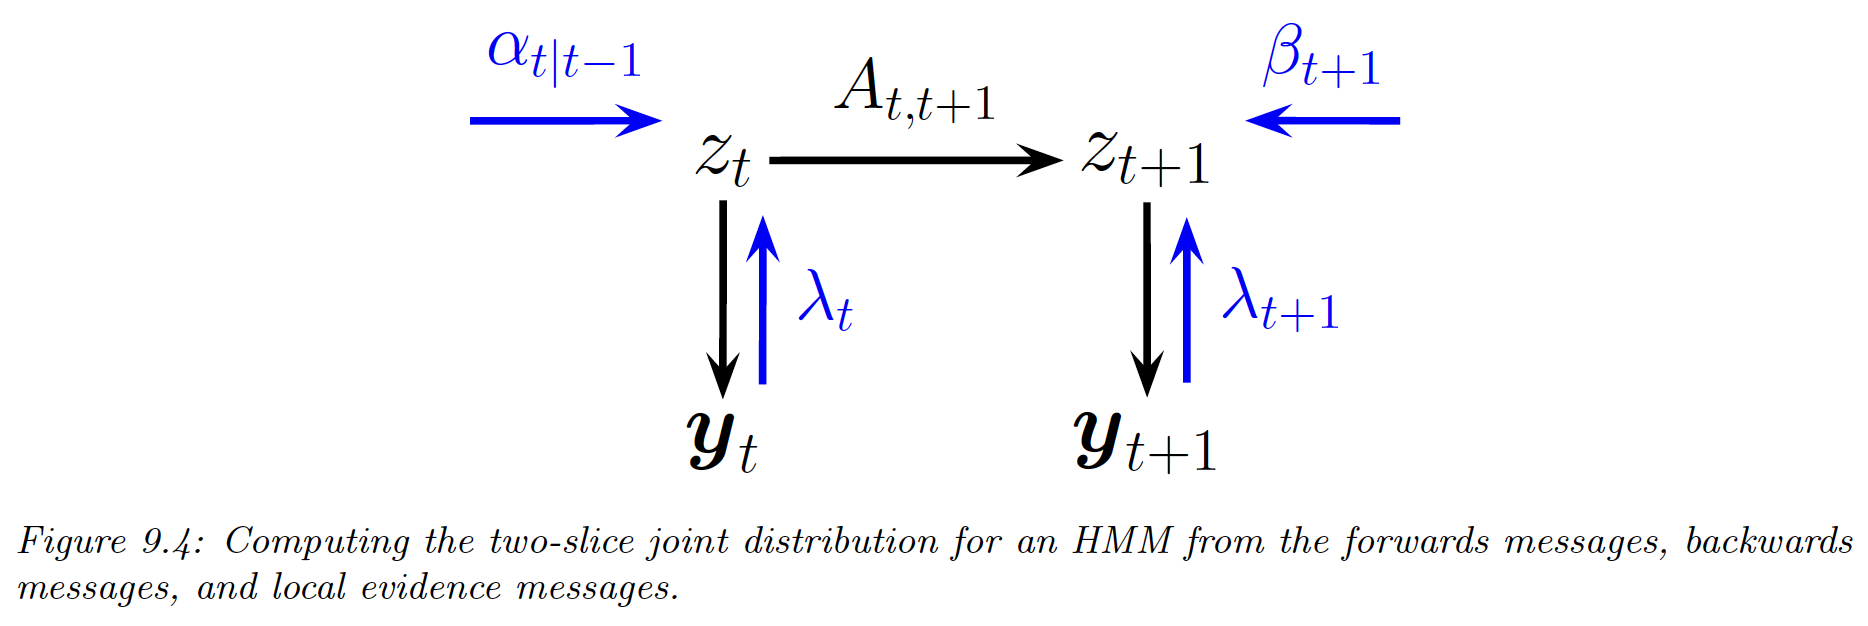
Two-slice Joint Distribution p(zt,zt+1∣y1:T) 을 구하기 위한 과정을 그림 표현하면 다음과 같습니다.
파랑색 선들이 zt 에 대한 분포를 알기 위해서 필요한 정보 (Message) 이라고 보시면 될 것 같습니다. 이때의 Message 종류는 Forward Message αt∣t−1, Backward Message βt+1, 그리고 Local Evidence Message λt 들입니다. 위의 Two-slice Marginal 인 p(zt,zt+1∣y1:T) 를 구하기 위해서 다음과 같이 전개시킬 수 있습니다.
대부분의 HMM 관련 논문들은 Unnormalized Joint Probability 를 사용합니다 (αt′(j)=p(zt=j,y1:t)). 하지만 저희는 Forward Message 를 Normalized Conditional Probability 를 사용하며 (αt(j)=p(zt=j∣y1:t)), 이에 대한 이유는 다음과 같습니다.
Numerical Underflow 유도, Joint 확률 자체가 작기에.
해석하기도 더 어렵다. State 에 대한 정확한 분포이기에.
알고리즘 적으로는 사실 normalize 를 사용하냐 안하냐 차이 이긴 하지만, 그래도 Normalized 버전을 사용하는 것이 훨씬 구현하기도 쉽기에 교재에서 강조하고 싶다고 합니다.
9.2.4 Forwards Filtering Backwards Smoothing
앞서 말씀드린 Forwards Backwards Algorithm 와는 달리 Smoothing 시키는 방법이 또 있으며, 이는 Forwards Filtering 과 Backwards Filtering 을 사용하는 것이며, 이 방법은 연속적인 Latent State 가 있는 SSM 들이 자주 사용하는 방법이라고 합니다.
실제로 구현을 하면 O(K2T) 만큼 필요하며, 이는 매 시점마다 Forward + Backward 둘다 State j 에 대해서 Summation (시그마 텀) 과 모든 State j 에 대해서 Compute 를 해야하기 때문입니다. K 가 매우 크다면 이게 문제가 되지만, Transition Matrix 가 Sparse 하다면 줄일 수 있게 됩니다.
예시로 만약에 Transition Matrix 가 Ai,j∝ρ(zj−zi) 의 관계를 만족하며 ρ(⋅) 이 어떠한 Scalar Cost function 이면, 우리가 구해야 되는 식 중 하나인 αt∣t−1(j) 를 다음과 같이 Convolution 형태로 연산시켜주면 됩니다.
가끔씩은 Likelihood 값이 똑같을 때가 있습니다. 이것은 특히 Speech Recognition 에서 많이 보인다고 하는데요, 이것은 그저 시점 t 에서 Top-N 개를 저장시켜준 다음에 다음 시점들에 대해서 이 값들을 비교하면서 가장 좋은 Path 를 Rerank 시켜주면 됩니다.
9.2.7 Forwards Filtering Backwards Sampling
Forwards Filtering Backwards Smoothing 알고리즘에서는 Marginal 을 구했었는데, 이렇게 하기 보다는 Posterior 에서 여러 Path 들을 샘플링을 우선적으로 하는게 효과적입니다. 이것을 바로 Forwards Filtering Backwards Sampling 이라고 불리며, Backwards Pass 에서의 Joint 를 다음과 같이 적을 수 있습니다.
그러면 Step t 에서 Product 에서의 뒷텀인 p(zt∣zt+1,y1:T) 에서 zts 를 샘플링 해주면 됩니다.
9.3 Belief Propagation on Trees
저희가 배웠던 Forwards-Backwards Algorithm 의 경우 Chain 구조의 Graphical Model 에서 Message Passing Algorithm 으로 사용될 수 있으며, 이번 장에서는 그 알고리즘들이 Tree 와도 상호작용이 가능하게끔 만들어줍니다.
9.3.1 Directed vs Undirected Trees
Pairwise Undirected Graphical Model 을 다음과 같이 고려해볼 수 있습니다.
즉 Tree 는 Undirected / Directed Graph 으로 표현이 가능합니다.
9.3.2 Sum-Product Algorithm
Undirected Tree 라고 가정하며 임의의 노드를 Root 으로 그리고 이 노드로부터 아래로 퍼지는 모든 Edge 들을 고려해볼 겁니다. 그렇게 된다면 모든 노드들이 Unique 한 Parent 를 가지게 됩니다. (Directed Tree 의 경우에는 다양한 Node Ordering 을 고려할 수 있습니다.)
그러면 p∗(z) 에 대해서 구하기 이전에 Order 에 대해서 설명하겠습니다. Root 가 맨 좌측에서 시작해서 Left Subtree, Right Subtree 으로 간다고 가정하겠습니다.
Pre-order : Root → Left Sub-tree → Right Sub-tree, Root → Leaves
Post-order : Right Sub-tree → Left Sub-tree → Root, Leaves → Root
그러면 Post-Order 부터 진행하겠습니다.
Post-Order (Generalization of Forwards Pass)
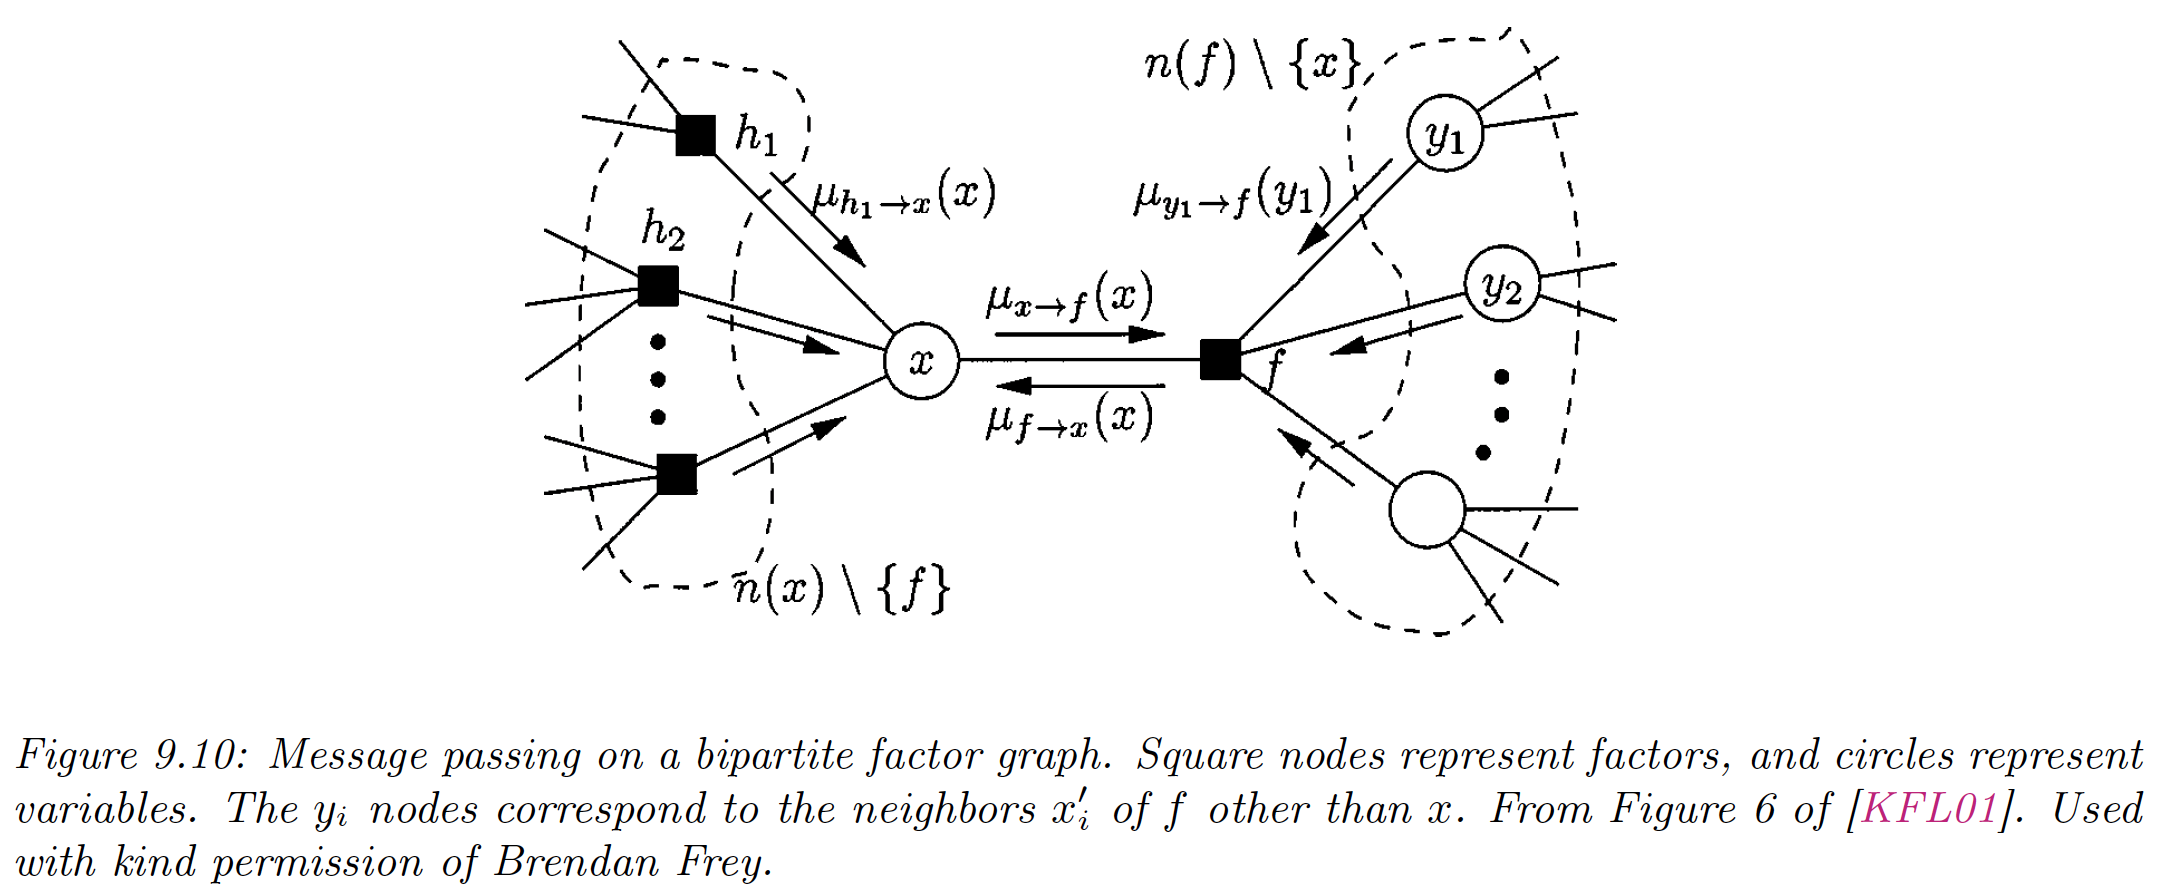
ms→t(zt) : Node s 에서 Node t 으로 가는 Message, 즉 s−t Edge 밑에 있는 모든 Evidence 가 주어진 상태에서 zt 에 대한 Belief State 를 요약해준다.
bels(zs)∝p(zs∣All Observations Known)
chs : Set of Children Nodes of Node s.
그러면 Belief State 을 업데이트 할 때는 다음을 구해주면 됩니다.
bels(zs)∝ψs(zs)t∈chs∏mt→s(zs)
밑에서 시작하는 것이기 때문에 s=bottom 이면 Children 이 없기에 ∏t∈chsmt→s(zs)=1 이 됩니다.
이것을 구한 다음에는 노드 s 의 Parent 를 t 라고 하며 Parent t 에게 보낼 메시지를 다음과 같이 구해줍니다.
ms→t(zt)=zs∑ψst(zs,zt)bels(zs)
저희가 zs 에 대해서 Marginalize 시켜야하는 이유는 바로 Node s 가 가질 수 있는 모든 State zs 에 대해서 Marginalize 시키고 난 다음에 zt 에 대한 함수로 표현하기 위함입니다.
Root 까지 도달하면 Belief State belt(zt)=p(zt∣y) 는 모든 Evidence 를 본 상태입니다. 이 상태에서 다시 Root 에서 아래로, 즉 Pre-Order 를 진행시키면 됩니다.
Pre-Order
노드 s 가 Child t 에게 보내는 메시지는 s 가 t 이외의 Child Node 에게 받은 메시지를 내포하고 있어야 합니다. 그렇기에 다음과 같이 구성이 됩니다. 아래 식과 같이 모두 연산하기 보다는 Post-Order 에서 구한 것을 활용하면 연산량이 훨씬 적어집니다.
Sum-Product Algorithm 의 경우 결국에는 다음과 같은 Posterior Marginal 을 구했습니다.
beli(k)=γi(k)=p(zi=k∣y)=z−i∑p(zi=k,z−i∣y)
이때 우측 Term 의 Summation 을 max 으로 바꿔주기만 하면 Max-Product Belief Propagation 이 됩니다. 그러면 다음과 같이 구할 수 있게 됩니다.
ζi(k)=z−imaxp(zi=k,z−i∣y)
일종의 Viterbi Algorithm 이라고 생각하면 편합니다. 이때 2 가지 MAP 와 비슷한 Estimate 을 구할 수 있다고 하며, 이는 다음과 같습니다.
Maximizer of Posterior Marginal (MPM) : z^i=argmaxkγi(k)
Maximizer of the Max Marginal (MMM) : z~i=argmaxkζi(k)
너무 중요하지 않은 것 같으니 넘어가도록 하겠습니다.
9.4 Loopy Belief Propagation (LBP)
여태까지는 Loop 없이 Belief Propagation 을 했었지만, 이제부터는 Loop 가 있다면 어떻게 진행할지에 대해서 알아봅니다. 처음에는 Belief Propagation 을 진행하는 경우 수렴을 못할 수도 있기에 불가능하다고 하지만, 다양한 그래프 모델들에 Empirically 적용할 때 가능하다고 하며 특정 케이스에서의 이론도 존재한다고 합니다.
9.4.1 Loopy BP for Pairwise Undirected Graphs
우선은 그래프가 Tree 라는 형태를 띄운다는 가정을 버립니다. 노드들에 대한 자연스러운 Ordering 이 없기 때문입니다.
기본적인 아이디어는 모든 Belief 들을 한꺼번에 그리고 병렬적으로 업데이트 시켜준 다음에 Message 들을 한꺼번에 그리고 병렬적으로 업데이트 시켜주는 것입니다. 이러한 아키텍쳐를 systolic array 이라고 부릅니다.
(초깃값은 모든 메시지를 1-벡터인 상태) 병렬적으로 모든 노드들의 Belief 를 다음과 같이 업데이트 시켜줍니다. (nbrs : Node s 의 Neighboring Set)
bels(zs)∝ψs(zs)t∈nbrs∏mt→s(zs)
병렬적으로 모든 노드가 Neighbor 들에게 보내주는 메시지를 다음과 같이 업데이트 시켜줍니다.
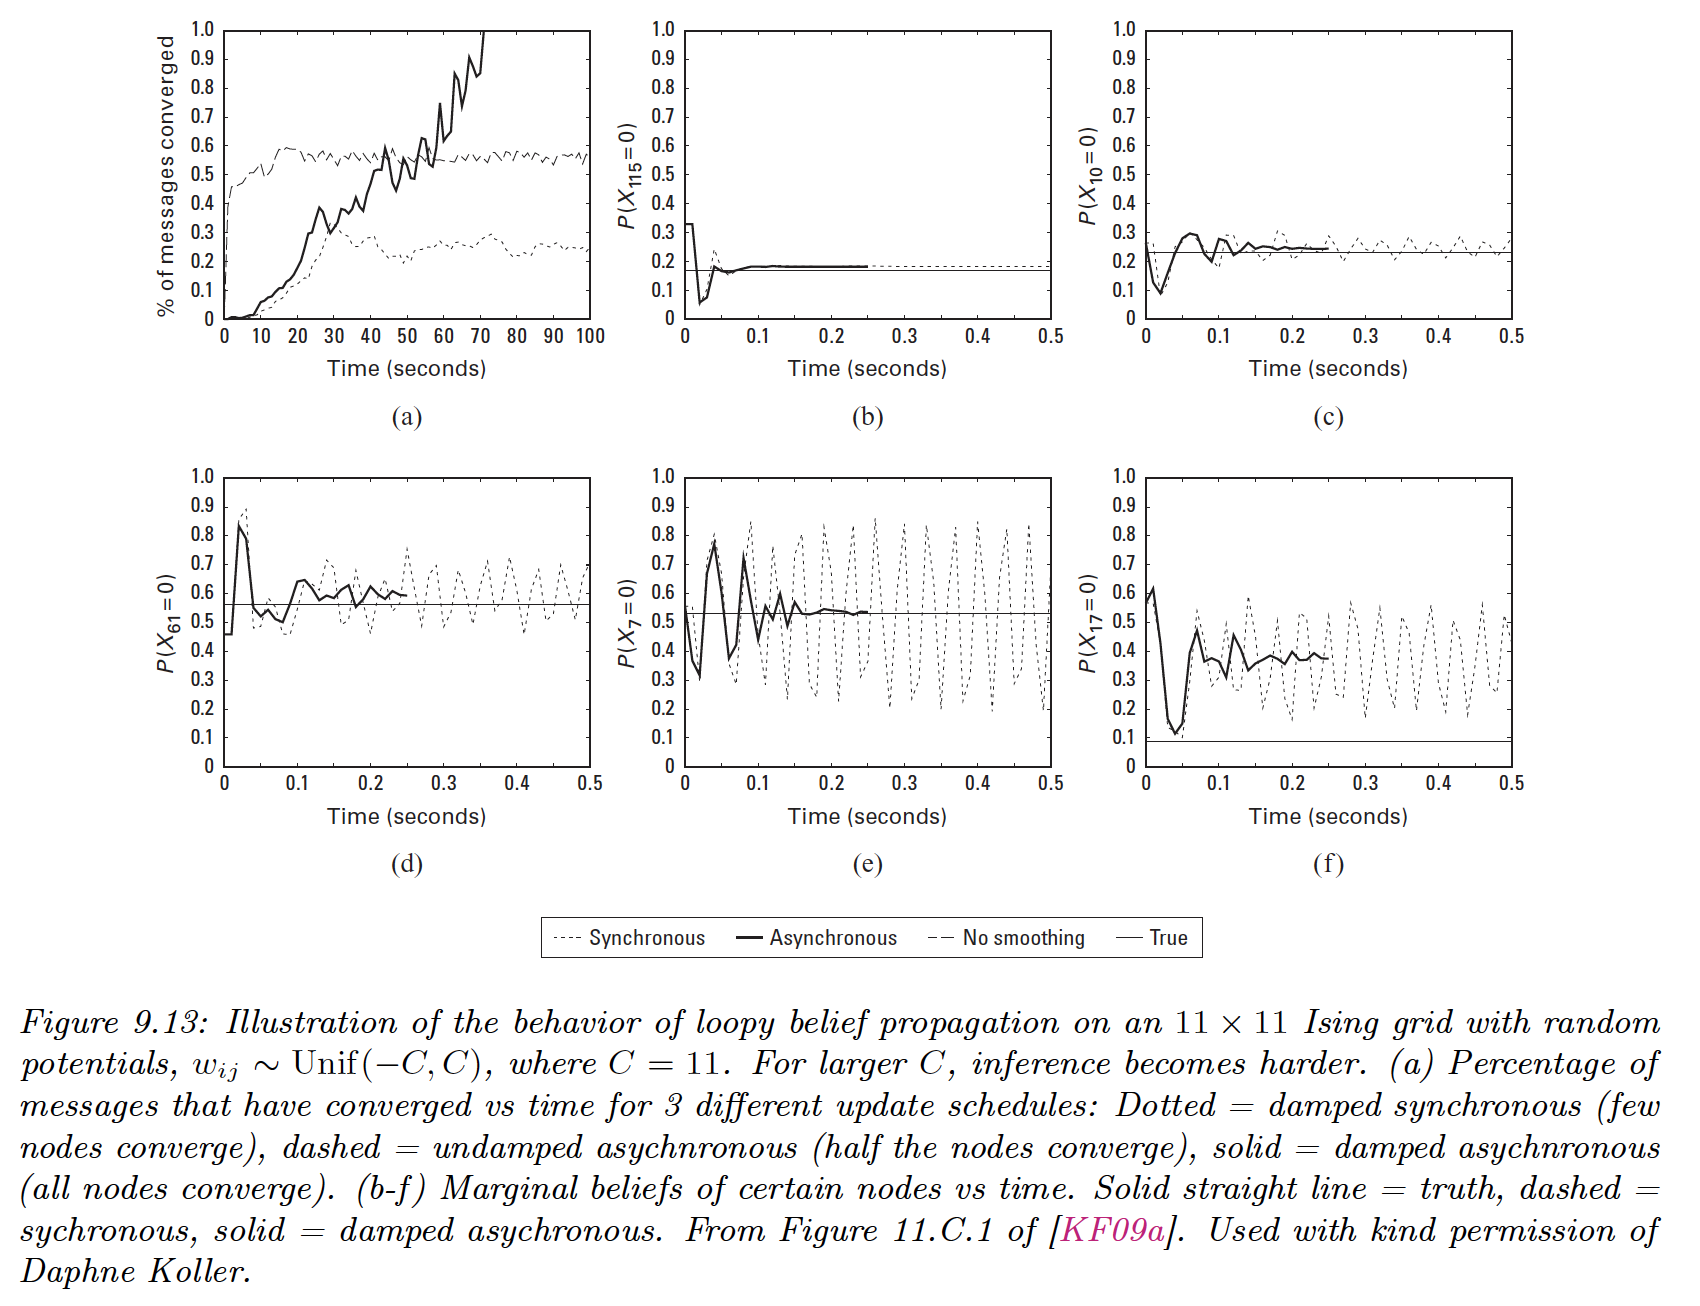
Loopy BP 의 경우 수렴을 안하거나 굉장히 느리게 수렴할 수도 있습니다. 그렇기에 수렴성의 확률을 높이거나 수렴 속도를 키우는 방법들에 대해서 다룬다고 합니다.
9.4.4.1 When will LBP Converge?
보통 이런 분석을 할 때는 Computation Tree 를 사용한다고 하며, 정확한 디테일은 Out-of-Scope 이라고 합니다. 예시로는 아래와 같습니다.
여기서의 핵심은 Loopy Graph 에서 T Iterations 은 Computation Tree 에서의 T+1 Iterations 과 같다는 것입니다. Edge 들에 대한 Connection 이 약하다면 수렴성이 나타날 것입니다.
9.4.4.2 Making LBP Converge
LBP 가 수렴을 안하게 된다면 수렴할 확률을 올리기 위해서 다양한 방법들이 있으며, 그 중 간단한 것은 바로 Damping 입니다.
Iteration k 때, 메시지 업데이트를 다음과 같은 형태로 사용합니다.
mt→sk(xs)=λmt→s(xs)+(1−λ)mt→sk−1(xs)
λ=1 : Standard Message Update
λ<1 : Partial Update from Previous Iteration
이렇게 진행하면 결과가 예시로 다음과 같습니다.
Double Loop 알고리즘도 있다고는 하지만, 느리고 복잡해서 별로라고 합니다.
9.4.4.3 Increasing the Convergence Rate with Adaptive Scheduling
보통은 LBP 를 다음과 같이 한꺼번에 업데이트를 합니다.
m1:Ek+1=(f1(mk),…,fE(mk))
fi(m) : Edge i 에 대한 메시지 함수.
그렇다면 이것을 Asynchronous 하게 업데이트를 시키게 된다면 더 빠르게 업데이트를 한다고 합니다.
mik+1=fi({mjk+1:j<i},{mjk:j>i})
그러면 이때 올 수 잇는 질문이 어떤 순서로 메시지를 업데이트를 시키는 것이며, 이는 간단하게 고정적인 순서, 랜덤 순서 등이 있겠지만 가장 Uncertain 한 애들을 업데이트 시켜주는 것입니다.
위의 결과에서 Asynchronous 부분에 이 결과가 있습니다.
9.4.5 Accuracy
Max-Product of LBP 는 Single Loop 그래프에서 정확한 MAP Estimate 을 구하는게 가능하다.
이론적으로 Error 를 Bound 시키는 것이 가능하다.
Gaussian 모델에서는 더 정확한데, 이때 분산은 또 아예 모른다고 한다.
9.4.6 Generalized Belief Propagation
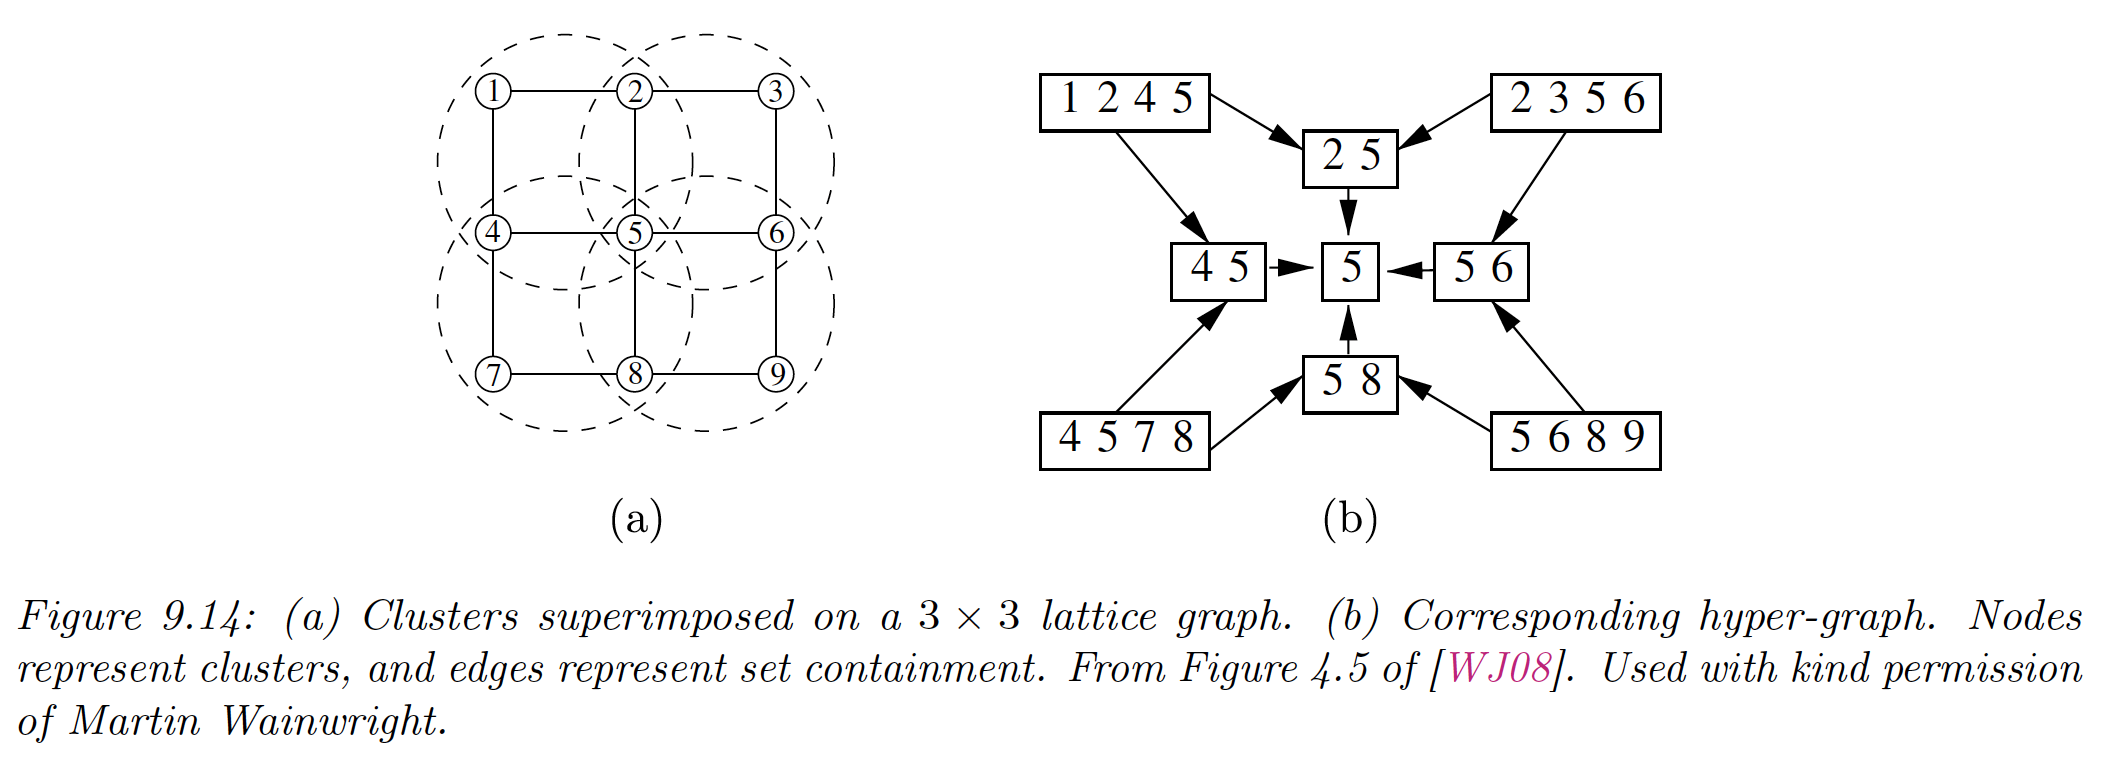
노드들을 Cluster 시켜서 Tight Loop 을 만들어주는게 Cluster Variational Method / Generalized Belief Propagation 이라고 합니다. Cluster 시키면 Hypergraph 가 만들어지며 2개의 Nodes 를 잇는 Edge 가 아닌 2개의 Set of Nodes 를 잇는 Hyper-edges 가 만들어집니다.
9.4.7 Convex BP
보통은 Non-convex 한 BP 를 Convex 한 문제로 바꾸는 것이라고 합니다.
9.4.8 Application: Error Correcting Codes
Error Correcting Codes 는 다른게 아니라 그저 Source Message x∈{0,1}m 을 Noisy 한 Channel 으로 보내서 Noisy Measurements y∈{0,1}m 을 기반으로 x∗=argmaxxp(x∣y)=argmaxxp~(x) 를 구하는 것이 목표인 것입니다.
이때 p~(x) 를 Factor Graph 으로 표현해주는 것이 가능하다고 합니다.
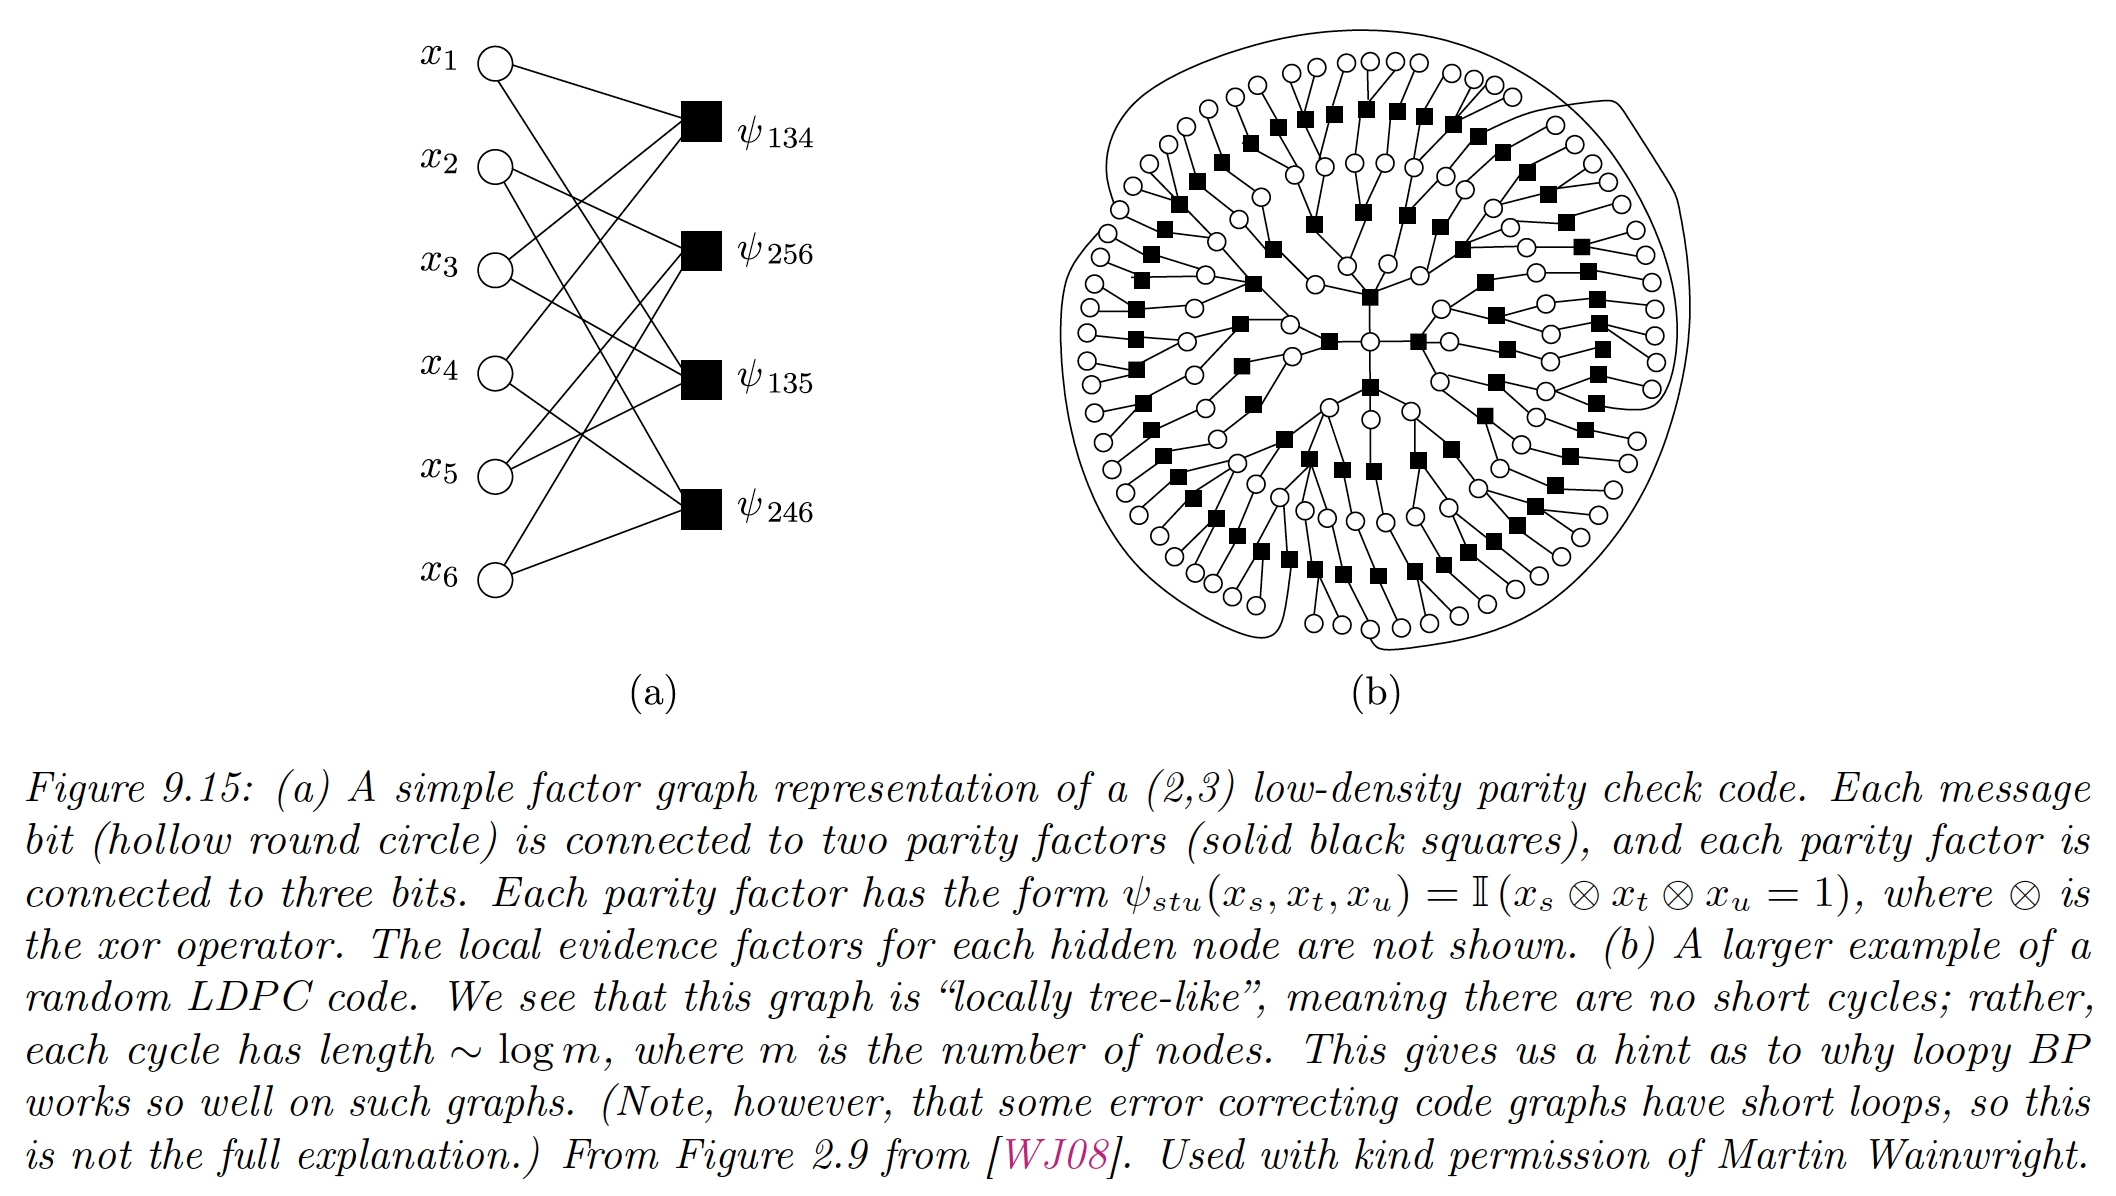
예시를 (2,3) LDPC Code 으로 주었으며, 이는 각각의 Bit (동그라미) 가 2개의 Parity Factor 함수들과 연결되어 있으며, 각각의 Parity Factor (네모) 가 3개의 Bit 와 연결되어 있다고 말합니다.
이때 각각의 Parity Factor 는 다음과 같은 구조를 띈다고 합니다. (⊗:XOR Operator)
ψstu(xs,xt,xu)≜{10 if xs⊗xt⊗xu=1 otherwise
Factor Graph 으로 표현하면 다음 그림과 같이 나오게 됩니다.
이것을 저희가 풀었던 Loopy BP 으로 풀게 된다면 Shannon’s Channel Coding Theorem 의 Lower Bound 에 근접한 결과들이 나오게 됐다고 합니다.
9.4.9 Application: Affinity Propagation
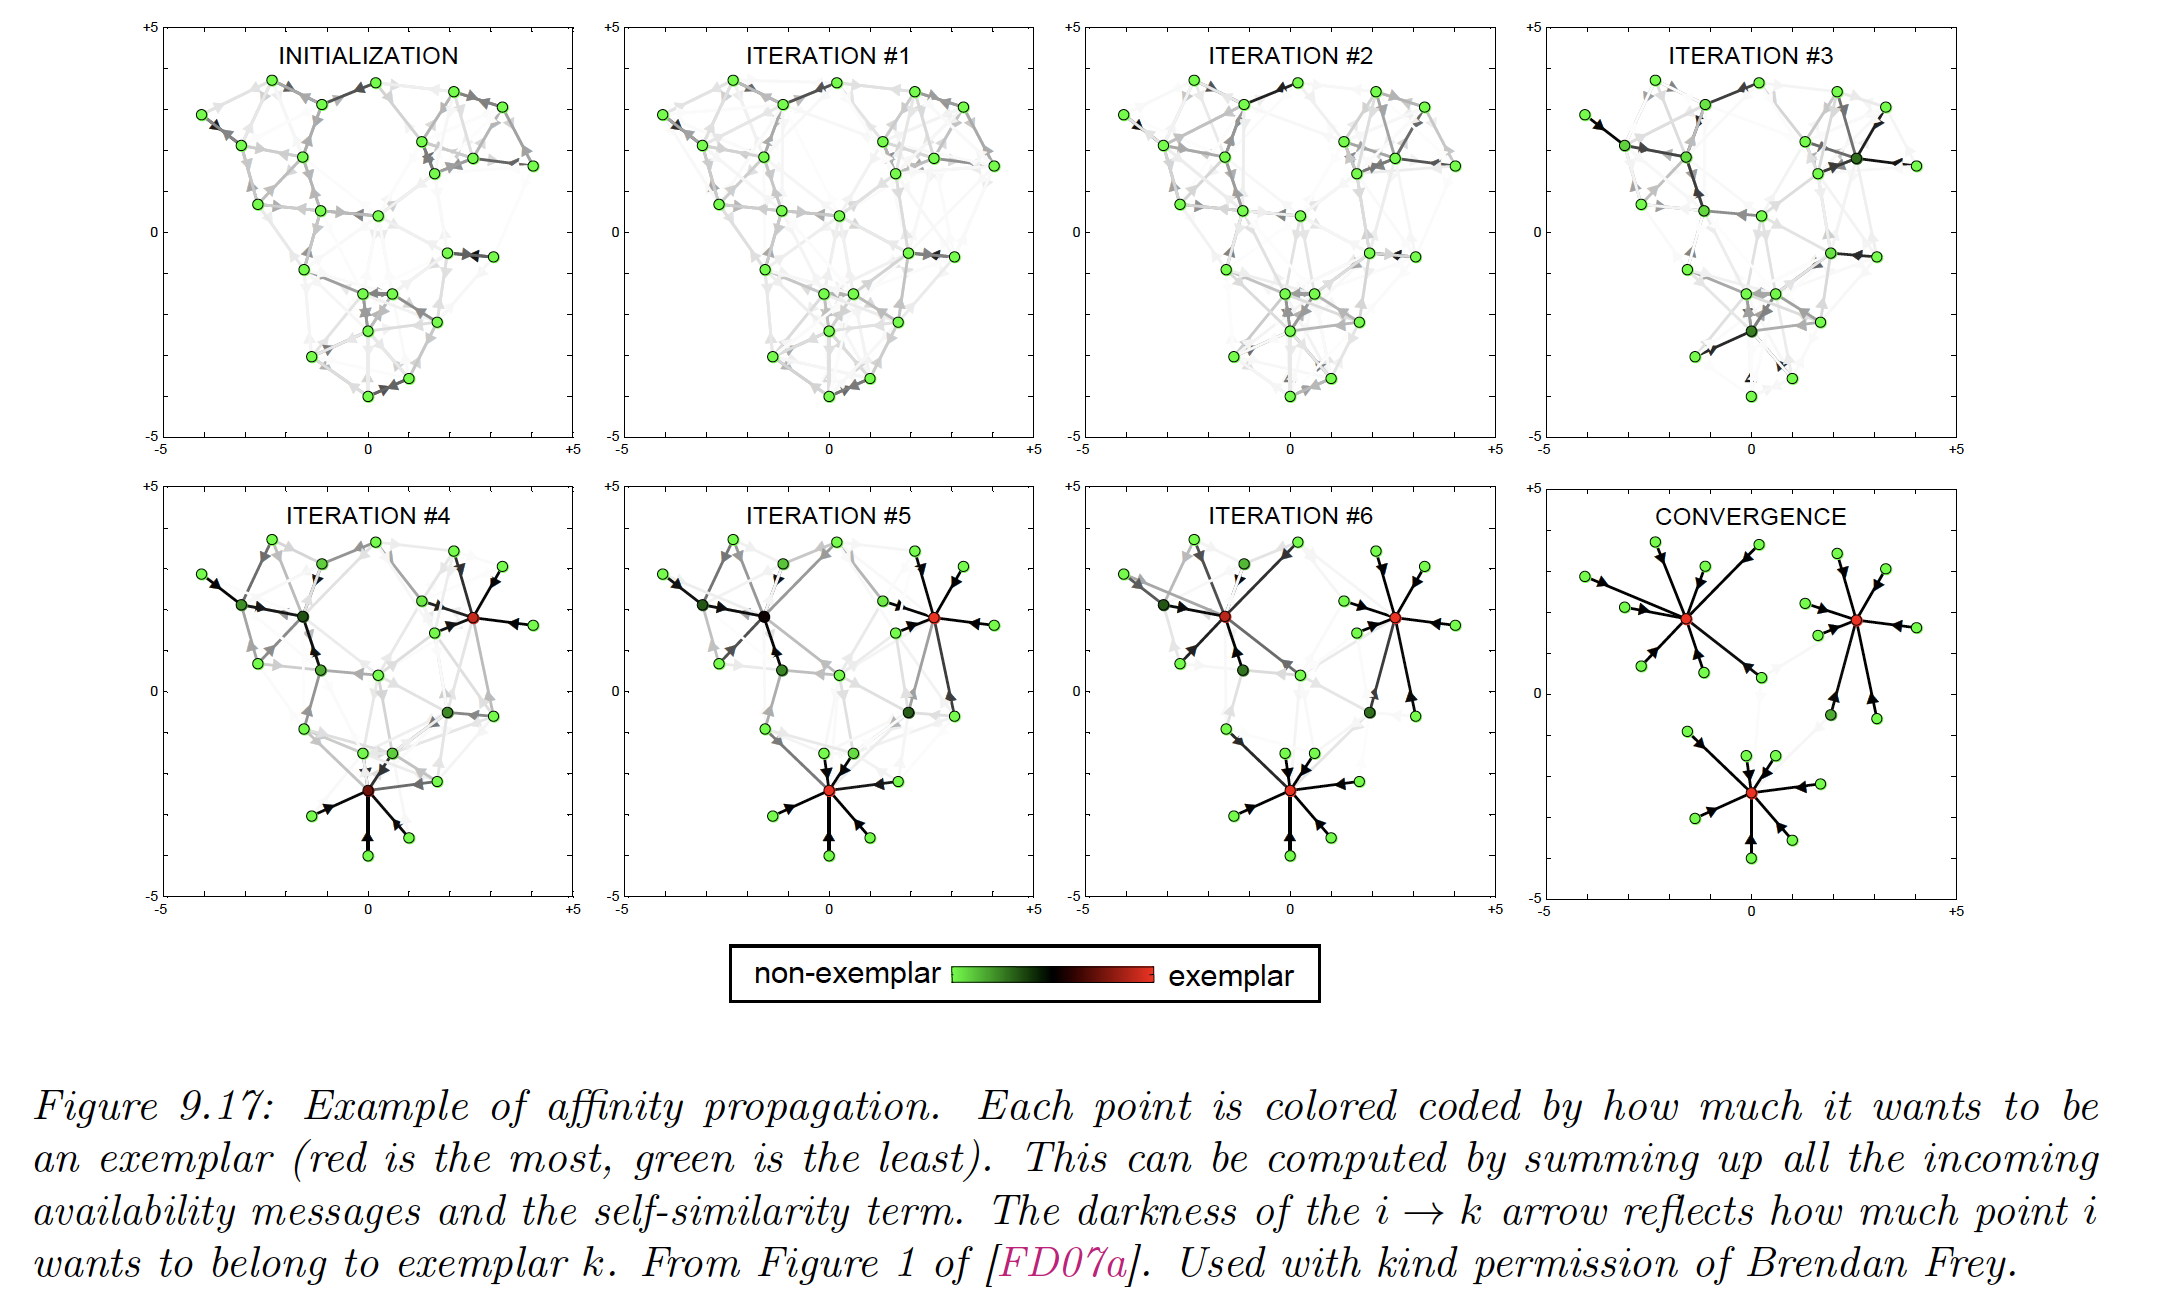
K-medoids Clustering 의 Improvement 이라고 보시면 되며, Pairwise Similarity Matrix 를 Input 으로 받습니다. 목적함수를 다음과 같이 최대화 시키는 것으로 구성합니다.
J(c)=i=1∑NS(i,ci)+k=1∑Nδk(c)
S(i,ci) : Similarity between 데이터 i and Centroid ci
δk(c)={−∞0 if ck=k but ∃i:ci=k otherwise Penalty Term 이며 k 는 본인을 고르지 않았는데 다른 점 i 가 k 를 Centroid 으로 골랐을 경우.
이에 대한 결과는 다음과 같습니다.
9.4.10 Emulating BP with Graph Neural Nets
정말로 제목 이외에 할 얘기가 없어서 넘어가겠습니다.
9.5 The Variable Elimination (VE) Algorithm
여기서부터는 Posterior Marginal p(zQ∣y) 가 아무 Query Set Q 에 대해서 구해지는게 가능한 알고리즘에 대해서 알려줍니다. Cycle 이 있어도 정확한 답을 구하는게 가능하다고 합니다.
p : Graphical Model
All Hidden Nodes are Discrete
9.5.1 Derivation of the Algorithm
저희가 궁금한게 p(J=1) : Marginal Probability a person will get a Job 이며, 다른 알파벳들은 모두 Binary Variable 들이라고 Assume 하겠습니다.
그러면 모든 변수들에 대해서 고려하면 다음과 같은 Joint 가 나옵니다.
p(J)=L∑S∑G∑H∑I∑D∑C∑p(C,D,I,G,S,L,J,H)
근데 이것은 O(27) 만큼 걸리기에 Summation 을 Product 안에다가 넣어주면 완화가 됩니다. 이렇게 하는 것 자체가 사실상 Variable Elimination 의 끝입니다.
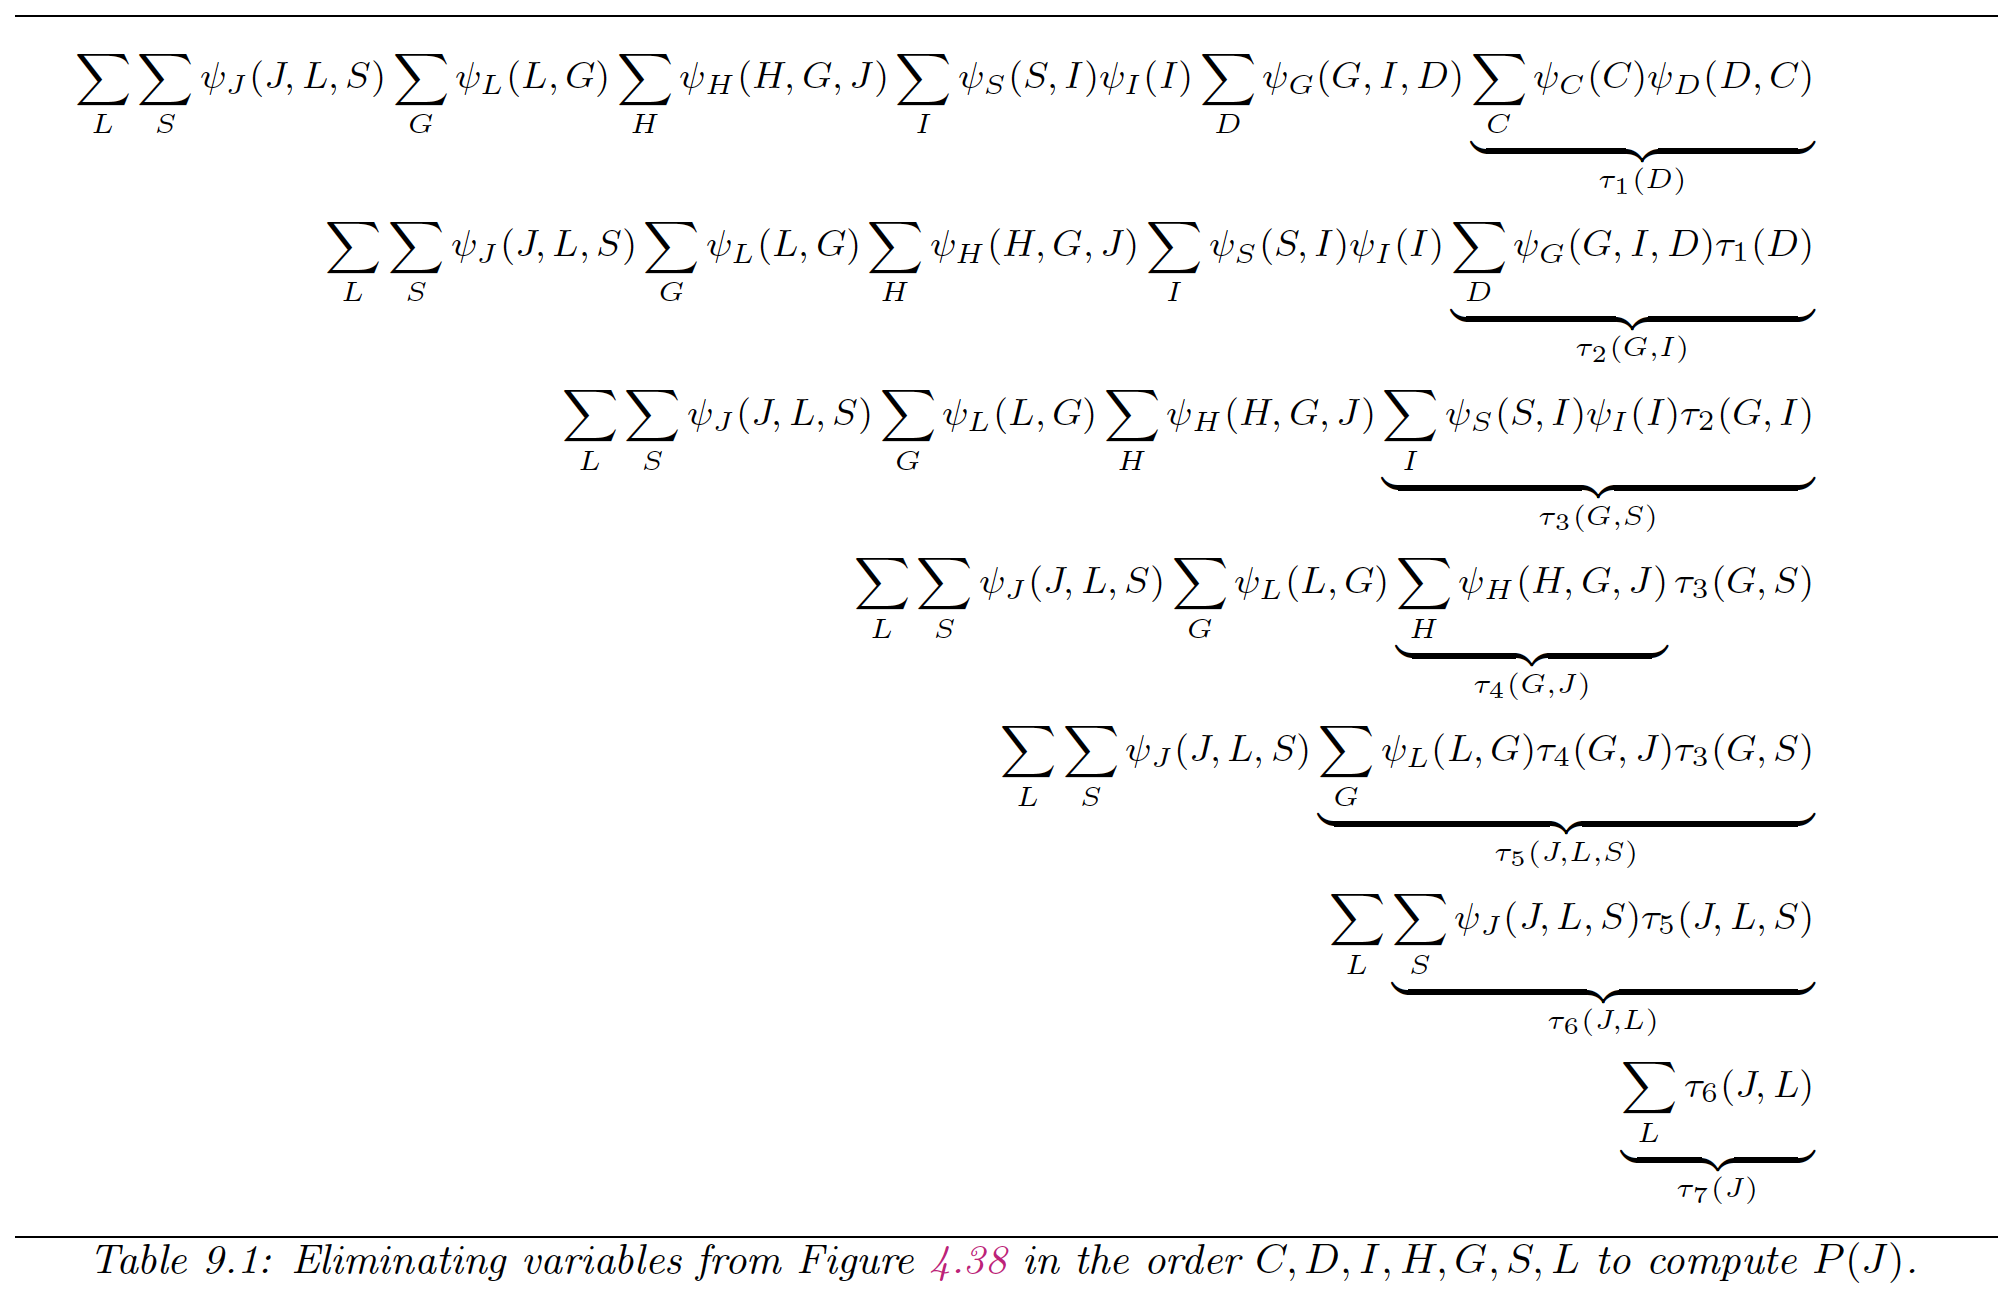
그러면 문제 상황을 조금 더 다루자면, 다음과 같이 전개가 될 수 있습니다 (Dependencies 고려했을 때)
Variable Elimination 은 그러면 그저 이것들을 하나씩 차근차근 다음과 같이 구하는 것이 끝입니다.
9.5.2 Computation Complexity of VE
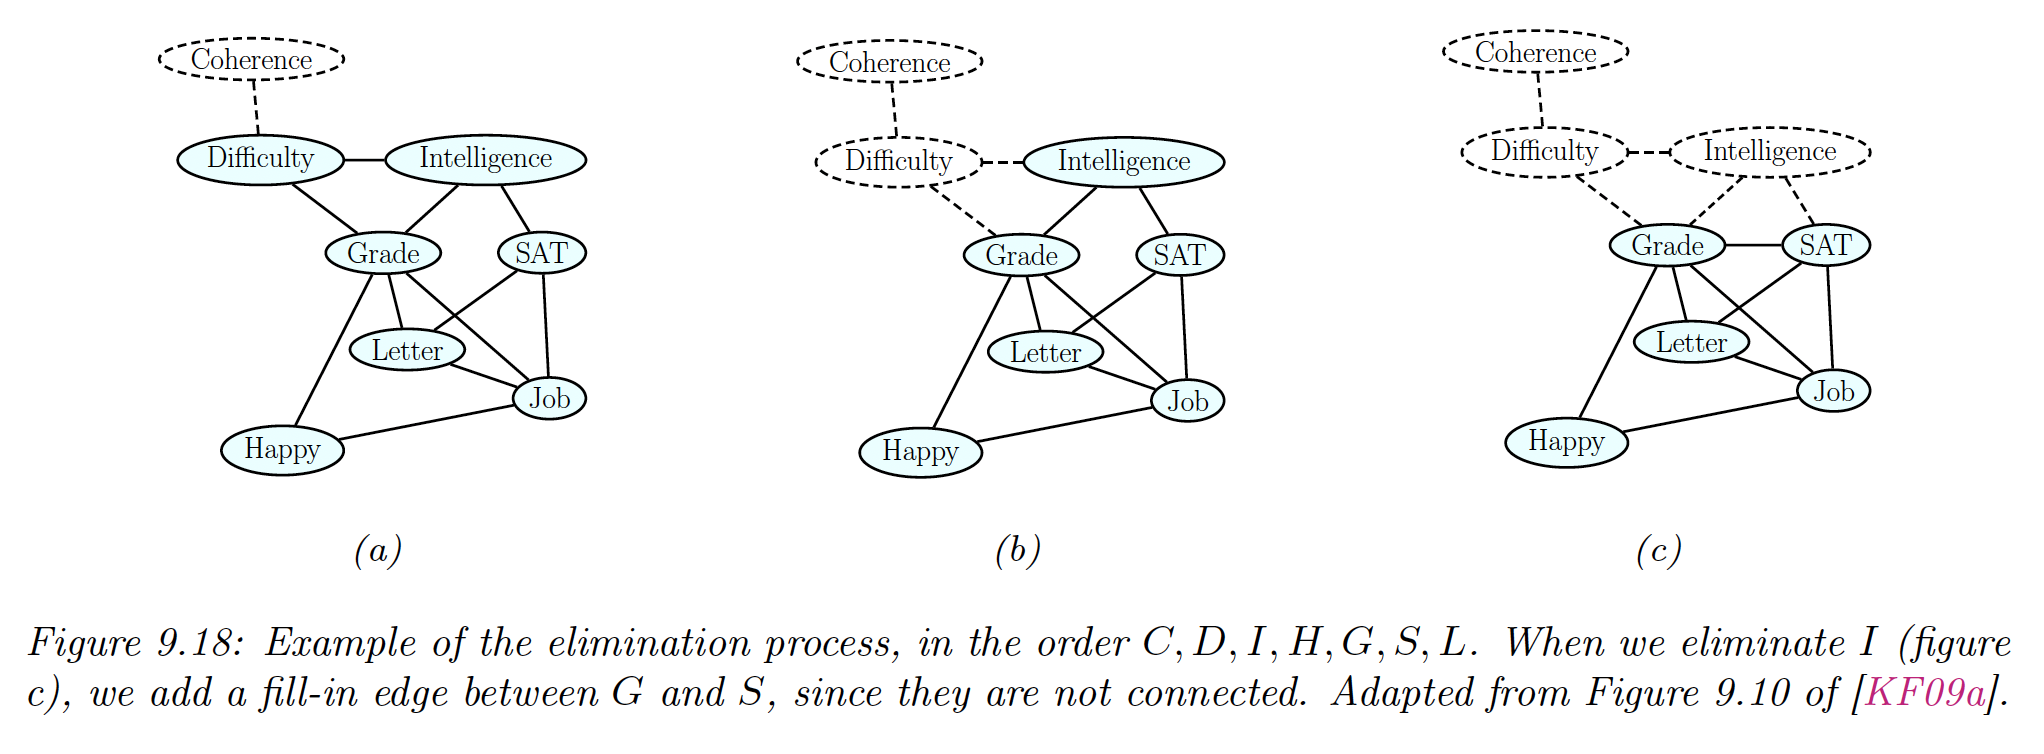
당연하게도 지수적으로 가장 큰 Factor 에 따라서 연산이 많아지며, 이에 대해서 완화하기 위해서는 Elimination 순서를 고려해야 됩니다. 예시로 원래 기존 식에서는 G,I,S 셋다 고려하는 Factor 는 없었지만 3번째 식에서 저희는 G,I,S 에 대해서 곱하기에 새로운 Factor 가 만들어진 모습입니다.
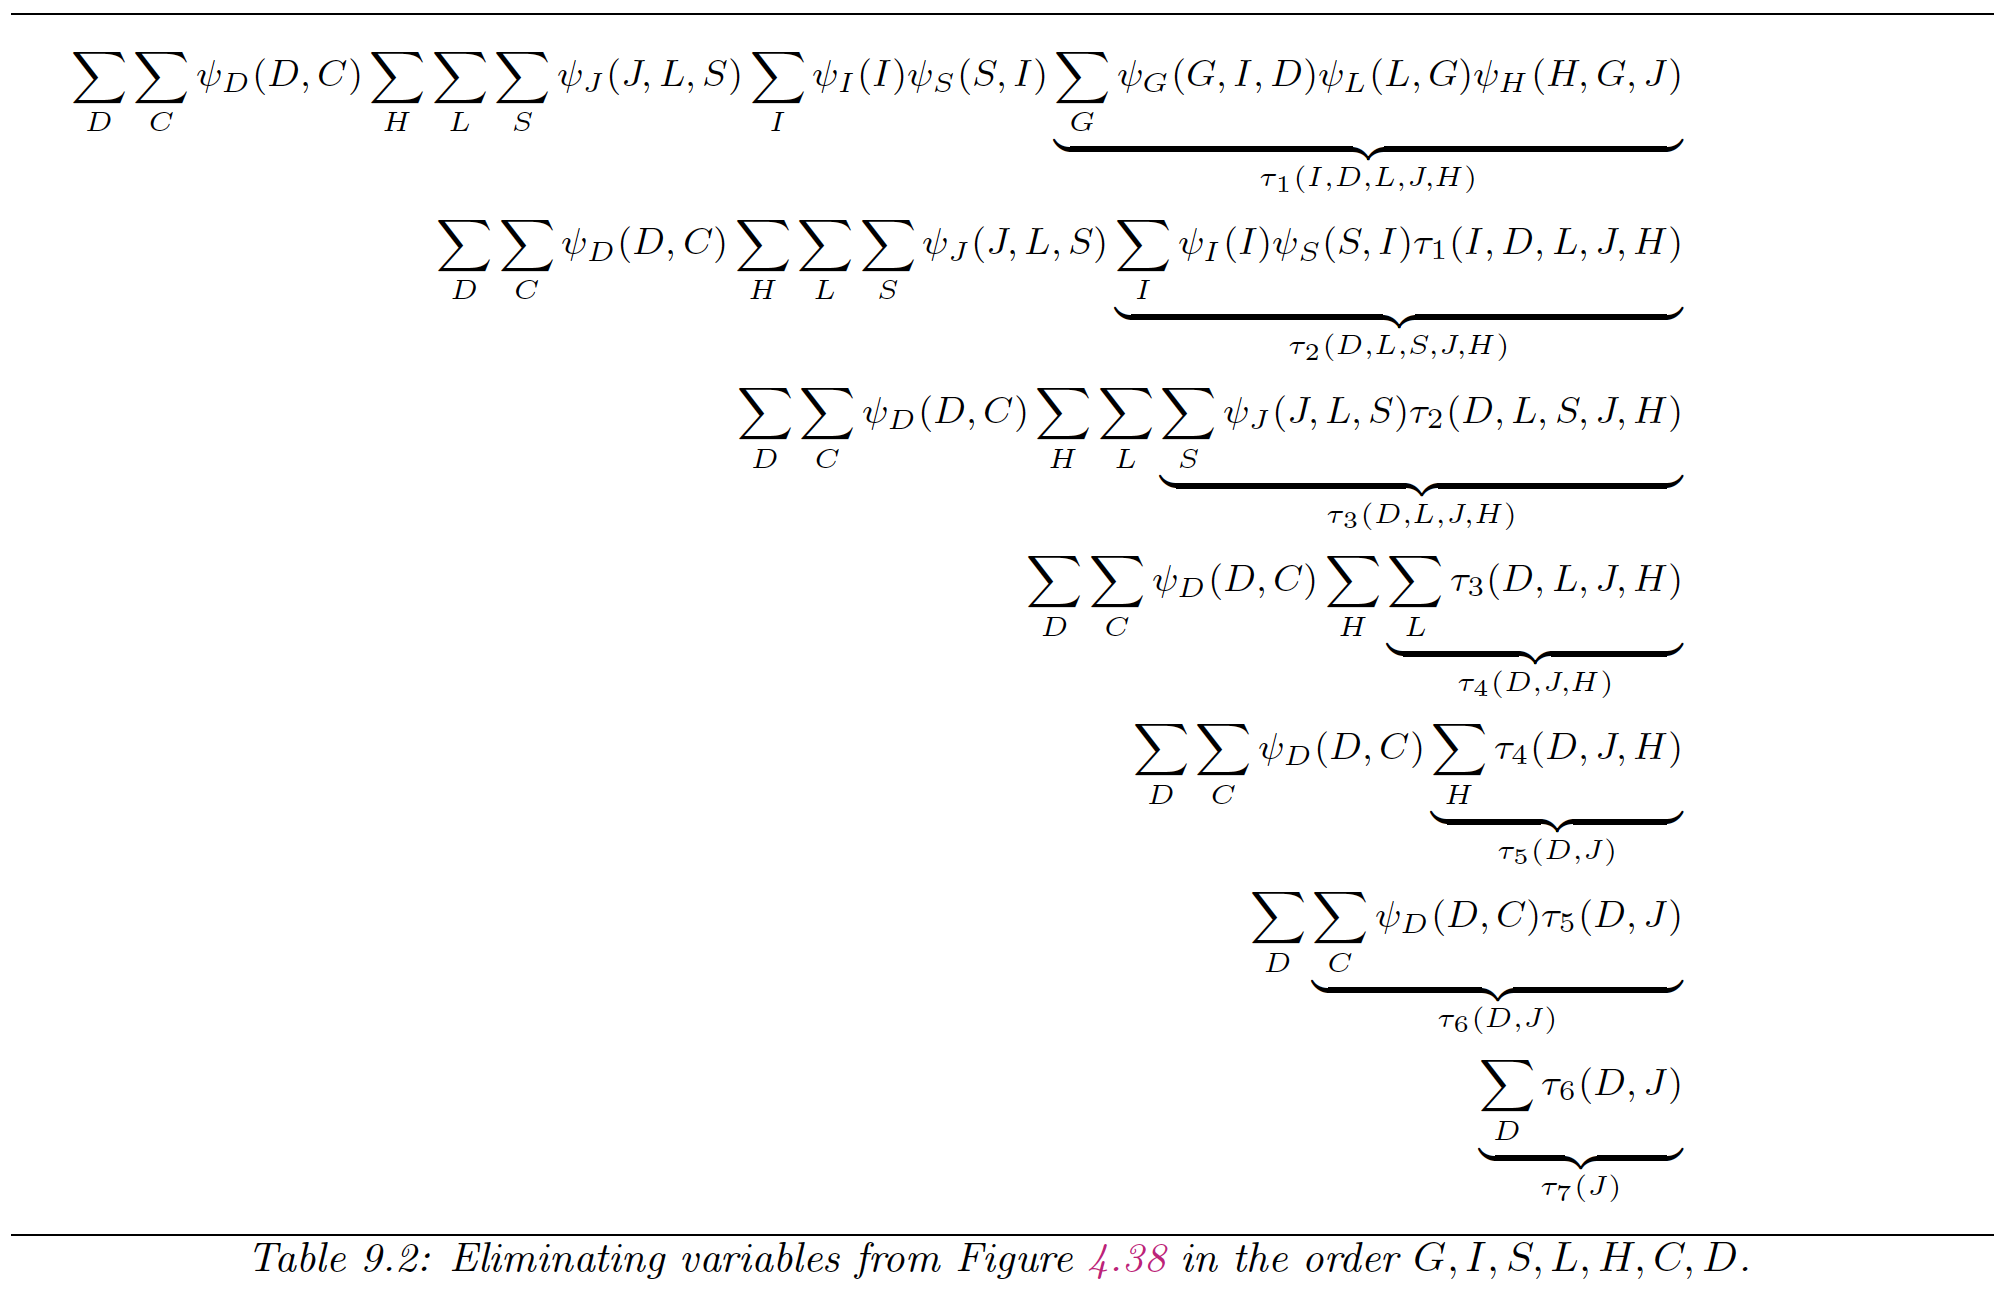
Summation 을 어떤 순서로 진행할지가 바로 Elimination Order 입니다.
아래와 같이 다른 순서로 진행하게 된다면 Eliminate 을 하면서 고려하는 Factor 가 훨씬 줄어든 모습을 볼 수가 있습니다.